
このページの内容
Python 文字列:変換・クリーニング・検索・整形
文字列は、Python で最も頻繁に触れるデータ型です。ユーザー入力、ファイルの内容、Web ページ、CSV の行は、すべてテキストとして届きます。ただし過小評価されがちです。Python の文字列はイミュータブル(不変)であり、どのメソッドもその場で変更せず、すべての操作が新しい文字列を返します。このページでは、DelftStack の文字列ガイド全115本を、行いたい作業ごとに整理しています。軸となるのは四つのタスクライン、すなわち、テキストを他の型へ変換して戻すこと、属さない文字をクリーニングすること、文字列に何が含まれているかを検索してチェックすること、そして出力のためにテキストを整形したり置換したりすることです。
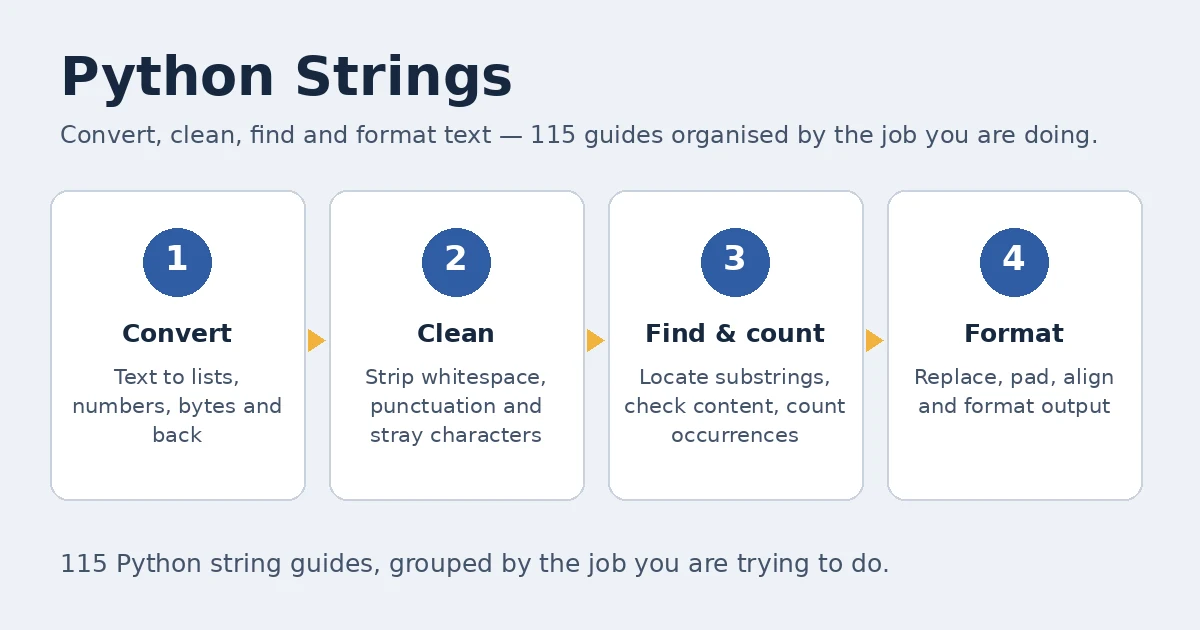
文字列の学習パス
まずは五分で基礎を押さえましょう。文字列がどう作られ、インデックスやスライスでどう読むか、そしてイミュータブルだということが、なぜ常に返り値を保持しなければならないのかを理解します。次に検索とクリーニングを学びます。find()、in 演算子、strip()、replace() で日常のテキスト処理の大部分はまかなえます。続いて変換へ進みます。ここでは文字列がリスト、数値、辞書、バイト列と入れ替わります。最後はフォーマットと置換です。f文字列がデフォルトであり、それ以前のスタイルは今も通用する場面でのみ登場します。以下の各ステップは、このページの各グループに対応し、学ぶ順序に並んでいます。
5分で学ぶ基礎:作成・連結・繰り返し
文字列は、一重引用符または二重引用符で囲まれた文字の並びです。三重引用符を使えば複数行にまたがり、インデックスとスライスで任意の部分を読むことができます。仕事の大部分を担うのは二つの事実です。len() が文字列の長さを測ること、そして、より長い文字列を作ると常に新しい値が生まれることです。
- Python で文字列を N 回繰り返す — 固定回数のコピーは
*で掛け算し、その後、繰り返しとスライスでちょうど目標の長さに合わせ、空の文字列や負の長さを検証します。 - Python で文字列をコピーする — イミュータブルであるため両方の変数が一つの値を共有する理由を説明したうえで、空文字列の連結、フルスライス、
str()、%、format()、f文字列という六つの複製方法を紹介します。 - Python で複数行の文字列を作成する — 本当の複数行テキストには三重引用符を、一つの論理行にはバックスラッシュと括弧による連結を、固定幅の出力には
textwrap.fill()を使います。 - Python で 1つの文字列を別の文字列に追加する —
+とstr.join()の比較です。ピースが多い場合はjoin()が勝ります。+のたびに新しい中間文字列が作られるためです。
変換:文字列とリスト・数値の相互変換
変換こそ、文字列処理が真価を発揮する場面です。データはテキストとして届き、別の何かとして使われます。最も忙しい出入り口はリストで、次が数値です。コンテナは str() や join() で平らになり、バイト列との行き来は明示的なエンコーディングを通してのみ行われます。なお、近隣の話題が一つ別の場所にあります。datetime を文字列に変換する作業は Datetime ガイドの担当です。Python ピラー の Datetime セクションをご覧ください。
- Python で文字列をリストに変換する — 代表的なガイドです。文字単位には
list()、単語やフィールドにはsplit()、リテラルテキストにはast.literal_eval()を使います。信頼できない入力にeval()を使ってはいけません。 - Python でタプルを文字列に変換する —
str()はタプルの構造を保ち、join()は区切りのきれいな結果を返し、要素ごとにstr()を適用するジェネレータは型が混在する場合に対応します。 - Python で辞書を文字列に変換する — 四つの方法を紹介します。手書きのループ、
str()、交換用のjson.dumps()、ネストを読みやすくするpprint.pformat()です。 - Python での tostring() 相当の処理 — Python に
toString()はありません。一つの値にはstr()、多数の値にはjoin()、メッセージには f文字列、独自のクラスには__str__()を使います。 - Python で文字列のリストを整数に変換する — 同じ変換を四通りの方法で示します。内包表記、
map(int, ...)、明示的なループ、そして大規模なデータセット向けの NumPy です。 - Python で Bytearray を文字列に変換する —
bytes()を使うとb'...'という repr が残ってしまう理由と、bytearray.decode()が実際のテキストを返す理由を示します。 - Python で文字列をバイナリに変換する —
ord()によるコードポイントのバイナリと、08bの埋め込みを指定したbytearray()によるエンコード済みバイト列のバイナリを区別します。 - Python で文字列をブール値に変換する — まず落とし穴から始めます。
bool("False")はTrueです。そのうえで、未知の綴りには例外を出す、明示的なトークンパーサーを構築します。
クリーニングと削除:不要な文字を取り除く
クリーニングは、このクラスタの本拠地です。スクレイピングしたページ、エクスポート、ユーザー入力には、招かれざる文字が混じって届きます。汚れの形で選びましょう。既知の部分文字列が一つだけなら replace()、文字の集合をまとめて処理するならテーブルを使った translate()、汚れがリテラルではなくパターンなら正規表現です。
- Python で文字列から xa0 を削除する方法 — 見えないノーブレークスペースに対する二つの攻略法です。
unicodedata.normalize("NFKD", ...)による分解と、replace("\xa0", " ")による直接置換です。 - Python で文字列からコンマを削除する — すべてのコンマには
replace(",", "")を、最初のものだけならcount引数を、パターン処理にはre.sub()を使います。 - Python で文字列から句読点を取り除く方法 — フル装備のツールキットです。
string.punctuationのフィルタ、[^\w\s]の正規表現による置換、maketrans()で作る高速なstr.translate()テーブルを紹介します。 - Python で文字列から引用符を削除する —
replace()はいたるところの引用符を消去します。strip('"')は前後のペアだけを取り除き、内部の引用符には触れません。 - Python で文字列から特殊文字を削除する — まず「特殊」の定義をしてから、
isalnum()フィルタ、translate()の文字集合、ASCII のみの正規表現を適用します。 - Python の文字列から \n を削除する — 改行には
replace()を、行を単一のスペースでつなぎ直すにはsplit()とjoin()を、空白が混在する場合には正規表現を使います。 - Python で文字列から最後の文字を削除する方法 — スライスで処理します。
s[:-1]が最後の文字を落とし、負のインデックスを使えば最後の三文字まで一般化できます。
検索・チェック・カウント
検索は、このクラスタで最も満たされていない需要です。読者は探したい文字が分かっていて、その位置、個数、あるいは有無の答えを必要としています。役割分担をはっきりさせましょう。in は「あるかどうか」に、find() は「最初はどこか」に、index() は「どこか」に答えつつ一致がなければ大きな声で知らせ、count() は「いくつあるか」に答えます。
- Pythonで文字列内の文字の位置を検索する方法 — 最初の一致には
find()、最後の一致にはrfind()、欠如が例外になるべき場合にはindex()、すべてのインデックスにはenumerate()ループを使います。 - Python で文字列内の文字の出現をカウントする — 一文字には
str.count()を、その重ならない部分文字列の数え方のルールも含めて紹介します。すべての文字を数える必要がある場合はcollections.Counterを使います。 - 文字列に Python で単語が含まれているかどうかを確認する — 素朴なテストには
inを使いますが、"is" in "This"が真になることにも注意します。単語全体が重要なら\bの単語境界を使う正規表現が適します。 - Python で変数が文字列かどうかを確認する — デフォルトは
isinstance(value, str)です。サブクラスを見逃す、より厳密なtype()による比較や、try-except を使うバリエーションも紹介します。 - Pythonで文字列を使った if 文を書く方法 —
==、inによるメンバーシップ、大文字小文字を正規化した比較から条件を作ります。isはテキストではなく同一性をテストします。 - Python は文字列内のすべてのオカレンスを検索する — 大まかな合計には境界付きの
count()を、すべてのインデックスを返すにはstartswith()を使った内包表記を使います。
大文字小文字・比較・パディング
大文字小文字は、比較が静かに狂う場所です。Python は Unicode のコードポイントで比較するため、大文字小文字も特殊な文字もすべて影響します。比較の前に正規化しましょう。通常のテキストには lower() や upper() を、Unicode のペアを一致させる必要がある場合は casefold() を使い、体裁を整えるためには ljust()、rjust()、center()、zfill() で埋め込みます。
- Python での大文字小文字を区別しない文字列の比較 — 両側を
lower()またはupper()で正規化し、そのうえで Unicode の観点からcasefold()の意義を示します。これはstraßeとSTRASSEを等しいと判定します。 - Python のスペースで文字列を埋める — フルセットを紹介します。
ljust()、rjust()、埋め込み文字を指定したcenter()、そして整列出力のための%、format()、f文字列による等価な方法です。 - Python で文字列を比較する — 演算子のリファレンスです。等価性には
==と!=、辞書順の比較には<と>を使い、順序は最初の異なるコードポイントで決まります。 - Python で 2つの文字列を文字ごとに比較する —
zip()で文字をペアにし、一致する位置を数え、Noneの入力や異なる長さも明示的に処理します。
フォーマットと置換
新しいコードにおいてフォーマットとは f文字列のことです。値がテンプレートの中、読める場所に置かれ、フォーマット指定子で幅や精度を制御します。str.format() は、テンプレートが別に存在したり再利用されたりする場合に今も適しています。% によるフォーマットは、古いコードの中に生き残っており、これからも出会うことでしょう。置換もイミュータブルの原則に従います。文字列を編集するのではなく、修正済みの新しい文字列を作るのです。
- Python で文字列の文字を置き換える — インデックスによるリスト化と代入、既知の位置の前後でのスライス、すべての一致に対する
replace()。いずれも新しい文字列を返します。 - Python 文字列フォーマットの%s と%d の違い —
%sはstr()変換によりどんな値でも受け入れます。%dは整数を要求し、小数を切り捨てます。驚きの大半の背景にある、昔ながらの区別です。 - Python Sprintf: Python の書式付き文字列 — Python に
sprintf()はありません。その仕事は%演算子、format()、f文字列、あるいは手作りのラッパーに対応します。 - Python のインデックスで文字列の文字を置き換える —
Meatloafの例を、スライスして再構築する方法と、リストのコピーを変更する方法の両方で示し、複数のインデックスにも拡張します。
文字列メソッドマップ
Python には47個の組み込み文字列メソッドが同梱されており、このマップを使えば適切なものを素早く見つけられます。動詞で読みましょう。is* 系はチェックを担い、大文字小文字のメソッドは変換を行い、split と join は分解と再構築を行い、検索系のメソッドは位置を特定します。あるメソッドをより深く扱うガイドがある場合は、三列目からリンクしています。セルが空の場合は、一行の説明で十分だという意味です。
| メソッド | 役割 | 詳しく見る |
|---|---|---|
capitalize() |
最初の文字を大文字にし、残りを小文字にする | 詳しく見る |
casefold() |
大文字小文字を区別しない照合のために作られた、強力な小文字化 | 詳しく見る |
center() |
指定した幅のフィールドの中央に文字列を置く | 詳しく見る |
count() |
部分文字列の、重ならない出現回数を数える | 詳しく見る |
encode() |
選んだエンコーディングで文字列をバイト列にエンコードする | 詳しく見る |
endswith() |
文字列が接尾辞で終わるかどうかをテストする | |
expandtabs() |
タブ文字をスペースに置き換える | |
find() |
部分文字列の最小のインデックス。ない場合は -1 | 詳しく見る |
format() |
{} プレースホルダーに値をフォーマットする | 詳しく見る |
format_map() |
format() と同様だが、値はマッピングから取る | |
index() |
部分文字列の最小のインデックス。ない場合は ValueError を出す | 詳しく見る |
isalnum() |
すべての文字が文字または数字なら True | 詳しく見る |
isalpha() |
すべての文字がアルファベットなら True | |
isascii() |
すべての文字が ASCII なら True | |
isdecimal() |
すべての文字が10進数字なら True | |
isdigit() |
すべての文字が数字なら True | 詳しく見る |
isidentifier() |
文字列が有効な Python 識別子なら True | |
islower() |
大文字小文字の区別がある文字がすべて小文字なら True | |
isnumeric() |
すべての文字が数値なら True | |
isprintable() |
すべての文字が印字可能なら True | |
isspace() |
すべての文字が空白なら True | |
istitle() |
文字列がタイトルケースなら True | |
isupper() |
大文字小文字の区別がある文字がすべて大文字なら True | |
join() |
この文字列を区切り文字として、文字列のイテラブルを連結する | 詳しく見る |
ljust() |
指定した幅のフィールドで左寄せにする | 詳しく見る |
lower() |
小文字にしたコピーを返す | 詳しく見る |
lstrip() |
先行する文字を取り除く(デフォルトは空白) | |
maketrans() |
translate() 用の変換テーブルを作る | 詳しく見る |
partition() |
最初の区切り文字で分割し、3要素のタプルにする | |
removeprefix() |
接頭辞が存在すれば取り除く | |
removesuffix() |
接尾辞が存在すれば取り除く | |
replace() |
部分文字列の出現を別の文字列に置き換える | 詳しく見る |
rfind() |
部分文字列の最大のインデックス。ない場合は -1 | 詳しく見る |
rindex() |
部分文字列の最大のインデックス。ない場合は ValueError を出す | |
rjust() |
指定した幅のフィールドで右寄せにする | 詳しく見る |
rpartition() |
最後の区切り文字で分割し、3要素のタプルにする | |
rsplit() |
区切り文字で、右側から数えて分割する | |
rstrip() |
末尾の文字を取り除く(デフォルトは空白) | |
split() |
区切り文字で分割してリストにする | 詳しく見る |
splitlines() |
行の境界で分割してリストにする | |
startswith() |
文字列が接頭辞で始まるかどうかをテストする | 詳しく見る |
strip() |
先行および末尾の文字を取り除く | 詳しく見る |
swapcase() |
すべての文字の大文字小文字を入れ替えたコピーを返す | |
title() |
各単語の先頭を大文字にした、タイトルケースのコピーを返す | |
translate() |
変換テーブルを通して文字をマッピングする | 詳しく見る |
upper() |
大文字にしたコピーを返す | 詳しく見る |
zfill() |
指定した幅になるよう先行ゼロで埋める | 詳しく見る |
よくある質問
Python で文字列をリストに変換するには?
一つの要素が何であるべきかを決め、合うツールを選びましょう。list(text) は一文字ごとに一要素を与え、text.split() は単語を与え、text.split(",") は区切り文字で区切られたフィールドを与え、空のフィールドも保持します。すでに Python のリストのように見えるテキストは、ast.literal_eval() でパースし、結果が本当にリストかどうかを確認します。制御できない入力に eval() を使ってはいけません。手順の全文は Python で文字列をリストに変換する にあります。
文字列に部分文字列や単語が含まれているかどうかを確認するには?
素朴な部分文字列テストには in 演算子を使います。"word" in text は真理値を返し、大文字小文字を区別します。位置も必要な場合は、find() が最初のインデックスか -1 を返し、index() は代わりに ValueError を出します。in はより大きな単語の内部でも一致することに注意してください。"is" in "This" は真です。そのため、単語全体を対象にする場合は、トークン化するか、\b 境界を使う正規表現を使います。文字列に Python で単語が含まれているかどうかを確認する で示されている通りです。
文字列から句読点や特殊文字を取り除くには?
まず、何を取り除くべきかを定義します。句読点だけか、文字と数字以外はすべてか。句読点については、string.punctuation に対するフィルタ、正規表現 [^\w\s] による置換、maketrans() で作った str.translate() テーブルによる一括削除(最も高速な選択肢)が使えます。より幅広いクリーニングには、isalnum() フィルタが Unicode の文字と数字を保持します。Python で文字列から句読点を取り除く方法 が各バリエーションを解説しています。
Python が「文字列のフォーマット中にすべての引数が変換されたわけではない」と言うのはなぜですか?
この TypeError は % によるフォーマットから生じます。テンプレート内のプレースホルダーの数が、渡した値のタプルより少ないため、引数が余ったままテンプレートの終わりに達するのです。たとえば "Value: " % (1, 2)のような場合です。各値にちょうど一つのプレースホルダーを与え、単一の値は一要素のタプルで包み、リテラルのパーセント記号は%%` としてエスケープしてください。TypeError を解決する: Python での文字列の書式設定中にすべての引数が変換されるわけではありません が、このメッセージをケースごとに解剖しています。
Python に toString() はありますか?
ありません。Python に toString() メソッドは存在しません。それを探すのは Java から持ち越した習慣です。等価なのは組み込みの str(value) で、数値、コレクション、ほとんどのオブジェクトに対して読みやすい文字列を返します。多数の文字列を結合するには join() を、メッセージを組み立てるには f文字列を、表示の制御には独自のクラスに __str__() を定義してください。なお、str() が生成するのは表示用のテキストであり、JSON や CSV ではありません。Python での tostring() 相当の処理 をご覧ください。
特定のインデックスにある一文字を置き換えるには?
文字列への代入はできません。文字列はイミュータブルなため、text[2] = "m" は TypeError を出します。代わりに置換後の文字列を構築します。その位置の前後でスライスする text[:2] + "m" + text[3:] か、リストに変換してインデックスに代入し、"".join(...) で再結合します。どちらも新しい文字列を返し、元の文字列には触れません。インデックスがユーザー入力に由来する場合は、len(text) に対して検証してください。Python のインデックスで文字列の文字を置き換える が両方の方法を示しています。
Python 文字列ガイド全一覧
基礎
- Python で文字列をコピーする
- Python で文字列を N 回繰り返す
- Python で複数行の文字列を作成する
- Python で文字列をループする
- Python で 1つの文字列を別の文字列に追加する
- Python で文字列と整数の値を連結する
- Python で文字列に文字を追加する
- Python で同等の Stringbuilder
- Python で文字列を文字列に挿入する
- Python の String Must Be Indices エラーの修正
変換
- Python で文字列をリストに変換する
- Python でタプルを文字列に変換する
- Python で文字列のリストを整数に変換する
- Python で Bytearray を文字列に変換する
- Python で辞書を文字列に変換する
- Python での tostring() 相当の処理
- Python で文字列を浮動小数点または整数に変換する方法
- Python で浮動小数点数を文字列に変換する方法
- Python で文字列を Unicode に変換する
- Python で文字列をバイナリに変換する
- Python で文字列をブール値に変換する
- Python で整数を文字列に変換する方法
- Python で浮動小数点を文字列にフォーマットする
- Python でリストをカンマ区切りの文字列に変換する
- Python でリストを文字列に変換する方法
- Python で文字列のリストを連結する
- Python で文字列を文字配列に分割する
- Python で文字列をパースしてリストにする
- Python で複数の区切り文字に基づいて文字列を分割する方法
- Python で WhiteSpace によって文字列を分割する
- Python で文字列を半分に分割
- Python で文字列を ASCII 値に変換する
- Python で Unicode 文字を ASCII 文字列に変換する
- Python で文字列をダブルに変換する
- Python で文字列を 10 進数に変換する
- Python 2 および Python 3 でバイトを文字列に変換する方法
- Python で文字列をバイトに変換する方法
- How to Convert Datetime to String in Python
- Python が文字列を日時 datetime に変換する方法
- Python で文字列を変数名に変換する
- How to Stringify JSON in Python
- Python で文字列を浮動小数点値に変換する
- Python で文字列を整数に変換する
クリーニングと削除
- Python で文字列から xa0 を削除する方法
- Python で文字列からコンマを削除する
- Python で文字列から句読点を取り除く方法
- Python で文字列から引用符を削除する
- Python で文字列から特殊文字を削除する
- Python の文字列から \n を削除する
- Python で文字列から最後の文字を削除する方法
- Python で文字列から特定の文字を削除する
- Python で文字列から数字を削除する
- Python で文字列から改行を削除する
- Python で文字列から最初の文字を削除する
- Python で文字列から括弧を削除する
- Python で文字列から部分文字列を削除する方法
- Python 文字列の空白を削除する方法
検索・チェック・カウント
- 文字列に Python で単語が含まれているかどうかを確認する
- Python で変数が文字列かどうかを確認する
- Python で文字列に数値が含まれていることを確認する方法
- Python で文字列が整数かどうかをチェックする
- Pythonで文字列内の文字の位置を検索する方法
- Python で文字列内の文字の出現をカウントする
- Pythonで文字列を使った if 文を書く方法
- Python は文字列内のすべてのオカレンスを検索する
- Python で文字列が数値かどうかを調べる
- Python で文字列に部分文字列が含まれているかどうかを確認する方法
- Python の文字列に単語が存在するかどうかを確認する
- Python 文字列内の文字のすべてのインデックスを検索する
- Python の文字列から部分文字列を抽出する
- Python で文字列から数字を抽出する
- Python で文字列の単語を数える
- Python を使用して文字列の母音を数える
- Python で最も長い共通の部分文字列
- Python のリストで文字列を検索する
- Python でファジー文字列を照合する
- Python リストに文字列が含まれているかどうかを確認する
- Python でファイル内の文字列を検索する
- Pythonic な方法で文字列が空かどうかを確認する方法
大文字小文字・比較・パディング
- Python での大文字小文字を区別しない文字列の比較
- Python のスペースで文字列を埋める
- Python で文字列を比較する
- Python で 2つの文字列を文字ごとに比較する
- Python で文字列をゼロで埋める
- Python での文字列の大文字化
- Python で文字列を右寄せにする
- Python で文字列をアルファベット順に並べ替える
フォーマットと置換
- Python Sprintf: Python の書式付き文字列
- Python で文字列の文字を置き換える
- Python 文字列フォーマットの%s と%d の違い
- Python のインデックスで文字列の文字を置き換える
- Python での文字列補間
- TypeError を解決する: Python での文字列の書式設定中にすべての引数が変換されるわけではありません
- Python で TypeError: Not Enough Arguments for Format String を修正
- TypeError を修正: Python で Object.format に渡される空でないフォーマット文字列
- Python を使用してファイル内の文字列を置き換える
- Python で文字列と変数を出力する
その他の文字列記事
- Python 文字列を暗号化する
- Python で文字列名から関数を呼び出す
- Python で文字列の前に B をつける
- Python の生の文字列
- Python の生の文字列と Unicode 文字列
- Python で文字列を反転させる
- Python での文字列の順列
- Python でファイルを文字列に読み込む
- Python でファイルに文字列を書き込む
- Python を使用して文字列をテキスト ファイルに出力する
- Python ソケットを使用して文字列を送信する
- Python の文字列でバックスラッシュを引用する
- Python で文字列リテラルをスキャンしている間の EOL
- TypeError: str は非文字列を返しましたが、印刷出力を返しました
- Python で Docstring にアクセスする
- Python で最も一般的な Docstring パターン
- Python で 2つの文字列のビット単位の排他的論理和(XOR)を実行する方法
- Python でランダムな文字列を生成する
以上が文字列クラスタの端から端までです。より広い全体像、すなわちリスト、辞書、ファイル、日付、エラーについては、Python ピラー に戻ってください。そこでは、このページが展開する Strings グループと並んで Dictionary グループと List グループが置かれています。