
API · Pandas
Pandas DataFrame DataFrame.to_csv() 함수
Pandas의 DataFrame.to_csv() 함수는 대상 위치를 지정하지 않으면 데이터를 CSV 텍스트로 반환하고, 경로나 쓰기 가능한 텍스트 버퍼를 지정하면 해당 위치에 CSV를 기록한 뒤 None을 반환합니다.
이 페이지의 내용
Python Pandas DataFrame.to_csv()는 DataFrame을 CSV 형식으로 내보냅니다. 대상 위치를 지정하지 않으면 CSV 텍스트를 반환하고, 경로나 쓰기 가능한 텍스트 버퍼를 지정하면 해당 위치에 CSV를 기록한 뒤 None을 반환합니다.
DataFrame.to_csv()가 기록하는 내용
CSV는 구분 기호로 나눈 값의 행을 저장하며, 쉼표를 구분 기호로 사용하는 경우가 흔합니다. 필요하면 헤더 행을 포함할 수 있습니다. 기본적으로 to_csv()는 모든 열을 기록하고 행 인덱스를 첫 번째 필드에 포함합니다. 이 인덱스는 DataFrame의 열과 별개이므로, 기본 순번인 0, 1, 2, ...만 있더라도 결과에 나타납니다. 받는 시스템에 데이터 열만 전달하려면 index=False로 설정하세요.
DataFrame.to_csv()의 구문과 반환값
자주 사용하는 인수는 path_or_buf=None, sep=",", na_rep="", columns=None, header=True, index=True, index_label=None, encoding=None, compression="infer"입니다. 그 밖의 서식 지정 인수에는 float_format, date_format, decimal, quoting, 줄 종결자가 있습니다. 전체 시그니처와 버전별 세부 사항은 링크된 pandas API 참조 문서를 확인하세요.
path_or_buf에는 경로나 쓰기 가능한 텍스트 버퍼를 지정할 수 있습니다. 생략하면 to_csv()는 파일을 만들지 않고 문자열을 반환합니다. 대상 위치를 지정하면 반환값은 None입니다. columns는 내보낼 열과 그 순서를 선택합니다. header를 False로 설정하면 열 이름을 생략할 수 있고, 대체 이름을 지정할 수도 있습니다. index_label은 인덱스 필드의 이름을 지정합니다. na_rep는 누락값을 어떤 문자열로 표시할지 정합니다. 파일에 쓸 때는 encoding이 중요하며, compression으로 압축 출력 형식을 선택할 수 있습니다. 숫자와 날짜 서식 옵션은 값을 표시하는 방식을 조정하고, 인용 옵션은 구분 기호·따옴표·줄바꿈이 포함된 필드를 처리합니다.
DataFrame을 CSV 문자열이나 파일로 쓰기
다음 전체 예제에서는 기본 CSV 문자열을 확인하고, 같은 프레임을 임시 파일에 기록하며, 열을 선택해 이름을 바꾸고 구분 기호도 변경합니다. 출력 문자열에는 끝의 줄바꿈이 포함되어 있어 각 제목이 별도의 줄에서 시작합니다.
예제를 실행해 보세요.
이 섹션의 코드와 표시되는 레이블 또는 출력은 영어로 유지됩니다.
import tempfile
import sys
from pathlib import Path

import pandas as pd

frame = pd.DataFrame(
    {
        "Attendance": [60, 100, 80, 78, 95],
        "Name": ["Olivia", "John", "Laura", "Ben", "Kevin"],
        "Obtained Marks": [90, 75, 82, 64, 45],
    }
)

print("CSV text:")
sys.stdout.write(frame.to_csv())

with tempfile.TemporaryDirectory() as directory:
    destination = Path(directory) / "students.csv"
    print("File write returns:", frame.to_csv(destination))

print("Selected columns:")
sys.stdout.write(
    frame.to_csv(columns=["Name", "Obtained Marks"], header=["Full Name", "Marks"])
)

print("Semicolon separator:")
sys.stdout.write(frame.to_csv(columns=["Name", "Obtained Marks"], sep=";"))
CSV text:
,Attendance,Name,Obtained Marks
0,60,Olivia,90
1,100,John,75
2,80,Laura,82
3,78,Ben,64
4,95,Kevin,45
File write returns: None
Selected columns:
,Full Name,Marks
0,Olivia,90
1,John,75
2,Laura,82
3,Ben,64
4,Kevin,45
Semicolon separator:
;Name;Obtained Marks
0;Olivia;90
1;John;75
2;Laura;82
3;Ben;64
4;Kevin;45
students.csv처럼 상대 파일 이름을 지정하면 Python은 스크립트가 있는 디렉터리가 아니라 프로세스의 현재 작업 디렉터리를 기준으로 경로를 해석합니다. 저장 위치를 예측할 수 있어야 한다면 명시적인 경로를 사용하세요. 파일 기록 예제가 끝나면 임시 디렉터리는 삭제됩니다.
CSV에서 열, 헤더, 인덱스 선택하기
columns를 사용하면 내보낼 필드와 그 순서를 함께 선택할 수 있습니다. 예제에서는 내보낸 Name 및 Obtained Marks 열의 이름을 Full Name과 Marks로 바꾸며, 원본 DataFrame의 열 이름은 그대로 유지됩니다. 위의 선택 가능한 출력에서는 이름이 없는 인덱스 필드가 첫 번째 항목으로 나타납니다. 인덱스를 제외하려면 index=False로 설정하고, 인덱스에 명확한 헤더가 필요하면 index_label을 지정하세요.
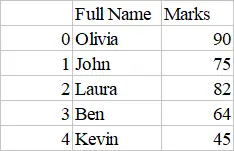
내보낸 Name 및 Obtained Marks 열은 Full Name과 Marks라는 이름으로 표시됩니다. 이 표는 위의 선택 가능한 CSV 출력을 보완합니다.
구분 기호와 그 밖의 CSV 출력 옵션 사용자 지정하기
받는 애플리케이션이 요구하는 구분 기호에 맞춰 sep를 설정하세요. 예제에서는 세미콜론을 사용하며, 인덱스가 포함되어 있으므로 첫 번째 데이터 열 앞에도 구분 기호가 나타납니다. 첫 번째 인덱스 필드가 필요하지 않다면 index=False로 설정하세요.
누락값을 나타내려면 na_rep에 "NA" 같은 표식을 지정하세요. 받는 시스템이 특정 숫자 표현을 요구하면 float_format 또는 decimal을 사용하세요. 파일에 쓸 때는 encoding을 지정할 수 있으며, compression을 사용하면 파일 이름에서 압축 형식을 추론하거나 형식을 직접 선택해 gzip 같은 압축 파일을 만들 수 있습니다. 인용 옵션은 구분 기호나 줄바꿈이 포함된 값을 보존하는 데 도움이 됩니다. CSV를 읽을 프로그램이 기대하는 형식에 맞춰 옵션을 선택하세요.