
API · Pandas
Funzione Pandas DataFrame DataFrame.to_csv()
DataFrame.to_csv() restituisce il testo CSV se non viene specificata una destinazione; con un percorso o un buffer di testo scrivibile, scrive il CSV e restituisce None.
In questa pagina
Python Pandas DataFrame.to_csv() esporta un DataFrame in formato CSV. Se non si specifica una destinazione, restituisce il testo CSV; se si indica un percorso o un buffer di testo scrivibile, vi scrive il CSV e restituisce None.
Cosa scrive DataFrame.to_csv()
Il formato CSV memorizza righe di valori separate da un delimitatore, spesso una virgola, con una riga di intestazione facoltativa. Per impostazione predefinita, to_csv() scrive tutte le colonne e include l’indice delle righe come primo campo. L’indice è distinto dalle colonne del DataFrame, quindi compare anche quando consiste soltanto nella sequenza predefinita 0, 1, 2, .... Imposta index=False se il sistema destinatario deve ricevere solo le colonne dei dati.
Sintassi e valore restituito di DataFrame.to_csv()
Tra gli argomenti usati più spesso dal metodo ci sono path_or_buf=None, sep=",", na_rep="", columns=None, header=True, index=True, index_label=None, encoding=None e compression="infer". Altre opzioni di formattazione includono float_format, date_format, decimal, quoting e il terminatore di riga. Consulta il riferimento API di pandas collegato per la firma completa e i dettagli specifici delle diverse versioni.
path_or_buf può essere un percorso o un buffer di testo scrivibile. Se viene omesso, to_csv() restituisce una stringa e non crea alcun file. Se si specifica una destinazione, il valore restituito è None. columns seleziona e ordina le colonne esportate. Con header si possono omettere i nomi delle colonne impostando False oppure specificare nomi sostitutivi; index_label assegna un nome al campo dell’indice. na_rep determina come rappresentare i valori mancanti. encoding è rilevante quando si scrive testo in un file, mentre la compressione consente di scegliere un formato di output compresso. Le opzioni di formattazione numerica e delle date controllano la rappresentazione dei valori; quelle di quoting regolano i campi che contengono delimitatori, virgolette o interruzioni di riga.
Scrivere un DataFrame in una stringa CSV o in un file
L’esempio completo seguente mostra la stringa CSV predefinita, scrive lo stesso frame in un file temporaneo, seleziona e rinomina le colonne e cambia il separatore. Le stringhe stampate mantengono il carattere di nuova riga finale, quindi ogni intestazione inizia su una riga distinta.
Esegui questo esempio. Le etichette stampate e i testi visibili nel codice e nell’output restano in inglese.
import tempfile
import sys
from pathlib import Path

import pandas as pd

frame = pd.DataFrame(
    {
        "Attendance": [60, 100, 80, 78, 95],
        "Name": ["Olivia", "John", "Laura", "Ben", "Kevin"],
        "Obtained Marks": [90, 75, 82, 64, 45],
    }
)

print("CSV text:")
sys.stdout.write(frame.to_csv())

with tempfile.TemporaryDirectory() as directory:
    destination = Path(directory) / "students.csv"
    print("File write returns:", frame.to_csv(destination))

print("Selected columns:")
sys.stdout.write(
    frame.to_csv(columns=["Name", "Obtained Marks"], header=["Full Name", "Marks"])
)

print("Semicolon separator:")
sys.stdout.write(frame.to_csv(columns=["Name", "Obtained Marks"], sep=";"))
CSV text:
,Attendance,Name,Obtained Marks
0,60,Olivia,90
1,100,John,75
2,80,Laura,82
3,78,Ben,64
4,95,Kevin,45
File write returns: None
Selected columns:
,Full Name,Marks
0,Olivia,90
1,John,75
2,Laura,82
3,Ben,64
4,Kevin,45
Semicolon separator:
;Name;Obtained Marks
0;Olivia;90
1;John;75
2;Laura;82
3;Ben;64
4;Kevin;45
Se passi un nome di file relativo, per esempio students.csv, Python lo risolve a partire dalla directory di lavoro corrente del processo, che potrebbe essere diversa dalla directory che contiene lo script. Usa un percorso esplicito quando vuoi che la destinazione sia prevedibile. La directory temporanea dell’esempio viene eliminata al termine della dimostrazione della scrittura su file.
Scegliere colonne, intestazioni e indice nel CSV
Usa columns per scegliere sia i campi da esportare sia il loro ordine. Nell’esempio, le colonne esportate Name e Obtained Marks vengono rinominate rispettivamente Full Name e Marks; i nomi delle colonne originali del DataFrame non cambiano. L’output selezionabile qui sopra mostra l’indice come primo campo, senza intestazione. Imposta index=False per ometterlo oppure specifica index_label se vuoi assegnare all’indice un’intestazione chiara.
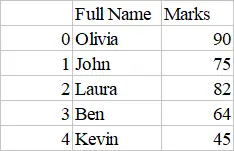
Le colonne esportate Name e Obtained Marks sono etichettate Full Name e Marks. La tabella affianca l’output CSV selezionabile qui sopra.
Personalizzare il separatore e altre opzioni di output CSV
Imposta sep sul delimitatore previsto dall’applicazione destinataria. L’esempio usa il punto e virgola; nell’output si vede il separatore tra i campi, anche prima della prima colonna di dati, perché è incluso l’indice. Imposta index=False se non vuoi quel campo iniziale.
Per rappresentare i valori mancanti, imposta na_rep su un indicatore come "NA"; usa float_format o decimal se il sistema destinatario richiede una rappresentazione numerica specifica. encoding è utile quando la destinazione è un file, mentre compression può produrre formati come gzip, se selezionato o dedotto dal nome del file. Le opzioni di quoting aiutano a preservare i valori che contengono delimitatori o interruzioni di riga. Scegli le opzioni in base al formato previsto dal programma che leggerà il CSV.