
API · Pandas
Pandas DataFrame DataFrame.to_csv() 関数
Pandas の DataFrame.to_csv() 関数は、出力先を指定しない場合は CSV テキストを返し、パスまたは書き込み可能なテキストバッファーを指定すると、そこへ CSV を書き込んで None を返します。
このページの内容
Python Pandas の DataFrame.to_csv() は、DataFrame を CSV として出力します。出力先を指定しない場合は CSV テキストを返し、パスまたは書き込み可能なテキストバッファーを指定すると、そこへ CSV を書き込んで None を返します。
DataFrame.to_csv() が出力する内容
CSV は、一般にカンマなどの区切り文字で値を分け、必要に応じてヘッダー行を付けて、行単位で保存する形式です。既定では、to_csv() はすべての列を書き出し、行インデックスを先頭のフィールドに含めます。このインデックスは DataFrame の列とは別のもので、既定の連番 0, 1, 2, ... であっても出力されます。受け取り側のシステムにデータ列だけを渡すには、index=False を指定します。
DataFrame.to_csv() の構文と戻り値
よく使われる引数には、path_or_buf=None、sep=","、na_rep=""、columns=None、header=True、index=True、index_label=None、encoding=None、compression="infer" があります。ほかの書式設定用引数には、float_format、date_format、decimal、quoting、行終端を指定するものがあります。完全なシグネチャやバージョンごとの詳細は、リンク先の pandas API リファレンスを参照してください。
path_or_buf にはパスまたは書き込み可能なテキストバッファーを指定できます。省略すると、to_csv() は文字列を返し、ファイルは作成しません。出力先を指定した場合の戻り値は None です。columns は出力する列とその順序を選びます。header に False を指定すると列名を省略でき、置き換える名前を指定することもできます。index_label はインデックスのフィールド名を指定します。na_rep は欠損値の表現を制御します。encoding はファイルへの書き込み時に関係し、圧縮を指定すると圧縮形式で出力できます。数値や日付の書式設定引数は値の表現を制御し、引用符の設定は区切り文字、引用符、改行を含むフィールドの扱いを制御します。
DataFrame を CSV 文字列またはファイルに書き込む
次の一連の例では、既定の CSV 文字列を表示し、同じフレームを一時ファイルに書き込み、列を選択して名前を変更し、区切り文字を変更します。表示される文字列には末尾の改行が含まれるため、各見出しはそれぞれ別の行に表示されます。
次の例を実行してください。コードと出力ブロックはバイト単位で一致させる必要があるため、そこに表示されるラベルは英語のままです。
import tempfile
import sys
from pathlib import Path

import pandas as pd

frame = pd.DataFrame(
    {
        "Attendance": [60, 100, 80, 78, 95],
        "Name": ["Olivia", "John", "Laura", "Ben", "Kevin"],
        "Obtained Marks": [90, 75, 82, 64, 45],
    }
)

print("CSV text:")
sys.stdout.write(frame.to_csv())

with tempfile.TemporaryDirectory() as directory:
    destination = Path(directory) / "students.csv"
    print("File write returns:", frame.to_csv(destination))

print("Selected columns:")
sys.stdout.write(
    frame.to_csv(columns=["Name", "Obtained Marks"], header=["Full Name", "Marks"])
)

print("Semicolon separator:")
sys.stdout.write(frame.to_csv(columns=["Name", "Obtained Marks"], sep=";"))
CSV text:
,Attendance,Name,Obtained Marks
0,60,Olivia,90
1,100,John,75
2,80,Laura,82
3,78,Ben,64
4,95,Kevin,45
File write returns: None
Selected columns:
,Full Name,Marks
0,Olivia,90
1,John,75
2,Laura,82
3,Ben,64
4,Kevin,45
Semicolon separator:
;Name;Obtained Marks
0;Olivia;90
1;John;75
2;Laura;82
3;Ben;64
4;Kevin;45
相対ファイル名(たとえば students.csv)を渡すと、Python はプロセスの現在の作業ディレクトリを基準にパスを解決します。このディレクトリは、スクリプトが置かれているディレクトリと異なる場合があります。保存先を明確にしたい場合は、明示的なパスを指定してください。この例では、ファイルへの書き込みの実演後に一時ディレクトリを削除します。
CSV の列、ヘッダー、インデックスを選ぶ
columns を使うと、出力するフィールドとその順序を選べます。この例では、出力する Name 列と Obtained Marks 列に、それぞれ Full Name と Marks という名前を付けています。元の DataFrame の列名は変更されません。上の選択可能な出力では、インデックスが名前のない先頭フィールドとして表示されています。インデックスを省略するには index=False を指定し、インデックスに見出しを付けるには index_label を指定します。
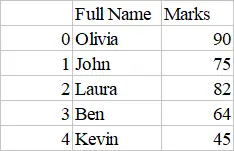
出力された Name 列と Obtained Marks 列には、それぞれ Full Name と Marks という見出しが付いています。この表は、上の選択可能な CSV 出力を補足しています。
区切り文字などの CSV 出力オプションを設定する
受け取り側のアプリケーションが想定する区切り文字を sep に指定します。この例ではセミコロンを使っています。インデックスを含めているため、出力では先頭のデータ列の前にもセミコロンが表示されます。先頭のインデックスフィールドが不要な場合は index=False を指定します。
欠損値には、na_rep に "NA" などの値を指定できます。受け取り側のシステムで特定の数値表現が必要な場合は、float_format または decimal を使います。ファイルへの出力では encoding が役立ちます。また、compression を指定するか、ファイル名から形式を推測できる場合は、gzip などの形式で圧縮できます。引用符のオプションは、区切り文字や改行を含む値を正しく保持するのに役立ちます。CSV を読み込むプログラムが想定する形式に合わせて、各オプションを選んでください。