
API · Pandas
Fonction Pandas DataFrame DataFrame.to_csv()
Sans destination, `DataFrame.to_csv()` renvoie le texte CSV ; avec un chemin ou un tampon texte inscriptible, la méthode y écrit le CSV et renvoie `None`.
Sur cette page
Python Pandas DataFrame.to_csv() permet d’exporter un DataFrame au format CSV. Sans destination, la méthode renvoie le texte CSV ; avec un chemin ou un tampon texte inscriptible, elle y écrit le CSV et renvoie None.
Ce qu’écrit DataFrame.to_csv()
Le format CSV stocke des lignes de valeurs séparées par un délimiteur, généralement une virgule, avec éventuellement une ligne d’en-tête. Par défaut, to_csv() écrit toutes les colonnes et ajoute l’index des lignes comme premier champ. Cet index est distinct des colonnes du DataFrame ; il apparaît donc même s’il ne contient que la séquence par défaut 0, 1, 2, .... Définissez index=False si le système destinataire ne doit recevoir que les colonnes de données.
Syntaxe et valeur de retour de DataFrame.to_csv()
Parmi les arguments couramment utilisés figurent path_or_buf=None, sep=",", na_rep="", columns=None, header=True, index=True, index_label=None, encoding=None et compression="infer". Les autres arguments de mise en forme comprennent float_format, date_format, decimal, quoting et le terminateur de ligne. Consultez la référence de l’API pandas indiquée dans le lien pour obtenir la signature complète et les détails propres à chaque version.
path_or_buf peut être un chemin ou un tampon texte inscriptible. Si cet argument est omis, to_csv() renvoie une chaîne ; aucun fichier n’est créé. Lorsqu’une destination est fournie, la valeur de retour est None. columns sélectionne les colonnes à exporter et en définit l’ordre. header permet de supprimer les noms de colonnes avec False ou de les remplacer ; index_label attribue un nom au champ de l’index. na_rep détermine comment représenter les valeurs manquantes. encoding est utile lors de l’écriture dans un fichier, tandis que la compression permet de choisir un format de sortie compressé. Les options de format numérique et de date déterminent la représentation des valeurs ; les options de citation régissent les champs contenant des délimiteurs, des guillemets ou des retours à la ligne.
Écrire un DataFrame dans une chaîne CSV ou un fichier
L’exemple complet ci-dessous montre la chaîne CSV par défaut, écrit le même objet dans un fichier temporaire, sélectionne et renomme des colonnes, puis modifie le séparateur. Les chaînes affichées conservent leur retour à la ligne final : chaque en-tête commence donc sur sa propre ligne. Les libellés visibles dans le code et sa sortie restent en anglais, car ces blocs sont conservés à l’identique.
Exécutez cet exemple :
import tempfile
import sys
from pathlib import Path

import pandas as pd

frame = pd.DataFrame(
    {
        "Attendance": [60, 100, 80, 78, 95],
        "Name": ["Olivia", "John", "Laura", "Ben", "Kevin"],
        "Obtained Marks": [90, 75, 82, 64, 45],
    }
)

print("CSV text:")
sys.stdout.write(frame.to_csv())

with tempfile.TemporaryDirectory() as directory:
    destination = Path(directory) / "students.csv"
    print("File write returns:", frame.to_csv(destination))

print("Selected columns:")
sys.stdout.write(
    frame.to_csv(columns=["Name", "Obtained Marks"], header=["Full Name", "Marks"])
)

print("Semicolon separator:")
sys.stdout.write(frame.to_csv(columns=["Name", "Obtained Marks"], sep=";"))
CSV text:
,Attendance,Name,Obtained Marks
0,60,Olivia,90
1,100,John,75
2,80,Laura,82
3,78,Ben,64
4,95,Kevin,45
File write returns: None
Selected columns:
,Full Name,Marks
0,Olivia,90
1,John,75
2,Laura,82
3,Ben,64
4,Kevin,45
Semicolon separator:
;Name;Obtained Marks
0;Olivia;90
1;John;75
2;Laura;82
3;Ben;64
4;Kevin;45
Si vous indiquez un nom de fichier relatif, comme students.csv, Python le résout à partir du répertoire de travail actuel du processus, qui peut différer du répertoire contenant votre script. Utilisez un chemin explicite si vous avez besoin d’une destination prévisible. Le répertoire temporaire de l’exemple est supprimé après la démonstration de l’écriture dans un fichier.
Choisir les colonnes, les en-têtes et l’index du CSV
Utilisez columns pour choisir les champs à exporter ainsi que leur ordre. Dans l’exemple, les colonnes exportées Name et Obtained Marks sont renommées Full Name et Marks ; les noms des colonnes d’origine du DataFrame restent inchangés. La sortie sélectionnable ci-dessus affiche l’index comme premier champ, sans nom. Définissez index=False pour l’omettre, ou indiquez index_label si l’index doit avoir un en-tête explicite.
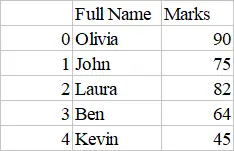
Les colonnes exportées Name et Obtained Marks sont intitulées Full Name et Marks. Le tableau complète la sortie CSV sélectionnable ci-dessus.
Personnaliser le séparateur et les autres options de sortie CSV
Définissez sep sur le délimiteur attendu par l’application destinataire. L’exemple utilise des points-virgules ; sa sortie montre ce séparateur entre les champs, y compris avant la première colonne de données, car l’index est inclus. Définissez index=False si vous ne voulez pas de ce champ d’index initial.
Pour représenter les valeurs manquantes, définissez na_rep sur un marqueur tel que "NA" ; utilisez float_format ou decimal si le système destinataire exige une représentation numérique particulière. encoding est utile pour les destinations sous forme de fichier, et compression peut produire des formats tels que gzip si cette option est choisie ou déduite du nom de fichier. Les options de citation aident à préserver les valeurs contenant des délimiteurs ou des retours à la ligne. Choisissez les options adaptées au format attendu par le programme qui lira le CSV.