
HOWTO · Matplotlib
Matplotlib 中如何同時繪製兩個直方圖
本文將介紹如何在 Matplotlib 中同時繪製兩個直方圖。
本頁內容
在 Matplotlib 中繪製兩個直方圖時,若要讓長條並排,可將兩組資料傳給 plt.hist([a, b], bins=...);若要重疊顯示,則在相同座標軸上呼叫兩次 plt.hist()。若希望每個分布各自占一個面板,可使用分開的子圖。無論採用哪種方式,都應使用相同的分箱邊界,讓對應長條代表相同區間。
以下範例需要 NumPy 和 Matplotlib,且可獨立執行。在互動式繪圖環境中,使用 plt.show() 即可顯示圖表;若環境不支援互動顯示,請依最後一節的說明儲存圖表。
繪製兩個長條不重疊的直方圖
將包含兩組資料的清單傳給同一次 plt.hist() 呼叫。使用 histtype="bar" 和 stacked=False 時,Matplotlib 會在每個分箱中將兩組資料的長條並排。這適合在同一組座標軸上逐區間比較計數。
Matplotlib 首次執行時可能會回報字型快取初始化訊息。此處的記錄設定會讓字型管理器診斷訊息顯示在標準輸出,而非標準錯誤;它並未將這些訊息隱藏。
以下範例使用生成的樣本資料,並加入圖例:
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
a = rng.normal(0, 3, 3000)
b = rng.normal(2, 4, 2000)
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 21)

plt.figure(figsize=(8, 4))
plt.hist([a, b], bins=bins, histtype="bar", stacked=False, label=["a", "b"])
plt.xlabel("Value")
plt.ylabel("Count")
plt.title("Two histograms with grouped bars")
plt.legend(loc="upper left")
plt.tight_layout()
plt.show()
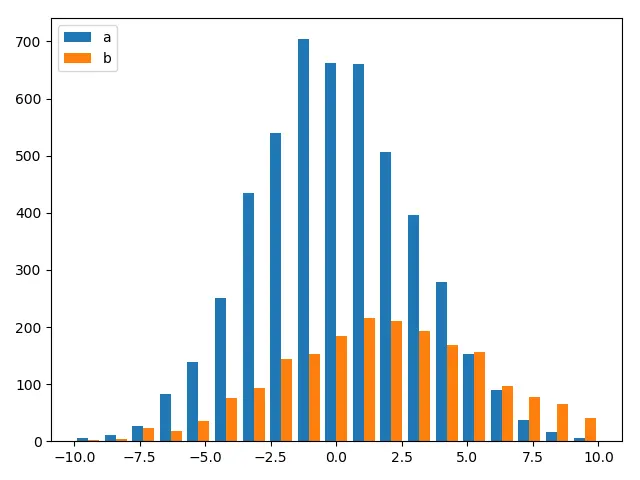
這裡的 np.linspace() 會產生 21 個邊界,因此在兩組資料的整體範圍內形成 20 個分箱。增加邊界數量可呈現更細的變化;減少數量則能凸顯較廣泛的模式。也可以指定固定範圍,例如 np.linspace(-10, 10, 21),但落在該範圍以外的觀測值不會納入直方圖。
樣本不必符合常態分布才能繪製直方圖。可將 a 和 b 換成自己的一維數值測量陣列,並確認單位一致。在使用上方範例中的 .min() 和 .max() 前,請先用 np.asarray() 將清單轉成陣列。從資料推算分箱邊界前,應移除或妥善處理缺失值與非有限值。此處的最小值和最大值計算要求兩個陣列都包含觀測值。若所有測量值都相同,請提供能涵蓋該值且彼此不同、依序遞增的邊界,避免算出相同的邊界。
繪製兩個長條重疊的直方圖
在同一組座標軸上呼叫兩次 plt.hist(),即可讓長條重疊。兩次呼叫都要傳入相同的邊界陣列。若分別只指定 bins=20,每次呼叫都會依各自資料的範圍計算邊界;即使分箱數相同,區間仍可能不同。
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
a = rng.normal(0, 3, 1000)
b = rng.normal(2, 4, 900)
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 51)

plt.figure(figsize=(8, 4))
plt.hist(a, bins=bins, alpha=0.5, label="a", color="tab:blue")
plt.hist(b, bins=bins, alpha=0.5, label="b", color="tab:orange")
plt.xlabel("Value")
plt.ylabel("Count")
plt.title("Two histograms with overlapping bars")
plt.legend(loc="upper left")
plt.tight_layout()
plt.show()
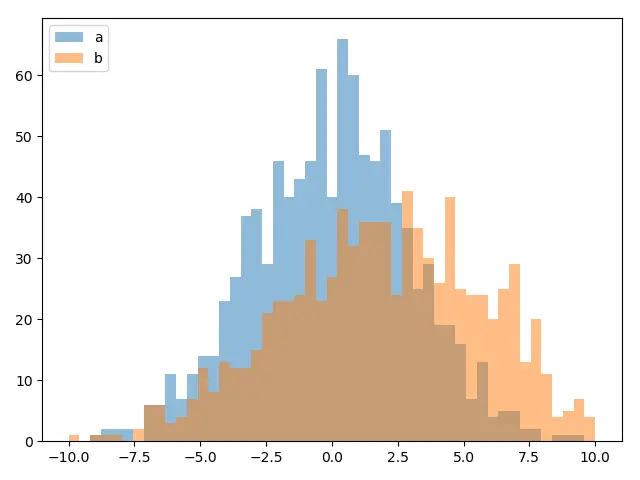
alpha 參數控制不透明度:0.0 完全透明,1.0 完全不透明,而 0.5 會讓重疊處的兩種顏色都能呈現。省略 alpha 通常會得到不透明長條,不會讓長條變透明。若不透明長條的 zorder 相同,後繪製的直方圖可能會在長條矩形重疊處遮住先繪製的直方圖,不論哪一組的計數較大。
同樣的兩組樣本在不使用 alpha 時,說明了透明度的重要性。橙色直方圖是第二個繪製的,會在重疊處遮住藍色直方圖直到自身的高度;當某根橙色長條較高時,其後方的藍色長條會完全消失,即使它代表更多觀測值。
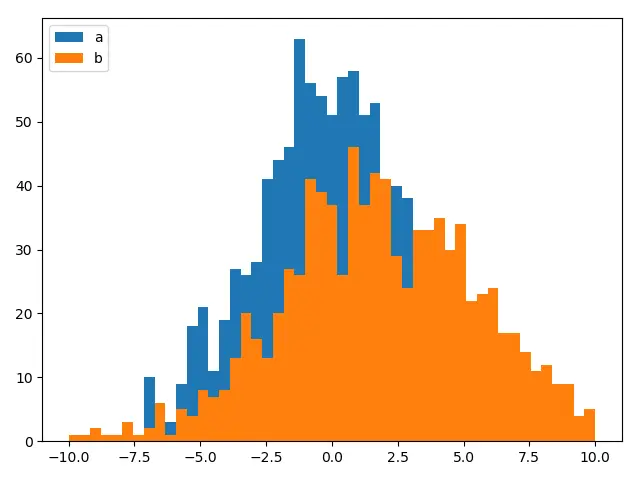
計數也會受到樣本數影響。若兩組觀測值數量不同,但你想比較分布形狀,請在兩次呼叫中都設定 density=True,並將垂直軸標示為 "Probability density"。這會讓每個直方圖在納入的觀測值範圍內總面積為一;長條高度本身不一定加總為一。
使用並排子圖比較直方圖
分開的面板可避免遮擋,也讓各個分布更容易檢視。請使用相同的分箱和座標軸刻度,避免面板的比例差異扭曲比較結果。
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
data1 = rng.normal(0, 1, 1000)
data2 = rng.normal(1, 1, 1000)
bins = np.linspace(min(data1.min(), data2.min()), max(data1.max(), data2.max()), 31)

plt.figure(figsize=(9, 4))
left = plt.subplot(1, 2, 1)
plt.hist(data1, bins=bins, color="tab:blue")
plt.title("Dataset 1")
plt.xlabel("Value")
plt.ylabel("Count")

plt.subplot(1, 2, 2, sharex=left, sharey=left)
plt.hist(data2, bins=bins, color="tab:orange")
plt.title("Dataset 2")
plt.xlabel("Value")
plt.ylabel("Count")

plt.tight_layout()
plt.show()
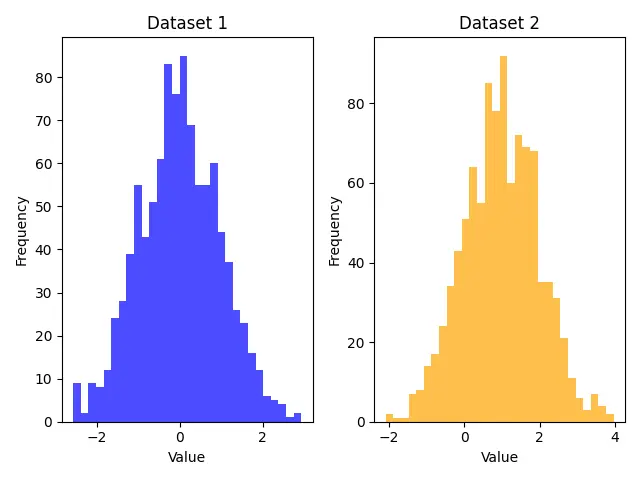
在 plt.subplot(1, 2, 1) 中,前兩個引數定義一列兩欄,第三個引數則選取左側面板。位置 2 會選取右側面板。共用兩個座標軸可讓刻度保持一致,而 plt.tight_layout() 會調整標題與標籤周圍的間距。這種配置與並排長條不同,會在同一張圖中使用兩個座標軸。
當資料集可能為空時安全地推導分箱邊界
上方範例是根據兩組資料的最小值和最大值推導共用的分箱邊界。當某個資料集為空時,這種推導會失敗,因為空陣列沒有最小值:
import numpy as np
import matplotlib.pyplot as plt

a = np.array([])
b = np.array([1.0, 2.0, 3.0])
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 21)
plt.hist([a, b], bins=bins)
輸出:
Traceback (most recent call last):
  ...
ValueError: zero-size array to reduction operation minimum which has no identity
在推導邊界前,先濾除空的資料集。在同一步驟中移除非有限值:單一 NaN 會使最小值和最大值都變成 NaN,因此推導出的每個邊界都是 NaN,直方圖便沒有可用的分箱。
import numpy as np

a = np.array([])
b = np.array([1.0, 2.0, 3.0])
datasets = [d for d in (a, b) if d.size > 0]
bins = np.linspace(min(d.min() for d in datasets), max(d.max() for d in datasets), 21)
print("datasets kept:", len(datasets))
print("first and last bin edges:", bins[0], bins[-1])
輸出:
datasets kept: 1
first and last bin edges: 1.0 3.0
濾除空資料集後,其餘資料集會決定邊界,並可使用前面章節中的並排或重疊呼叫來繪製。若濾除後 datasets 為空,則沒有可繪製的內容;請在自己的程式碼中處理這種情況,不要再推導邊界。
自訂直方圖樣式與標籤
為每組資料設定具描述性的圖例標籤,並使用不同顏色。可用 edgecolor 為長條加上邊框,再用 linestyle 讓邊框樣式更容易區分。淡色水平格線能協助讀者估讀長條高度,同時不會喧賓奪主。
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
data1 = rng.normal(0, 1, 1000)
data2 = rng.normal(1, 1, 1000)
bins = np.linspace(min(data1.min(), data2.min()), max(data1.max(), data2.max()), 31)

fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(data1, bins=bins, color="tab:blue", edgecolor="black",
        linestyle="--", alpha=0.5, label="Dataset 1")
ax.hist(data2, bins=bins, color="tab:orange", edgecolor="black",
        linestyle=":", alpha=0.5, label="Dataset 2")
ax.set(title="Styled histogram comparison", xlabel="Value", ylabel="Count")
ax.set_axisbelow(True)
ax.grid(axis="y", alpha=0.3)
ax.legend()
fig.tight_layout()
plt.show()
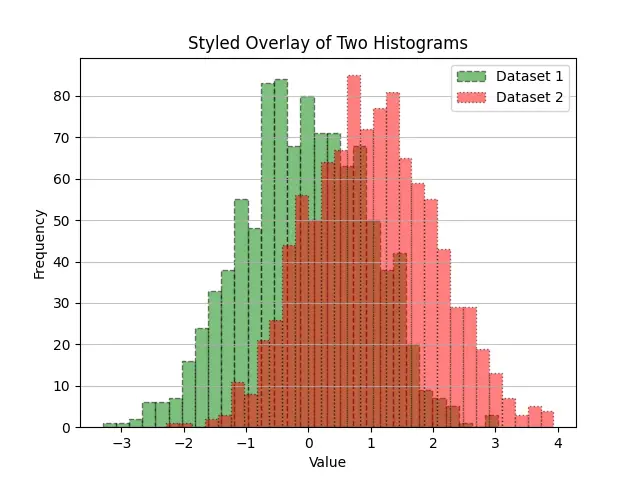
若要凸顯分布形狀而不填滿長條,可在每次直方圖呼叫中使用 histtype="step" 和適當的 linewidth。套用這些範例時,請在水平軸標籤中加入測量單位。
若要儲存圖表,請在最後一個範例的 plt.show() 前插入 fig.savefig("histograms.png", dpi=150, bbox_inches="tight")。使用 pyplot 的範例則應在顯示圖表前呼叫 plt.savefig()。先儲存再顯示,就不必依賴繪圖後端是否會保留圖表;即使沒有顯示視窗,也可以單獨儲存圖表。
若要繪製兩組以上的資料,可將更多資料集加入傳給單次 plt.hist() 呼叫的清單,並為每組資料提供標籤;也可以使用相同的邊界新增呼叫。群組數量增加時,使用輪廓線或分開的面板,通常比填入許多透明色塊更容易閱讀。
