
HOWTO · Matplotlib
Wie man zwei Histogramme zusammen in Matplotlib plotten kann
Dieser Anleitungsartikel führt ein, wie zwei Histogramme gleichzeitig in Matplotlib gezeichnet werden können.
Auf dieser Seite
Um zwei Histogramme gemeinsam in Matplotlib darzustellen, übergibst du beide Datensätze mit plt.hist([a, b], bins=...) für gruppierte Balken oder rufst plt.hist() zweimal auf denselben Achsen auf, um die Histogramme zu überlagern. Verwende separate Teilgrafiken, wenn jede Verteilung ein eigenes Feld erhalten soll. Nutze in allen Varianten gemeinsame Klassengrenzen, damit entsprechende Balken dieselben Intervalle abbilden.
Die folgenden Beispiele benötigen NumPy und Matplotlib und sind in sich geschlossen. Zum Anzeigen einer Grafik mit plt.show() ist eine interaktive Plot-Umgebung erforderlich. In einer nicht interaktiven Umgebung speicherst du die Abbildung wie im letzten Abschnitt beschrieben.
Zwei Histogramme ohne überlappende Balken darstellen
Übergib beide Datensätze als Liste in einem einzigen Aufruf von plt.hist(). Mit histtype="bar" und stacked=False setzt Matplotlib die Balken innerhalb jedes Intervalls nebeneinander. So lassen sich die Häufigkeiten für jedes Intervall auf einem gemeinsamen Achsenpaar vergleichen.
Beim ersten Start meldet Matplotlib möglicherweise die Initialisierung des Schriftart-Caches. Die Protokollierung sorgt dafür, dass Meldungen des Font-Managers auf der Standardausgabe statt auf der Standardfehlerausgabe erscheinen; sie unterdrückt diese Meldungen nicht.
Dieses Beispiel verwendet erzeugte Stichproben und enthält eine Legende:
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
a = rng.normal(0, 3, 3000)
b = rng.normal(2, 4, 2000)
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 21)

plt.figure(figsize=(8, 4))
plt.hist([a, b], bins=bins, histtype="bar", stacked=False, label=["a", "b"])
plt.xlabel("Value")
plt.ylabel("Count")
plt.title("Two histograms with grouped bars")
plt.legend(loc="upper left")
plt.tight_layout()
plt.show()
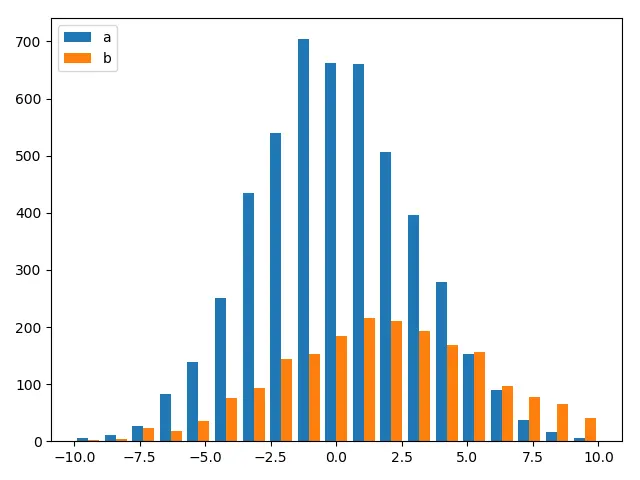
Hier liefert np.linspace() 21 Kanten und erzeugt damit 20 Klassen über den gemeinsamen Wertebereich der Daten. Mit mehr Kanten werden feinere Einzelheiten sichtbar, mit weniger Kanten treten größere Muster hervor. Du kannst auch einen festen Bereich wie np.linspace(-10, 10, 21) vorgeben; Beobachtungen außerhalb dieses Bereichs gehen dann nicht in das Histogramm ein.
Für ein Histogramm müssen die Stichproben nicht normalverteilt sein. Ersetze a und b durch eigene eindimensionale numerische Arrays mit Messwerten in einheitlichen Maßeinheiten. Wandle Listen mit np.asarray() um, bevor du die oben gezeigten Aufrufe von .min() und .max() verwendest. Behandle oder entferne fehlende und nicht endliche Werte, bevor du die Klassengrenzen aus den Daten ableitest. Beide Arrays müssen Werte enthalten, damit die hier gezeigten Minimum- und Maximum-Berechnungen funktionieren. Haben alle Messwerte denselben Wert, gib unterschiedliche, aufsteigende Kanten an, die diesen Wert einschließen, statt identische Kanten abzuleiten.
Zwei Histogramme mit überlappenden Balken darstellen
Rufe plt.hist() zweimal auf denselben Achsen auf, um die Balken zu überlagern. Übergib beiden Aufrufen dasselbe Kanten-Array. Bei zwei separaten Angaben von bins=20 würde jeder Aufruf die Kanten aus dem Wertebereich seines eigenen Datensatzes berechnen. Trotz gleicher Klassenanzahl könnten die Intervalle daher unterschiedlich sein.
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
a = rng.normal(0, 3, 1000)
b = rng.normal(2, 4, 900)
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 51)

plt.figure(figsize=(8, 4))
plt.hist(a, bins=bins, alpha=0.5, label="a", color="tab:blue")
plt.hist(b, bins=bins, alpha=0.5, label="b", color="tab:orange")
plt.xlabel("Value")
plt.ylabel("Count")
plt.title("Two histograms with overlapping bars")
plt.legend(loc="upper left")
plt.tight_layout()
plt.show()
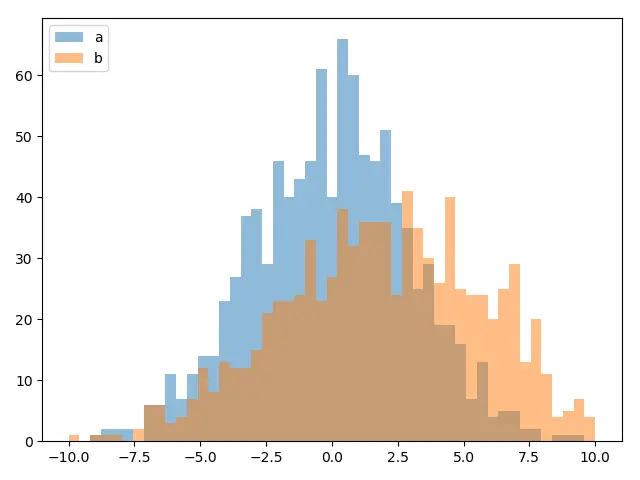
Der Parameter alpha steuert die Deckkraft: 0.0 ist vollständig transparent, 1.0 vollständig deckend, und bei 0.5 tragen beide Farben an überlappenden Stellen zur Darstellung bei. Wird alpha weggelassen, sind die Balken normalerweise deckend; sie werden dadurch nicht transparent. Haben deckende Balken denselben zorder, kann das zuletzt gezeichnete Histogramm das erste überall dort verdecken, wo sich die Rechtecke überlappen – unabhängig davon, welcher Zählwert größer ist.
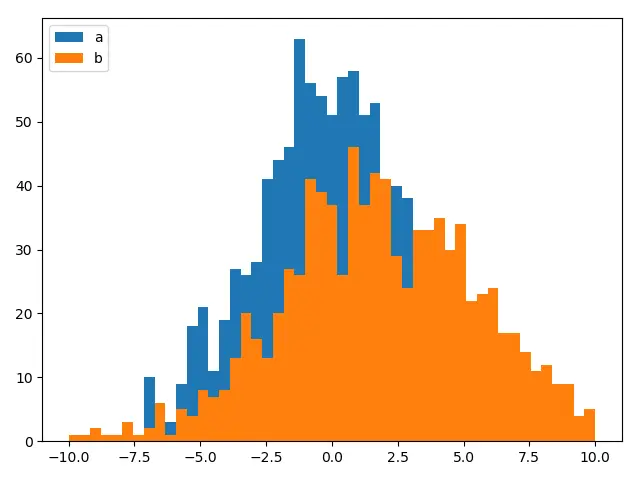
Dieselben beiden Stichproben ohne alpha zeigen, warum Transparenz wichtig ist. Das orangefarbene Histogramm wird als zweites gezeichnet und verdeckt das blaue bis zu seiner eigenen Höhe überall dort, wo sie sich überlappen; wo ein orangefarbener Balken höher ist, verschwindet der blaue Balken dahinter vollständig, selbst wenn er mehr Beobachtungen darstellt.
Die Zählwerte hängen auch von der Stichprobengröße ab. Haben die Gruppen unterschiedlich viele Beobachtungen und möchtest du ihre Verteilungsformen vergleichen, setze in beiden Aufrufen density=True und beschrifte die vertikale Achse mit "Probability density". Jedes Histogramm hat dann über die einbezogenen Beobachtungen eine Gesamtfläche von eins; die Balkenhöhen müssen sich nicht zu eins summieren.
Histogramme in nebeneinanderliegenden Teilgrafiken vergleichen
Separate Felder verhindern, dass sich die Balken verdecken, und erleichtern die Betrachtung jeder Verteilung. Verwende dieselben Klassen und Achsenskalierungen, damit Unterschiede in der Skalierung der Felder den Vergleich nicht verzerren.
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
data1 = rng.normal(0, 1, 1000)
data2 = rng.normal(1, 1, 1000)
bins = np.linspace(min(data1.min(), data2.min()), max(data1.max(), data2.max()), 31)

plt.figure(figsize=(9, 4))
left = plt.subplot(1, 2, 1)
plt.hist(data1, bins=bins, color="tab:blue")
plt.title("Dataset 1")
plt.xlabel("Value")
plt.ylabel("Count")

plt.subplot(1, 2, 2, sharex=left, sharey=left)
plt.hist(data2, bins=bins, color="tab:orange")
plt.title("Dataset 2")
plt.xlabel("Value")
plt.ylabel("Count")

plt.tight_layout()
plt.show()
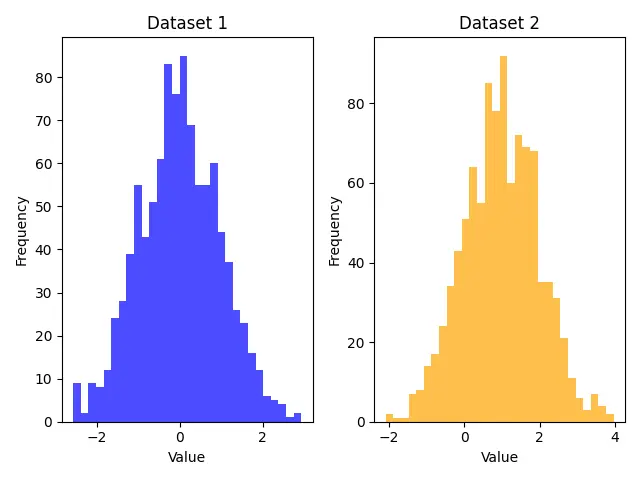
Bei plt.subplot(1, 2, 1) legen die ersten beiden Argumente eine Zeile und zwei Spalten fest; das dritte wählt das linke Feld aus. Die Position 2 wählt das rechte Feld. Werden beide Achsen geteilt, bleiben ihre Skalierungen aufeinander abgestimmt. plt.tight_layout() passt den Abstand um Titel und Beschriftungen an. Anders als bei gruppierten Balken verwendet diese Anordnung zwei Achsen innerhalb einer Abbildung.
Klassengrenzen sicher ableiten, wenn ein Datensatz leer sein kann
Die obigen Beispiele leiten die gemeinsamen Klassengrenzen aus dem Minimum und Maximum beider Datensätze ab. Diese Ableitung schlägt fehl, wenn ein Datensatz leer ist, denn ein leeres Array hat kein Minimum:
import numpy as np
import matplotlib.pyplot as plt

a = np.array([])
b = np.array([1.0, 2.0, 3.0])
bins = np.linspace(min(a.min(), b.min()), max(a.max(), b.max()), 21)
plt.hist([a, b], bins=bins)
Ausgabe:
Traceback (most recent call last):
  ...
ValueError: zero-size array to reduction operation minimum which has no identity
Filtere leere Datensätze heraus, bevor du die Kanten ableitest. Entferne im selben Schritt nicht endliche Werte: Ein einziges NaN macht Minimum und Maximum zu NaN, sodass jede abgeleitete Kante NaN ist und das Histogramm keine brauchbaren Klassen hat.
import numpy as np

a = np.array([])
b = np.array([1.0, 2.0, 3.0])
datasets = [d for d in (a, b) if d.size > 0]
bins = np.linspace(min(d.min() for d in datasets), max(d.max() for d in datasets), 21)
print("datasets kept:", len(datasets))
print("first and last bin edges:", bins[0], bins[-1])
Ausgabe:
datasets kept: 1
first and last bin edges: 1.0 3.0
Ist der leere Datensatz herausgefiltert, bestimmt der verbleibende Datensatz die Kanten und kann mit den Aufrufen für gruppierte oder überlagerte Balken aus den früheren Abschnitten dargestellt werden. Ist datasets nach dem Filtern leer, gibt es nichts darzustellen; behandle diesen Fall in deinem eigenen Code, statt Kanten abzuleiten.
Histogramme anpassen und beschriften
Gib jedem Datensatz eine aussagekräftige Legendenbeschriftung und eine eigene Farbe. Mit edgecolor werden die Balken umrandet; linestyle kann die Umrandungen zusätzlich unterscheidbar machen. Dezente horizontale Gitternetzlinien erleichtern das Abschätzen der Höhen, ohne den Vergleich zu dominieren.
import logging
import sys

# Keep first-run font-cache diagnostics visible on standard output.
font_logger = logging.getLogger("matplotlib.font_manager")
font_logger.addHandler(logging.StreamHandler(sys.stdout))
font_logger.propagate = False

import numpy as np
import matplotlib.pyplot as plt

rng = np.random.default_rng(42)
data1 = rng.normal(0, 1, 1000)
data2 = rng.normal(1, 1, 1000)
bins = np.linspace(min(data1.min(), data2.min()), max(data1.max(), data2.max()), 31)

fig, ax = plt.subplots(figsize=(8, 4))
ax.hist(data1, bins=bins, color="tab:blue", edgecolor="black",
        linestyle="--", alpha=0.5, label="Dataset 1")
ax.hist(data2, bins=bins, color="tab:orange", edgecolor="black",
        linestyle=":", alpha=0.5, label="Dataset 2")
ax.set(title="Styled histogram comparison", xlabel="Value", ylabel="Count")
ax.set_axisbelow(True)
ax.grid(axis="y", alpha=0.3)
ax.legend()
fig.tight_layout()
plt.show()
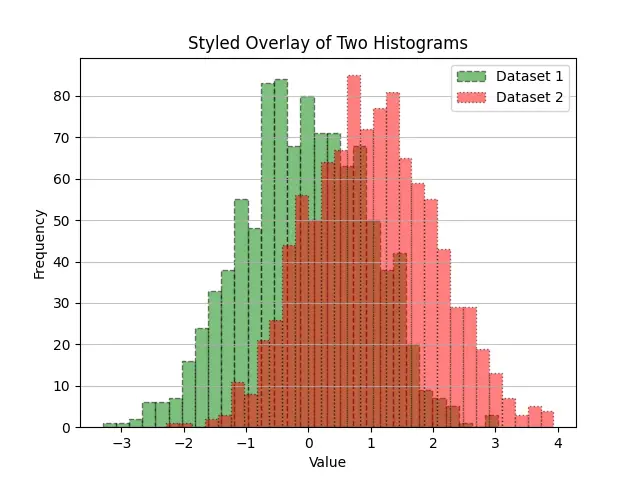
Um die Formen ohne gefüllte Balken hervorzuheben, verwende in jedem Histogramm-Aufruf histtype="step" und eine passende linewidth. Ergänze beim Anpassen der Beispiele die Maßeinheiten in der horizontalen Achsenbeschriftung.
Zum Speichern einer Grafik fügst du im letzten Beispiel fig.savefig("histograms.png", dpi=150, bbox_inches="tight") vor plt.show() ein. Bei den Pyplot-Beispielen verwendest du plt.savefig() vor dem Anzeigen der Abbildung. So musst du dich nicht darauf verlassen, dass das Plot-Backend die Abbildung danach noch bereithält. Das Speichern funktioniert auch ohne Anzeigefenster.
Für mehr als zwei Datensätze kannst du die an einen einzelnen Aufruf von plt.hist() übergebene Liste erweitern und jedem Datensatz eine Beschriftung zuweisen oder weitere Aufrufe mit denselben Kanten hinzufügen. Mit wachsender Gruppenzahl bleiben Umrisslinien oder separate Felder oft leichter lesbar als viele transparente Füllflächen.
