HOWTO · Python
Python で外れ値を検出して削除する
このチュートリアルでは、Python でのデータセットの外れ値の検出と削除について説明します。
このページの内容
データセット内で、外れ値とは、データセットの残りの部分と異常に異なる項目です。 ただし、この定義は、データ アナリストが異常のしきい値を決定するのに十分な余地を与えます。
測定エラー、実行エラー、サンプリングの問題、誤ったデータ入力、さらには自然変動による外れ値があります。 異常値が存在するとエラーが増加し、偏りが生じ、統計モデルに大きな影響を与える可能性があるため、異常値を削除することは重要です。
このチュートリアルでは、データセットから外れ値を検出して削除する方法について説明します。 scikit-learn ライブラリの一部である有名なボストン住宅データセットに手法を適用することで、これを実証します。
この記事は、外れ値を検出する方法を探り、その手法を使用して外れ値を削除する方法について説明するように構成されています。
チュートリアルに従う場合は、Google Colab を使用してブラウザ内で行うことができます。 新しいノートブックを開いてコードを書くのと同じくらい簡単です。
Google Colab の使用を開始するためのガイド の手順を次に示します。
環境の設定とデータ セットのロード
まず、使用するいくつかのライブラリをインポートします。
import sklearn
from sklearn.datasets import load_boston
import pandas as pd
import matplotlib.pyplot as plt
次に、Boston Housing データセットを読み込みます。
bh_dataset = load_boston()
データセットには、データセット内のすべての機能の名前を含む配列である feature_names 属性が含まれています。 data 属性にはすべてのデータが含まれます。
2つを分離してから結合して、Pandas データ フレームを作成します。
columns = bh_dataset.feature_names
df_boston = pd.DataFrame(bh_dataset.data)
df_boston.columns = columns
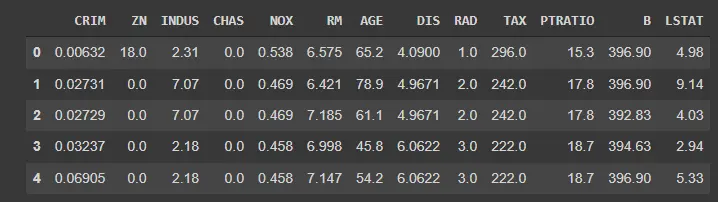
df_boston にはデータセット全体が含まれるようになりました。 Pandas では、.head() メソッドを使用して、クリーンで簡単な方法でデータセットのプレビューを取得できます。
以下に示すように関数を呼び出すと、データセットのプレビューが表示されます (下にも表示されます)。
df_boston.head()
出力:
Python でデータ セットを視覚化する
箱ひげ図を生成してデータ セットを視覚化する
Box Plot%20and%20averages.) は箱ひげ図とも呼ばれ、データを視覚化するための簡単で効果的な方法であり、外れ値を探すのに特に役立ちます。 Python では、[seaborn] ライブラリを使用して、データセットのボックス プロットを生成できます。
import seaborn as sns

sns.boxplot(df_boston["DIS"])
上記のコードのプロット:
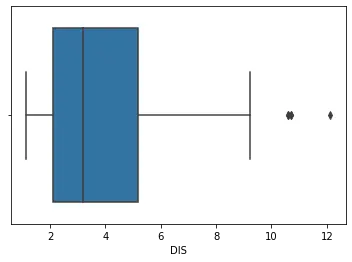
'DIS' でデータセットをインデックス化することは、DIS 列を箱ひげ図関数に渡すことを意味します。 ボックス プロットは 1 次元で生成されます。
したがって、入力として 1つの変数しか取りません。 変数を変更して、さまざまなボックス プロットを生成できます。
上のプロットでは、10 を超える値が外れ値であることがわかります。 これを、このデータセットの外れ値の基準として使用します。
以下の例に示すように、np.where を使用して、この基準に適合するデータセット内のエントリを選択できます。
import numpy as np

DIS_subset = df_boston["DIS"]
print(np.where(DIS_subset > 10))
出力:
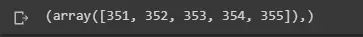
これらは、上記の基準で定義された外れ値であるデータ ポイントを含む配列インデックスです。 記事の最後で、これらのインデックスを使用してデータセットから外れ値を削除する方法を紹介します。
散布図を生成してデータ セットを視覚化する
箱ひげ図は、単一の次元にわたるデータがある場合に使用できます。 ただし、ペアのデータがある場合、または分析している関係に 2つの変数が含まれている場合は、散布図を使用できます。
Python では、Matplotlib を使用して散布図を生成できます。 以下は、散布図を印刷するコード例です。
fig, axes = plt.subplots(figsize=(18, 10))
axes.scatter(df_boston["INDUS"], df_boston["TAX"])
axes.set_xlabel("Non-retail business acres per town")
axes.set_ylabel("Tax Rate")
plt.show()
出力:
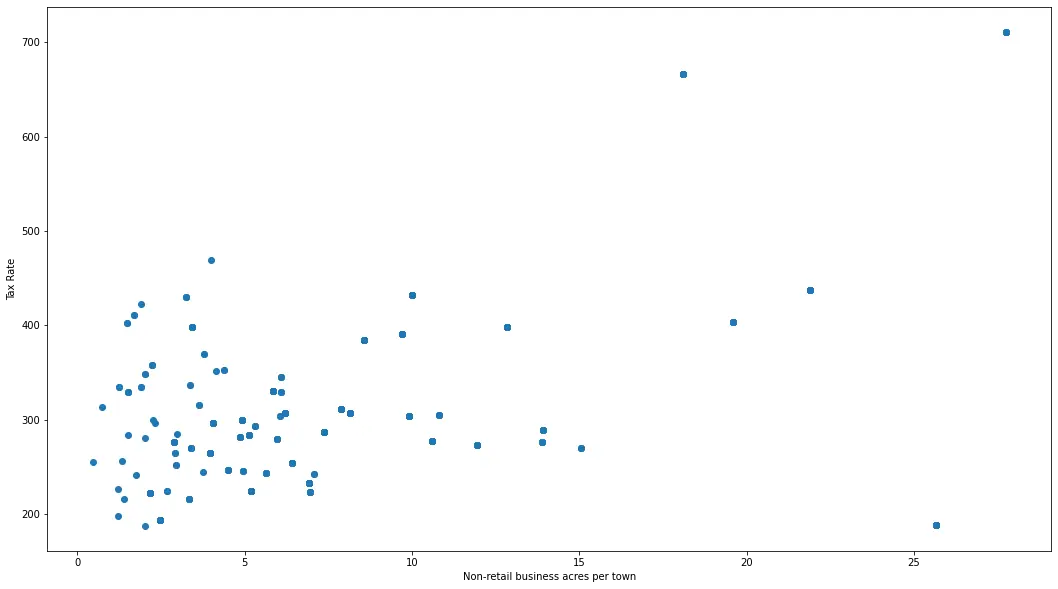
眼球の推定値を取得すると、一般に、x 軸では 20 を超える値が外れ値のように見え、y 軸では 500 を超える値が外れ値のように見えると言えます。 これを、外れ値を除去するための標準として使用できます。
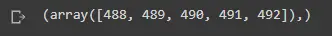
この基準に一致するインデックスを検出するために以前に使用したのと同じ numpy 関数を使用します。
print(np.where((df_boston["INDUS"] > 20) & (df_boston["TAX"] > 500)))
出力:
Python で外れ値を検出する数学的方法
Python で外れ値を検出するために Z スコアを計算する
Z スコア (標準スコアとも呼ばれます) は、データ ポイントが平均からどれだけの標準偏差であるかを測定する統計です。 Z スコアが大きいほど、データ ポイントが平均から離れていることを示します。
ほとんどのデータ ポイントは正規分布データ セットの平均値に近いため、これは重要です。 Z スコアが大きいデータ ポイントは、ほとんどのデータ ポイントから離れており、外れ値である可能性があります。
Scipy のユーティリティを使用して Z スコアを生成できます。 ここでも、データセットの特定の列を選択してメソッドを適用します。
from scipy import stats

z = stats.zscore(df_boston["DIS"])
z_abs = np.abs(z)
上記のコードの最初の行は、ライブラリをインポートするだけです。 2 行目は、scipy.zscore メソッド を使用して、選択したデータセットの各データ ポイントの Z スコアを計算します。
3 行目には、すべての値を正の値に変換する numpy 関数があります。 これは、単純なフィルターを適用するのに役立ちます。
配列を印刷すると、次のように表示されます。
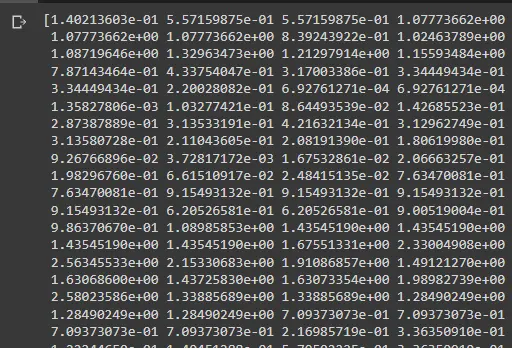
この画像にはすべての点が含まれているわけではありませんが、z_abs を印刷することで表示できます。
次に、外れ値としてカウントするポイントの基準を決定する必要があります。 正規分布を扱う場合、平均より 3 標準偏差高いデータ ポイントは外れ値と見なされます。
これは、ポイントの 99.7% が正規分布の平均の 3 標準偏差内にあるためです。 これは、Z スコアが 3 を超えるすべてのポイントを削除する必要があることを意味します。
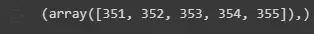
もう一度、np.where 関数を使用して外れ値インデックスを見つけます。 np.where 関数 の詳細をご覧ください。
print(np.where(z_abs > 3))
出力:
Python で外れ値を検出するために四分位範囲を計算する
これが、説明する最後の方法です。 この方法は、異常値を除去してデータをクリーンアップするための研究で非常に一般的に使用されています。
四分位範囲 (IQR) は、データの第 3 四分位と第 1 四分位の差です。 Q1 を最初の四分位として定義します。これは、データの 25% が最小値と Q1 の間にあることを意味します。
Q3 をデータの 3 番目の四分位として定義します。これは、データの 75% がデータセットの最小値と Q3 の間にあることを意味します。
これらの定義を使用して、上限と下限を定義できます。 下限より下で上限より上のすべてのデータ ポイントは外れ値と見なされます。
Lower bound = Q1 - (1.5 * IQR)
Upper bound = Q3 + (1.5 * IQR)
1.5 は恣意的に見えるかもしれませんが、数学的に重要です。 詳細な計算に興味がある場合は、この記事 を参照してください。
これは、平均から少なくとも 3 標準偏差離れたデータを見つけることとほぼ同等であることを知っておく必要があります (データが正規分布している場合)。 実際には、この方法は非常に効果的です。
Python では、NumPy 関数 percentile() を使用して Q1 と Q3 を見つけ、次に IQR を見つけることができます。
Q1 = np.percentile(df_boston["DIS"], 25, interpolation="midpoint")
Q3 = np.percentile(df_boston["DIS"], 75, interpolation="midpoint")
IQR = Q3 - Q1
私たちのデータセットでは、IQR を印刷し、以下を取得します。
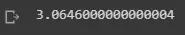
ここで、上限と下限を次のように定義します。
upper_bound = df_boston["DIS"] >= (Q3 + 1.5 * IQR)
lower_bound = df_boston["DIS"] <= (Q1 - 1.5 * IQR)
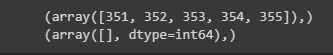
ここでも、np.where を使用して基準に適合するポイントのインデックスを取得できます。
print(np.where(upper_bound))
print(np.where(lower_bound))
出力:
Python で DataFrame から外れ値を削除する
dataframe.drop 関数を使用して外れ値を削除します。 機能の詳細はこちら。
このために、外れ値のインデックスを含むリストを関数に渡す必要があります。 これは次のように行うことができます。
upper_points = np.where(upper_bound)
df_boston.drop(upper_points[0], inplace=True)
ポイントがドロップされたかどうかを確認するために、データの形状を印刷して残りのエントリ数を確認できます。
print(df_boston.shape)
df_boston.drop(upper_points[0], inplace=True)
print(df_boston.shape)
出力:
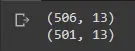
おめでとう! これにより、外れ値が正常に削除されたことを確認できます。 上記で採用したメソッドを使用して任意のインデックスのリストを渡し、それらを drop 関数に渡すことができます。