HOWTO · SciPy
SciPy を使用して信頼区間を計算する
データと出力が完全に再現可能な、t 分布と正規分布の実例を用いて、SciPy を使用して Python で信頼区間を計算する方法を学びましょう。
このページの内容
この記事は、SciPy を使用して Python で信頼区間を計算するのに役立つことを目的としています。計算の部分に入る前に、信頼区間に関する基本的な情報を理解する必要があります。
SciPy を使用して信頼区間を計算する
何かを測定する場合、結果の不確実性の程度を常に計算しなければなりません。信頼区間は、サンプルデータから計算される値の範囲であり、推定される量の真の値 — 例えば母平均 — を含むように構築されます。
ある人の身長について尋ねるとします。その人が 1.55 メートルであると言われるかもしれませんが、それはこの測定の不確実性については何も教えてくれません。
科学者はしばしば 95% の信頼区間を望みますが、90% や 99% も頻繁にあります。したがって、身長を尋ねる場合、推定値か信頼区間を与えるべきであり、例えば: 95% の信頼度で、平均身長は 1.50 メートルから 1.60 メートルの間にある、というようになります。
信頼水準は、個々の結果ではなく、手順を説明するものです。母集団の真の値は固定されています。サンプルごとに変わるのは区間の方です。95% の信頼水準とは、同じ手順を多くのサンプルで繰り返した場合、生成される区間の約 95% が真の値を含むことを意味します。単一の計算された区間は、真の値を含むか含まないかのどちらかです — 水準は、その一つの区間に対する確率ではなく、その方法の長期的な被覆に関する言明です。
信頼区間を計算するには、次の式を使用しなければなりません:
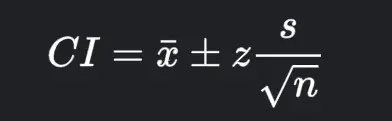
ここで:
x_barはサンプル平均です。zは信頼水準の値(選択した水準に対する臨界値)です。nはサンプルサイズです。sはサンプルの標準偏差です。
どの分布が臨界値を提供するかは、固定されたサンプルサイズの基準ではなく、母標準偏差について何が知られているかに依存します。標準偏差がサンプル自体から推定される場合、t 分布はその追加の不確実性を自由度を通じて考慮し、SciPy の t.interval() はサンプル平均と平均の標準誤差から区間を構築します。区間が、与えられた平均とスケールを持つ正規分布から直接構築される場合、norm.interval() が対応する呼び出しです。以下の二つの例は、それぞれ一つずつを使用します。どちらも SciPy 1.18 で計算され、以下に報告されるすべての値は、示されたコードの出力です。
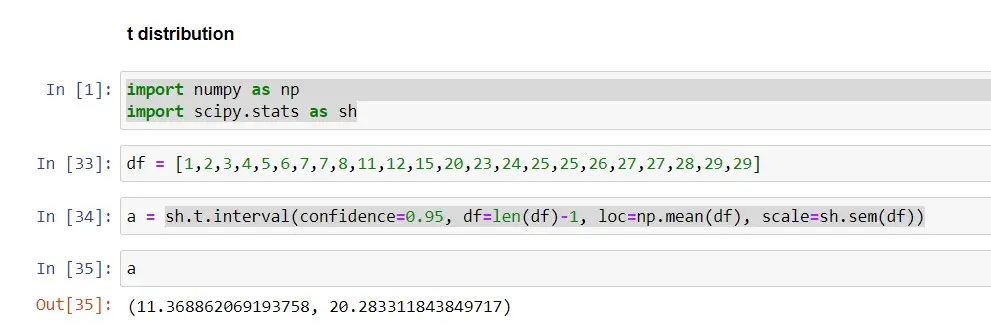
t 分布の例(n=23)。 異なる村から収集されたデータ、23 個の値のサンプルがあるとします。その 95% 信頼区間を t.interval() メソッドを使用して計算します。パラメータ confidence は 0.95 に、df は自由度(n − 1)に、loc はサンプル平均に、scale は平均の標準誤差に設定します:
import numpy as np
import scipy.stats as stats

data = [1, 2, 3, 4, 5, 6, 7, 7, 8, 11, 12, 15, 20, 23, 24, 25, 25, 26, 27, 27, 28, 29, 29]

ci_95 = stats.t.interval(confidence=0.95, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
出力:
(11.368862069193735, 20.28331184384974)
99% を使用した場合の信頼水準の違いを見てみましょう:
ci_99 = stats.t.interval(confidence=0.99, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
出力:
(9.767939107911449, 21.884234805132028)
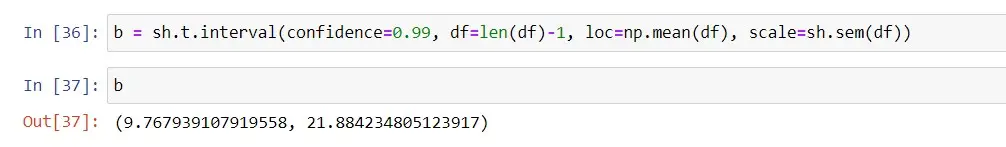
95% 信頼区間の場合、区間は (11.37, 20.28) であり、99% 信頼区間の場合、区間は (9.77, 21.88) です。両方の区間を比較すると、CI 99% を使用すると区間がより広くなることがわかります: 手順がより頻繁に真の値を捉えることを要求すると、より広い範囲が必要になります。これは、この特定の区間が真の値を含む確率が 99% であることを意味するのではありません。それを生成した方法が長期的に 100 回中 99 回成功することを意味します。
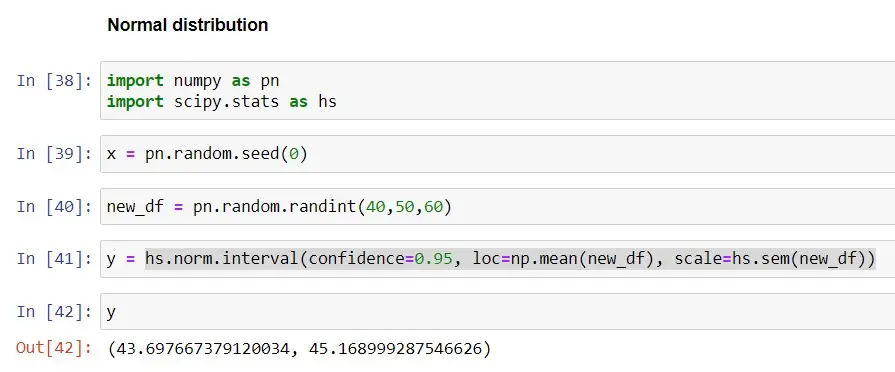
正規分布の例(n=60)。 より大きなデータセットについては、サンプル平均を loc に、標準誤差を scale にして norm.interval() メソッドを使用します。データは固定されたシードで生成されるため、この例は完全に再現可能です:
np.random.seed(0)
data = np.random.randint(40, 50, 60)

ci_95 = stats.norm.interval(confidence=0.95, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
出力:
(43.697667379120034, 45.168999287546626)
99% を使用した場合の信頼水準の違いを見てみましょう:
ci_99 = stats.norm.interval(confidence=0.99, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
出力:
(43.46650438268271, 45.40016228398395)
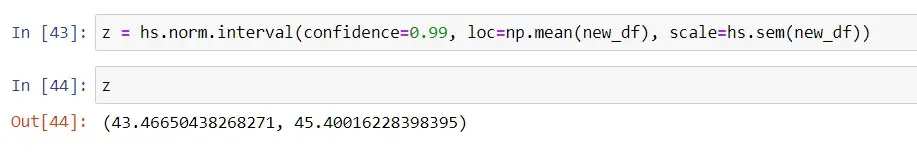
95% 信頼区間の場合、区間は (43.70, 45.17) であり、99% 信頼区間の場合、区間は (43.47, 45.40) です。前述のように、99% の区間がより広いのは同じ理由です: より高い信頼水準は手順に対するより強い要件であり、それは範囲を広げることで満たされます。
信頼区間は計算が簡単で、データアナリストや科学者に貴重な情報を提供できます。それらは強力な誤差の推定を提供し、適切に適用され、正しく解釈されれば、私たちのデータから可能な限り多くの情報を抽出するのに本当に役立ちます。