HOWTO · SciPy
SciPy를 사용하여 신뢰 구간 계산
데이터와 출력이 완전히 재현 가능한 t 분포와 정규 분포의 실제 예를 통해 SciPy를 사용하여 Python에서 신뢰 구간을 계산하는 방법을 배우십시오.
이 페이지의 내용
이 글은 SciPy를 사용하여 Python에서 신뢰 구간을 계산하는 데 도움을 주는 것을 목표로 합니다. 계산 부분으로 들어가기 전에, 신뢰 구간에 대한 몇 가지 기본 정보를 이해해야 합니다.
SciPy를 사용하여 신뢰 구간 계산
무언가를 측정할 때 우리는 항상 결과의 불확실성 정도를 계산해야 합니다. 신뢰 구간은 표본 데이터로부터 계산되는 값의 범위로, 추정되는 양의 참값 — 예를 들어 모집단 평균 — 을 포함하도록 구축됩니다.
누군가의 키에 대해 묻는다고 가정해 봅시다. 그 사람이 1.55미터라고 말할 수 있지만, 그것은 이 측정의 불확실성에 대해서는 아무것도 알려주지 않습니다.
과학자들은 종종 95% 신뢰 구간을 원하지만, 90%나 99%도 빈번합니다. 따라서 키를 묻는다면, 추정값이나 신뢰 구간을 제공해야 하며, 예를 들어: 95% 신뢰도로, 평균 키는 1.50미터에서 1.60미터 사이에 있습니다.
신뢰 수준은 단일 결과가 아니라 절차를 설명합니다. 모집단의 참값은 고정되어 있습니다. 표본마다 달라지는 것은 구간입니다. 95% 신뢰 수준이란 동일한 절차를 많은 표본에 반복했을 때, 생성된 구간의 약 95%가 참값을 포함하게 된다는 것을 의미합니다. 단일하게 계산된 구간은 참값을 포함하거나 포함하지 않거나 둘 중 하나입니다 — 수준은 그 하나의 구간에 대한 확률이 아니라, 그 방법의 장기적인 포함률에 대한 진술입니다.
신뢰 구간을 계산하려면 다음 공식을 사용해야 합니다:
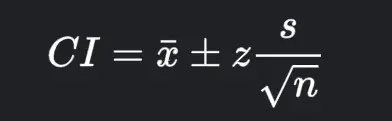
여기서:
x_bar는 표본 평균입니다.z는 신뢰 수준 값(선택한 수준에 대한 임계값)입니다.n은 표본 크기입니다.s는 표본 표준 편차입니다.
어떤 분포가 임계값을 제공하는지는 고정된 표본 크기 기준이 아니라, 모집단 표준 편차에 대해 알려진 바에 달려 있습니다. 표준 편차가 표본 자체로부터 추정되는 경우, t 분포는 그 추가적인 불확실성을 자유도를 통해 고려하며, SciPy의 t.interval()은 표본 평균과 평균의 표준 오차로부터 구간을 구축합니다. 구간이 주어진 평균과 척도를 가진 정규 분포로부터 직접 구축되는 경우, norm.interval()이 해당하는 호출입니다. 아래의 두 예는 각각 하나씩 사용합니다. 둘 다 SciPy 1.18로 계산되었으며, 아래에 보고된 모든 값은 표시된 코드의 출력입니다.
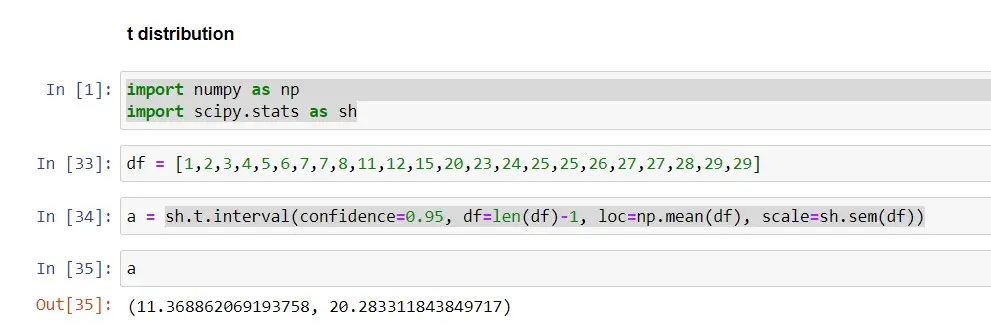
t 분포 예(n=23). 서로 다른 마을에서 수집된 데이터, 23개 값의 표본이 있다고 가정합니다. confidence 매개변수를 0.95로, df를 자유도(n − 1)로, loc을 표본 평균으로, scale을 평균의 표준 오차로 설정하여 t.interval() 메서드를 사용해 그 95% 신뢰 구간을 계산합니다:
import numpy as np
import scipy.stats as stats

data = [1, 2, 3, 4, 5, 6, 7, 7, 8, 11, 12, 15, 20, 23, 24, 25, 25, 26, 27, 27, 28, 29, 29]

ci_95 = stats.t.interval(confidence=0.95, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
출력:
(11.368862069193735, 20.28331184384974)
99%를 사용할 때 신뢰 수준의 차이를 살펴보겠습니다:
ci_99 = stats.t.interval(confidence=0.99, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
출력:
(9.767939107911449, 21.884234805132028)
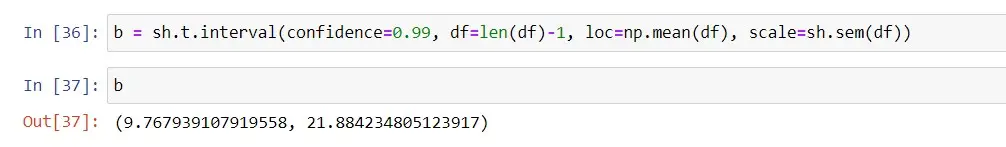
95% 신뢰 구간의 경우 구간은 (11.37, 20.28)이고, 99% 신뢰 구간의 경우 구간은 (9.77, 21.88)입니다. 두 구간을 비교하면, 99% CI를 사용할 때 구간이 더 넓다는 것을 알 수 있습니다: 절차가 참값을 더 자주 포착하도록 요구하면 더 넓은 범위가 필요합니다. 이는 이 특정 구간이 참값을 포함할 확률이 99%라는 의미가 아닙니다. 그것을 생성한 방법이 장기적으로 100번 중 99번 성공한다는 의미입니다.
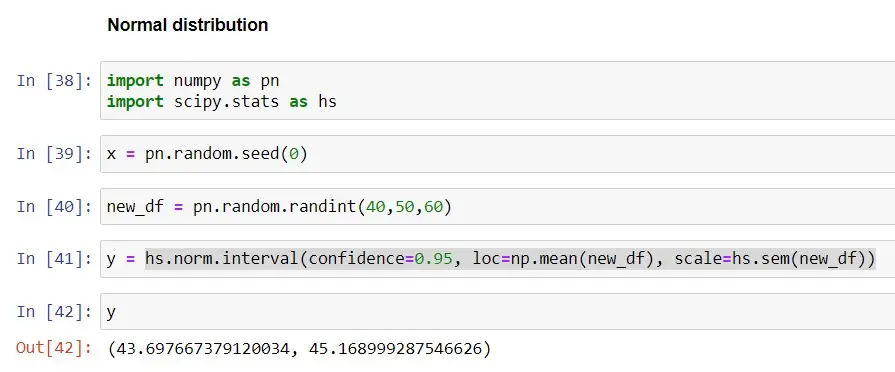
정규 분포 예(n=60). 더 큰 데이터셋에 대해서는 표본 평균을 loc으로, 표준 오차를 scale로 하여 norm.interval() 메서드를 사용합니다. 데이터는 고정된 시드로 생성되므로, 이 예는 완전히 재현 가능합니다:
np.random.seed(0)
data = np.random.randint(40, 50, 60)

ci_95 = stats.norm.interval(confidence=0.95, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
출력:
(43.697667379120034, 45.168999287546626)
99%를 사용할 때 신뢰 수준의 차이를 살펴보겠습니다:
ci_99 = stats.norm.interval(confidence=0.99, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
출력:
(43.46650438268271, 45.40016228398395)
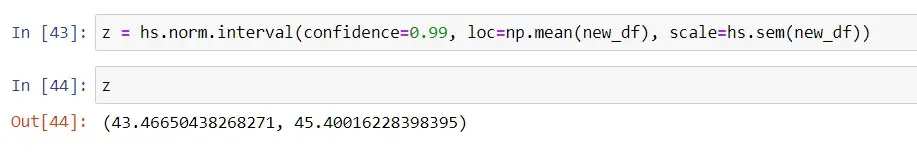
95% 신뢰 구간의 경우 구간은 (43.70, 45.17)이고, 99% 신뢰 구간의 경우 구간은 (43.47, 45.40)입니다. 앞서와 같이, 99% 구간이 더 넓은 것은 같은 이유 때문입니다: 더 높은 신뢰 수준은 절차에 대한 더 강한 요구이며, 그것은 범위를 넓힘으로써 충족됩니다.
신뢰 구간은 계산하기 간단하며 데이터 분석가와 과학자에게 가치 있는 정보를 제공할 수 있습니다. 그것들은 강력한 오차 추정을 제공하며, 적절히 적용되고 올바르게 해석될 때, 우리의 데이터로부터 가능한 한 많은 정보를 추출하는 데 진정으로 도움이 될 수 있습니다.