HOWTO · SciPy
Calcule el intervalo de confianza usando SciPy
Aprenda a calcular intervalos de confianza en Python usando SciPy, con ejemplos resueltos de la distribución t y la distribución normal cuyos datos y salidas son totalmente reproducibles.
En esta página
Este artículo tiene como objetivo ayudarlo a calcular los intervalos de confianza en Python utilizando SciPy. Antes de sumergirnos en la parte de cálculo, es necesario comprender información básica sobre el intervalo de confianza.
Calcule el intervalo de confianza usando SciPy
Cuando medimos algo, siempre debemos calcular el grado de incertidumbre en el resultado. Un intervalo de confianza es un rango de valores, calculado a partir de datos de muestra, que se construye para contener el valor verdadero de la cantidad que se está estimando — por ejemplo, una media poblacional.
Suponga que pregunta por la altura de una persona. Podrían decirle que mide 1.55 metros, pero eso no le dice nada sobre la incertidumbre de esta medición.
Los científicos a menudo quieren un intervalo de confianza del 95%, pero el 90% o incluso el 99% también son frecuentes. Por lo tanto, si pregunta por la altura, deberían darle una estimación o un intervalo de confianza, como por ejemplo: con un 95% de confianza, la altura media se encuentra entre 1.50 metros y 1.60 metros.
El nivel de confianza describe el procedimiento, no un resultado individual. El valor verdadero de la población es fijo; es el intervalo el que varía de muestra en muestra. Un nivel de confianza del 95% significa que si el mismo procedimiento se repitiera en muchas muestras, alrededor del 95% de los intervalos producidos contendrían el valor verdadero. Un único intervalo calculado o contiene el valor verdadero o no lo contiene — el nivel es una declaración sobre la cobertura a largo plazo del método, no una probabilidad para ese intervalo en particular.
Para calcular el intervalo de confianza, tenemos que usar la siguiente fórmula:
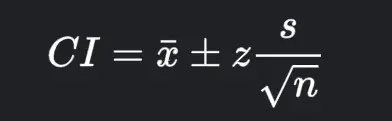
Donde:
- El
x_bares la media de la muestra. - La
zes el valor del nivel de confianza (el valor crítico para el nivel elegido). - La
nes el tamaño de la muestra. - La
ses la desviación estándar de la muestra.
Qué distribución proporciona el valor crítico depende de lo que se conoce sobre la desviación estándar de la población, no de un límite fijo de tamaño de muestra. Cuando la desviación estándar se estima a partir de la propia muestra, la distribución t tiene en cuenta esa incertidumbre adicional a través de sus grados de libertad, y t.interval() de SciPy construye el intervalo a partir de la media de la muestra y el error estándar de la media. Cuando el intervalo se construye directamente a partir de una distribución normal con una media y una escala dadas, norm.interval() es la llamada correspondiente. Los dos ejemplos siguientes utilizan una cada uno; ambos se calculan con SciPy 1.18, y cada valor reportado a continuación es la salida del código mostrado.
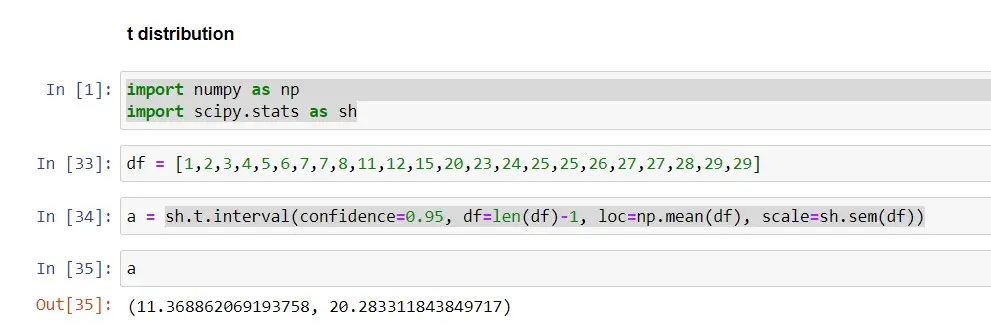
El ejemplo de la distribución t (n=23). Suponga que tenemos datos recopilados de diferentes pueblos, una muestra de 23 valores. Calculamos su intervalo de confianza del 95% utilizando el método t.interval(), con el parámetro confidence establecido en 0.95, df establecido en los grados de libertad (n − 1), loc establecido en la media de la muestra y scale establecido en el error estándar de la media:
import numpy as np
import scipy.stats as stats

data = [1, 2, 3, 4, 5, 6, 7, 7, 8, 11, 12, 15, 20, 23, 24, 25, 25, 26, 27, 27, 28, 29, 29]

ci_95 = stats.t.interval(confidence=0.95, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
Salida:
(11.368862069193735, 20.28331184384974)
Veamos la diferencia en el nivel de confianza cuando usamos el 99%:
ci_99 = stats.t.interval(confidence=0.99, df=len(data) - 1, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
Salida:
(9.767939107911449, 21.884234805132028)
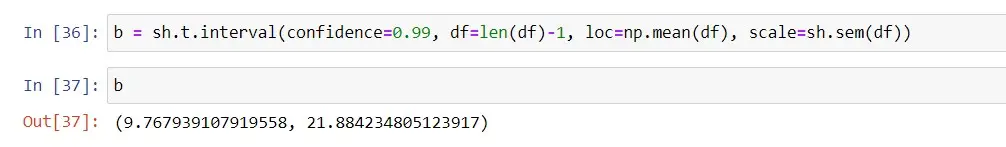
Con un intervalo de confianza del 95%, el intervalo es (11.37, 20.28), mientras que con un intervalo de confianza del 99%, el intervalo es (9.77, 21.88). Al comparar ambos intervalos, podemos ver que el intervalo es más ancho cuando usamos un IC del 99%: exigir que el procedimiento capture el valor verdadero con más frecuencia requiere un rango más amplio. No significa que haya una probabilidad del 99% de que este intervalo en particular contenga el valor verdadero; significa que el método que lo produjo tiene éxito 99 de cada 100 veces a largo plazo.
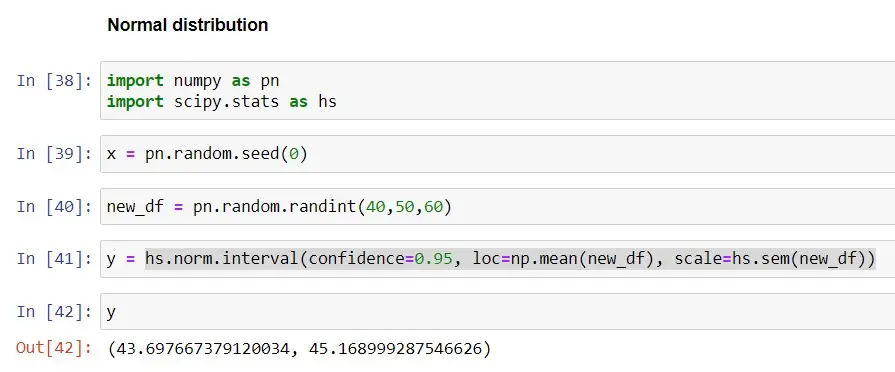
El ejemplo de la distribución normal (n=60). Para un conjunto de datos más grande, usamos el método norm.interval() con la media de la muestra como loc y el error estándar como scale. Los datos se generan con una semilla fija, por lo que el ejemplo es totalmente reproducible:
np.random.seed(0)
data = np.random.randint(40, 50, 60)

ci_95 = stats.norm.interval(confidence=0.95, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_95))
Salida:
(43.697667379120034, 45.168999287546626)
Veamos la diferencia en el nivel de confianza cuando usamos el 99%:
ci_99 = stats.norm.interval(confidence=0.99, loc=np.mean(data), scale=stats.sem(data))
print(tuple(float(v) for v in ci_99))
Salida:
(43.46650438268271, 45.40016228398395)
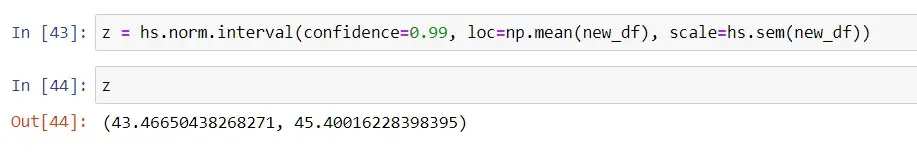
Con un intervalo de confianza del 95%, el intervalo es (43.70, 45.17); con un intervalo de confianza del 99%, el intervalo es (43.47, 45.40). Como antes, el intervalo del 99% es más ancho, por la misma razón: el nivel de confianza más alto es un requisito más fuerte sobre el procedimiento, y se cumple ampliando el rango.
Los intervalos de confianza son sencillos de calcular y pueden proporcionar a los analistas de datos y científicos información valiosa. Proporcionan una potente estimación del error y, cuando se aplican adecuadamente y se interpretan correctamente, realmente pueden ayudarnos a extraer tanta información de nuestros datos como sea posible.