HOWTO · PostgreSQL
PostgreSQL のデータベースで重複レコードを見つけて削除する
この記事では、データベース内の重複レコードを見つけて、PostgreSQL で削除する方法を示します。
このページの内容
PostgreSQLで重複を見つけるには、重複の定義に使う列でグループ化し、件数が1を超えるグループを抽出します。余分な行を安全に削除するには、同じグループ内で ROW_NUMBER() を使い、残す行より後の番号が付いた行を事前に確認してから、sid のような安定した一意キーで削除します。比較する列はデータ上のルールに応じて選びます。名前が一致していても、学生レコードとして重複しているとは限りません。
PostgreSQLの重複検出用サンプルスキーマ
この記事では、主キーと3つの説明用列を持つ Student テーブルを使用します。SQLはクエリの例を示すもので、設定された実行環境ではPostgreSQLの文を実行しないため、データベースの実行結果は示しません。
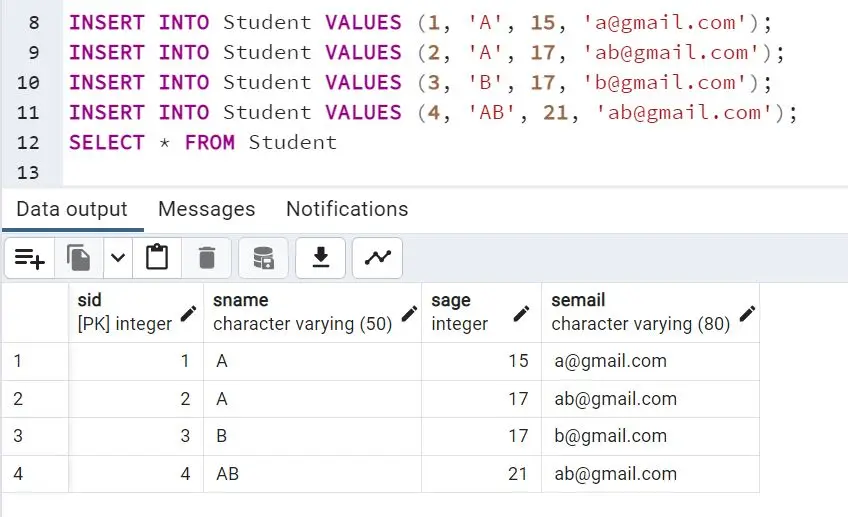
スキーマは CREATE TABLE Student (sid INT PRIMARY KEY, sname VARCHAR(50), sage INT, semail VARCHAR(80)); です。サンプル行は (1, 'A', 15, 'a@gmail.com')、(2, 'A', 17, 'ab@gmail.com')、(3, 'B', 17, 'b@gmail.com')、(4, 'AB', 21, 'ab@gmail.com') で、Student (sid, sname, sage, semail) に挿入します。
sid は主キーなので一意です。それ以外の列には同じ値が入ることがあります。このサンプルでは、sname が A の行、sage が 17 の行、semail が ab@gmail.com の行がそれぞれ2つあります。テーブル状態の画像には、提示されたサンプルデータが表示されています。
重複とみなす条件を決める
クエリを書く前に、業務上のルールを決めます。名前の重複を調べるなら sname、メールアドレスの重複なら semail、名前と年齢の組み合わせの重複なら sname と sage の両方を比較します。ある行が重複かどうかは、選んだ列に照らして判断します。たとえば、名前が A の2行は年齢とメールアドレスが異なるため、名前は重複していますが、学生情報全体が同一ではありません。
NULL値や文字列の正規化も、同じルールに沿って扱います。GROUP BY ではNULL値がひとつのグループにまとめられるため、値の欠落を一致として扱うか決めてください。大文字・小文字や前後の空白を無視する場合は、検出と削除の両方で同じ正規化式を一貫して使います。メールアドレスの比較なら、たとえば lower(trim(semail)) を使えます。
重複する値と行を見つける
次の小さな例では、選んだ名前列でグループ化し、重複する名前を識別する方法を示します。サンプル行を使ってグループ化のルールを説明するもので、PostgreSQLのSQLを実行する例ではありません。例の出力にある「A: 2」はコードのバイト一致を保つため英語表記のままです。
このセクションのコードと表示されるラベルや出力は英語のままです。
from collections import Counter

students = [
    (1, "A", 15, "a@gmail.com"),
    (2, "A", 17, "ab@gmail.com"),
    (3, "B", 17, "b@gmail.com"),
    (4, "AB", 21, "ab@gmail.com"),
]
name_counts = Counter(student[1] for student in students)
for name, count in name_counts.items():
    if count > 1:
        print(f"{name}: {count}")
A: 2
PostgreSQLのクエリで重複する名前を数えるには、SELECT sname, count(*) AS occurrences FROM Student GROUP BY sname HAVING count(*) > 1; を使います。重複する組み合わせを調べるには、比較する各列を SELECT リストと GROUP BY の両方に追加します。たとえば GROUP BY sname, sage なら、名前と年齢の組み合わせが重複するグループを見つけられます。HAVING はグループ化した後にグループを絞り込みます。
重複グループに属する行をすべて一覧表示するには、SELECT * FROM Student s WHERE (SELECT count(*) FROM Student m WHERE m.sname IS NOT DISTINCT FROM s.sname) > 1; を使います。IS NOT DISTINCT FROM は2つのNULLの名前も一致として扱うため、この相関カウントでは、NULLの名前が繰り返されるグループの全行と、NULL以外の名前が重複する全行が対象になります。各行について比較を繰り返し、グループごとの要約ではなく、一致する行をすべて返します。大きなテーブルでは、グループ化したクエリを Student に結合して該当行を確認する方法もあります。
行単位で選ぶ場合は、ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) を使い、外側のクエリで rn > 1 の行を絞り込みます。PARTITION BY が重複グループを定義し、並び順によってどの行に1番目の番号が付くかが決まります。このスキーマでは、主キーに sid を含めて全列を比較しても、同一の行は見つかりません。主キーによって、同じ sid を持つ行が2つ存在できないためです。識別子を除いて説明用の値をすべて比較するには、sname, sage, semail でグループ化します。
PostgreSQLで重複行を安全に削除する
まず、削除対象となる行を正確に確認します。次のパターンは、名前が重複するグループごとに最小の sid を残し、ほかの行を選択します: WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) SELECT s.* FROM Student s JOIN ranked r USING (sid) WHERE r.rn > 1;。PARTITION BY には、重複の判定に選んだ列を指定してください。ORDER BY sid を変更するのは、どの行を残すかのルールが文書化されている場合に限ります。識別子による並べ替えは決定的ですが、どの行が最新かを示すものではありません。
プレビューを確認したら、対応する削除クエリを実行します: WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) DELETE FROM Student s USING ranked r WHERE s.sid = r.sid AND r.rn > 1;。sid による結合で、順位付けによって選ばれた行だけを対象にします。可能であればプレビューと削除をトランザクション内で行い、コミット前に影響を受けた行を確認してください。重要なデータにはバックアップを取るか、通常の復旧手順を用意します。sid の大小を条件にした名前だけの自己結合は使わないでください。ほかの値が異なる行まで、名前が同じという理由で削除する可能性があり、並び順だけでは新しさも判断できません。
結果を確認し、重複の再発を防ぐ
重複の判定に使った列で、グループ化によるチェックをもう一度行います。名前を基準に整理した場合、SELECT sname, count(*) FROM Student GROUP BY sname HAVING count(*) > 1; は、重複する名前のグループが残っていなければ行を返しません。残った行も確認し、選択した保持ルールによって必要なデータが残っていることを確かめます。
今後の重複を防ぐには、実際のルールに対応する列に UNIQUE 制約または一意インデックスを追加します。たとえば、NULL以外のメールアドレスを一意にするなら UNIQUE (semail) を指定できます。追加前に既存の競合を確認して解消してください。PostgreSQLの一意制約では通常、複数のNULL値が許可されます。メールアドレスの欠落も一意にしたい場合は、明確な方針を決め、それに沿って制約を設けます。異なる学生が同じ名前を持つことがあるなら、sname に制約を付けるのは適切ではありません。
まとめ
まず比較する列を選び、GROUP BY または ROW_NUMBER() で該当するグループを調べ、削除には安定した一意キーを使います。破壊的な変更をコミットする前に、対象行をプレビューして結果を確認してください。こうすることで「重複」の意味が明確になり、有効なレコードを保護しやすくなります。