HOWTO · PostgreSQL
Buscar y eliminar registros duplicados en una base de datos en PostgreSQL
Este artículo muestra cómo encontrar registros duplicados en una base de datos y luego eliminarlos en PostgreSQL.
En esta página
Para encontrar duplicados en PostgreSQL, agrupa por las columnas que los definen y conserva los grupos cuyo recuento sea mayor que uno. Para eliminar filas sobrantes de forma segura, usa ROW_NUMBER() dentro de esos mismos grupos, revisa las filas numeradas después de la que se conserva y elimínalas mediante una clave única y estable, como sid. Las columnas de comparación adecuadas dependen de las reglas de tus datos: que dos nombres coincidan no significa necesariamente que sean registros duplicados de estudiantes.
Esquema de ejemplo para detectar duplicados en PostgreSQL
En este artículo se usa una tabla Student con una clave primaria y tres columnas descriptivas. Las consultas SQL son ejemplos ilustrativos; el entorno de ejecución configurado no ejecuta instrucciones de PostgreSQL, por lo que no se afirma que se haya obtenido ningún resultado de una base de datos.
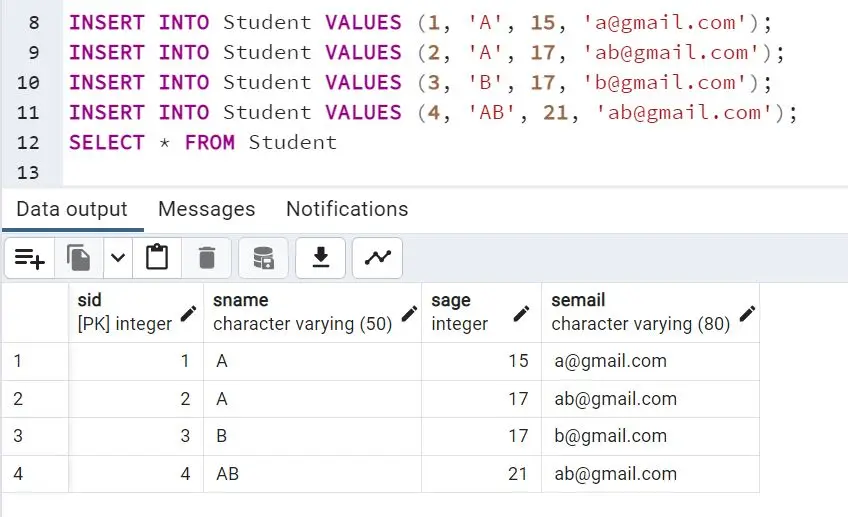
El esquema es CREATE TABLE Student (sid INT PRIMARY KEY, sname VARCHAR(50), sage INT, semail VARCHAR(80));. Las filas de ejemplo son (1, 'A', 15, 'a@gmail.com'), (2, 'A', 17, 'ab@gmail.com'), (3, 'B', 17, 'b@gmail.com') y (4, 'AB', 21, 'ab@gmail.com'), insertadas en Student (sid, sname, sage, semail).
sid es único porque es la clave primaria. Las demás columnas pueden repetirse: en el ejemplo, hay dos valores sname iguales a A, dos valores sage iguales a 17 y dos valores semail iguales a ab@gmail.com. La imagen del estado de la tabla muestra los datos de ejemplo proporcionados.
Decide qué cuenta como duplicado
Define la regla de negocio antes de consultar los datos. Para encontrar nombres repetidos, compara sname; para buscar direcciones de correo repetidas, compara semail; y para detectar combinaciones repetidas de nombre y edad, compara sname y sage. Una fila solo es duplicada con respecto a las columnas elegidas. Por ejemplo, las dos filas con el nombre A tienen edades y correos distintos: son nombres duplicados, pero no contienen los mismos datos de estudiante.
Aplica la misma regla a los valores nulos y a la normalización del texto. GROUP BY reúne los valores nulos en un mismo grupo, así que decide si los valores faltantes deben considerarse coincidentes. Si quieres ignorar las mayúsculas o los espacios al principio y al final, usa de forma coherente la misma expresión de normalización al detectar y eliminar duplicados, como lower(trim(semail)) para comparar correos electrónicos.
Encuentra valores y filas duplicados
Ejecuta este pequeño ejemplo para ver cómo agrupar por la columna de nombres elegida permite identificar los nombres repetidos. Ilustra la regla de agrupación con las filas de ejemplo, pero no ejecuta instrucciones SQL de PostgreSQL.
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from collections import Counter

students = [
    (1, "A", 15, "a@gmail.com"),
    (2, "A", 17, "ab@gmail.com"),
    (3, "B", 17, "b@gmail.com"),
    (4, "AB", 21, "ab@gmail.com"),
]
name_counts = Counter(student[1] for student in students)
for name, count in name_counts.items():
    if count > 1:
        print(f"{name}: {count}")
A: 2
Para la consulta de PostgreSQL, cuenta los nombres duplicados con SELECT sname, count(*) AS occurrences FROM Student GROUP BY sname HAVING count(*) > 1;. Para detectar combinaciones duplicadas, añade cada columna de comparación tanto a la lista de SELECT como a la cláusula GROUP BY. Por ejemplo, GROUP BY sname, sage encuentra pares repetidos de nombre y edad. HAVING filtra los grupos una vez agrupadas las filas.
Para enumerar todas las filas cuyo nombre pertenece a un grupo duplicado, usa SELECT * FROM Student s WHERE (SELECT count(*) FROM Student m WHERE m.sname IS NOT DISTINCT FROM s.sname) > 1;. IS NOT DISTINCT FROM considera coincidentes dos nombres nulos, por lo que este recuento correlacionado incluye todas las filas de un grupo con nombre nulo repetido, además de las que tienen nombres no nulos repetidos. La comparación se repite para cada fila y devuelve todas las filas coincidentes, no un único resumen por grupo. En tablas grandes, también puedes inspeccionar las filas coincidentes uniendo la consulta agrupada de nuevo con Student.
Para seleccionar filas individuales, usa ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) y filtra en una consulta externa con rn > 1. PARTITION BY define los grupos de duplicados; el orden determina qué fila recibe el número uno. En este esquema, una comparación de filas completas que incluya sid no puede encontrar filas idénticas, porque la clave primaria impide que dos filas compartan el mismo sid. Para comparar todos los valores descriptivos en su lugar, agrupa por sname, sage, semail; así detectarás detalles coincidentes sin tener en cuenta el identificador.
Elimina filas duplicadas de forma segura en PostgreSQL
Primero, inspecciona exactamente qué filas se eliminarían. El siguiente patrón conserva el sid más pequeño de cada grupo con nombres repetidos y selecciona las demás: WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) SELECT s.* FROM Student s JOIN ranked r USING (sid) WHERE r.rn > 1;. Usa en PARTITION BY las columnas que hayas elegido para definir los duplicados; cambia ORDER BY sid solo si tienes una regla documentada para decidir qué fila conservar. Ordenar por identificador es determinista, pero no demuestra cuál es la fila más reciente.
Después de revisar la vista previa, la eliminación correspondiente es WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) DELETE FROM Student s USING ranked r WHERE s.sid = r.sid AND r.rn > 1;. La unión por sid selecciona únicamente las filas indicadas por la numeración. Siempre que sea práctico, ejecuta la vista previa y la eliminación dentro de una transacción y verifica las filas afectadas antes de confirmar los cambios. Para datos importantes, haz una copia de seguridad o sigue tu procedimiento habitual de recuperación. No uses una unión de la tabla consigo misma basada solo en el nombre y en una desigualdad sobre sid: podría eliminar filas con el mismo nombre aunque difieran en otros valores, y el orden por sí solo no determina cuál es la más reciente.
Verifica el resultado y evita que vuelvan a aparecer duplicados
Repite la comprobación agrupada de duplicados con las columnas de comparación previstas. Para los nombres, SELECT sname, count(*) FROM Student GROUP BY sname HAVING count(*) > 1; debería devolver cero grupos con nombres duplicados si esa fue la regla usada para depurar los datos. Inspecciona también las filas restantes y confirma que la regla elegida para conservar una fila mantuvo los datos que necesitas.
Para evitar duplicados futuros, añade una restricción UNIQUE o un índice único sobre las columnas que representen la regla real; por ejemplo, UNIQUE (semail) si cada correo no nulo debe ser único. Primero comprueba y resuelve los conflictos existentes. Por lo general, las restricciones únicas de PostgreSQL permiten varios valores nulos; si también necesitas que los correos faltantes sean únicos, define una política explícita y aplícala. Una restricción sobre sname sería inadecuada si distintos estudiantes pueden compartir el mismo nombre.
Conclusión
Primero elige las columnas de comparación, usa GROUP BY o ROW_NUMBER() para inspeccionar los grupos resultantes y basa la eliminación en una clave única y estable. Antes de confirmar un cambio destructivo, revisa las filas seleccionadas y verifica el resultado. Así dejarás claro qué significa «duplicado» y ayudarás a proteger los registros válidos.