HOWTO · PostgreSQL
Suchen und löschen Sie doppelte Datensätze in einer Datenbank in PostgreSQL
Dieser Artikel zeigt, wie Sie doppelte Datensätze in einer Datenbank finden und diese dann in PostgreSQL löschen.
Auf dieser Seite
Um Duplikate in PostgreSQL zu finden, gruppieren Sie nach den Spalten, die ein Duplikat definieren, und behalten Sie Gruppen mit mehr als einem Eintrag bei. Um überzählige Zeilen sicher zu entfernen, verwenden Sie ROW_NUMBER() innerhalb derselben Gruppen, prüfen Sie zunächst die Zeilen mit einer Nummer nach dem beizubehaltenden Datensatz und löschen Sie sie anhand eines stabilen eindeutigen Schlüssels wie sid. Welche Vergleichsspalten richtig sind, hängt von Ihrer Datenregel ab: Gleiche Namen bedeuten nicht zwangsläufig doppelte Studentendatensätze.
PostgreSQL-Beispielschema zur Duplikaterkennung
Dieser Artikel verwendet eine Tabelle Student mit einem Primärschlüssel und drei beschreibenden Spalten. Die SQL-Beispiele veranschaulichen Abfragen; die konfigurierte Laufzeit führt keine PostgreSQL-Anweisungen aus, daher wird keine Datenbankausgabe behauptet.
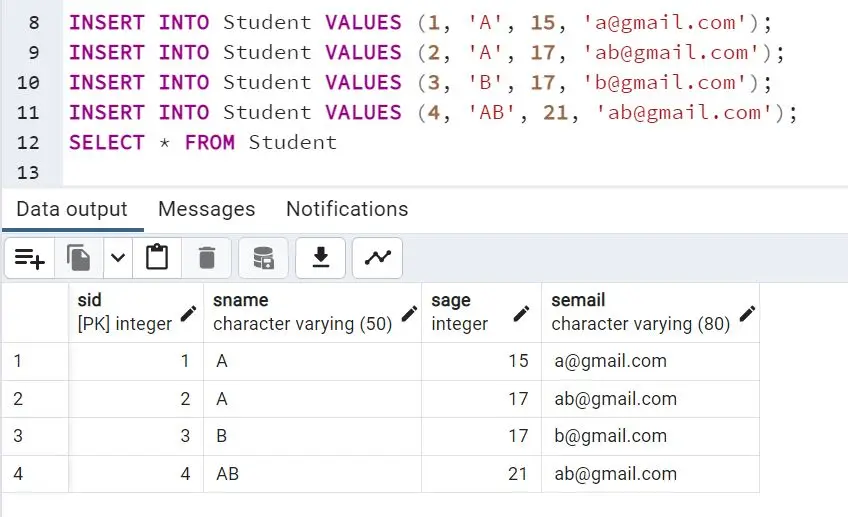
Das Schema lautet CREATE TABLE Student (sid INT PRIMARY KEY, sname VARCHAR(50), sage INT, semail VARCHAR(80));. Die Beispieldatensätze sind (1, 'A', 15, 'a@gmail.com'), (2, 'A', 17, 'ab@gmail.com'), (3, 'B', 17, 'b@gmail.com') und (4, 'AB', 21, 'ab@gmail.com'); sie werden in Student (sid, sname, sage, semail) eingefügt.
sid ist eindeutig, weil es der Primärschlüssel ist. Die übrigen Spalten können wiederholte Werte enthalten: Im Beispiel gibt es zweimal den sname-Wert A, zweimal den sage-Wert 17 und zweimal die semail-Adresse ab@gmail.com. Das Tabellenbild zeigt die bereitgestellten Beispieldaten.
Festlegen, was als Duplikat gilt
Legen Sie vor der Abfrage die fachliche Regel fest. Um wiederholte Namen zu finden, vergleichen Sie sname; für wiederholte E-Mail-Adressen vergleichen Sie semail; für wiederholte Kombinationen aus Name und Alter vergleichen Sie sname und sage. Eine Zeile ist nur in Bezug auf die ausgewählten Spalten ein Duplikat. Die beiden Zeilen mit A haben beispielsweise unterschiedliche Alters- und E-Mail-Werte. Sie sind also doppelte Namen, aber keine identischen Studentendaten.
Behandeln Sie Nullwerte und die Normalisierung von Text entsprechend derselben Regel. GROUP BY fasst Nullwerte in einer Gruppe zusammen. Entscheiden Sie daher, ob fehlende Werte als Übereinstimmung gelten sollen. Wenn Groß- und Kleinschreibung oder Leerzeichen am Anfang und Ende ignoriert werden sollen, verwenden Sie beim Erkennen und Löschen durchgehend denselben Normalisierungsausdruck, etwa lower(trim(semail)) für den Vergleich von E-Mail-Adressen.
Doppelte Werte und Zeilen finden
Führen Sie dieses kleine Beispiel aus, um zu sehen, wie eine Gruppierung nach der ausgewählten Namensspalte wiederholte Namen erkennt. Es veranschaulicht die Gruppierungsregel anhand der Beispieldatensätze, führt aber kein PostgreSQL-SQL aus.
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
from collections import Counter

students = [
    (1, "A", 15, "a@gmail.com"),
    (2, "A", 17, "ab@gmail.com"),
    (3, "B", 17, "b@gmail.com"),
    (4, "AB", 21, "ab@gmail.com"),
]
name_counts = Counter(student[1] for student in students)
for name, count in name_counts.items():
    if count > 1:
        print(f"{name}: {count}")
A: 2
Für die PostgreSQL-Abfrage zählen Sie doppelte Namen mit SELECT sname, count(*) AS occurrences FROM Student GROUP BY sname HAVING count(*) > 1;. Fügen Sie jede Vergleichsspalte sowohl der SELECT-Liste als auch der GROUP BY-Klausel hinzu, um doppelte Kombinationen zu erkennen. GROUP BY sname, sage findet beispielsweise wiederholte Kombinationen aus Name und Alter. HAVING filtert Gruppen, nachdem die Zeilen gruppiert wurden.
Um alle Zeilen aufzulisten, deren Name zu einer doppelten Gruppe gehört, verwenden Sie SELECT * FROM Student s WHERE (SELECT count(*) FROM Student m WHERE m.sname IS NOT DISTINCT FROM s.sname) > 1;. IS NOT DISTINCT FROM behandelt zwei Nullwerte bei Namen als Übereinstimmung. Diese korrelierte Zählung schließt daher alle Zeilen einer wiederholten Gruppe mit Nullnamen ebenso ein wie wiederholte, nicht-null Namen. Der Vergleich wird für jede Zeile wiederholt und gibt alle passenden Zeilen zurück, nicht nur eine Zusammenfassung pro Gruppe. Bei großen Tabellen kann auch die gruppierte Abfrage, zurückverknüpft mit Student, dazu dienen, die passenden Zeilen zu untersuchen.
Für eine Auswahl auf Zeilenebene verwenden Sie ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) und filtern in einer äußeren Abfrage mit rn > 1. PARTITION BY legt die Duplikatgruppen fest; die Sortierung bestimmt, welche Zeile die Nummer eins erhält. Ein Vergleich vollständiger Zeilen, der sid einschließt, kann in diesem Schema keine identischen Zeilen finden, weil der Primärschlüssel verhindert, dass zwei Zeilen denselben sid-Wert haben. Um stattdessen alle beschreibenden Werte zu vergleichen, gruppieren Sie nach sname, sage, semail; so erkennen Sie übereinstimmende Details, ohne den Bezeichner einzubeziehen.
Doppelte Zeilen in PostgreSQL sicher löschen
Prüfen Sie zuerst genau, welche Zeilen entfernt würden. Das folgende Muster behält in jeder Gruppe mit wiederholtem Namen den kleinsten sid-Wert und wählt die übrigen Zeilen aus: WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) SELECT s.* FROM Student s JOIN ranked r USING (sid) WHERE r.rn > 1;. Verwenden Sie in PARTITION BY die von Ihnen ausgewählten Duplikatspalten. Ändern Sie ORDER BY sid nur, wenn Sie eine dokumentierte Regel für den beizubehaltenden Datensatz haben. Die Sortierung nach einem Bezeichner ist deterministisch, beweist aber nicht, welcher Datensatz der neueste ist.
Nach der Prüfung der Vorschau lautet die entsprechende Löschabfrage WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) DELETE FROM Student s USING ranked r WHERE s.sid = r.sid AND r.rn > 1;. Die Verknüpfung über sid zielt nur auf die durch die Rangfolge ausgewählten Zeilen. Führen Sie Vorschau und Löschung, sofern praktikabel, in einer Transaktion aus und prüfen Sie die betroffenen Zeilen, bevor Sie die Transaktion bestätigen. Sichern Sie wichtige Daten oder verwenden Sie Ihr übliches Wiederherstellungsverfahren. Verwenden Sie keinen Self-Join, der nur nach dem Namen abgleicht und sid ungleich setzt: Damit können Zeilen mit demselben Namen, aber unterschiedlichen übrigen Werten gelöscht werden. Auch die Sortierung allein belegt nicht, welcher Datensatz der neueste ist.
Ergebnis überprüfen und erneute Duplikate verhindern
Wiederholen Sie die gruppierte Duplikatprüfung mit den vorgesehenen Vergleichsspalten. Für Namen sollte SELECT sname, count(*) FROM Student GROUP BY sname HAVING count(*) > 1; keine Gruppen mit doppelten Namen zurückgeben, wenn dies die Bereinigungsregel war. Prüfen Sie auch die verbleibenden Zeilen und stellen Sie sicher, dass die gewählte Regel zum Beibehalten eines Datensatzes die benötigten Daten erhalten hat.
Um künftige Duplikate zu verhindern, fügen Sie eine UNIQUE-Bedingung oder einen eindeutigen Index für die Spalten hinzu, die der tatsächlichen Regel entsprechen, zum Beispiel UNIQUE (semail), wenn jede nicht-null E-Mail-Adresse eindeutig sein muss. Prüfen und beheben Sie zuerst vorhandene Konflikte. Eindeutige Bedingungen in PostgreSQL lassen gewöhnlich mehrere Nullwerte zu. Wenn auch fehlende E-Mail-Adressen eindeutig sein müssen, legen Sie eine ausdrückliche Regel fest und setzen Sie sie entsprechend durch. Eine Bedingung für sname wäre ungeeignet, wenn verschiedene Studierende denselben Namen haben dürfen.
Fazit
Wählen Sie zuerst die Vergleichsspalten aus, untersuchen Sie die entstehenden Gruppen mit GROUP BY oder ROW_NUMBER() und stützen Sie das Löschen auf einen stabilen eindeutigen Schlüssel. Prüfen Sie die ausgewählten Zeilen vor dem Bestätigen einer destruktiven Änderung in der Vorschau und anschließend das Ergebnis. So wird klar festgelegt, was „Duplikat“ bedeutet, und gültige Datensätze bleiben geschützt.