HOWTO · PostgreSQL
PostgreSQL의 데이터베이스에서 중복 레코드 찾기 및 삭제
이 문서에서는 데이터베이스에서 중복 레코드를 찾은 다음 PostgreSQL에서 삭제하는 방법을 보여줍니다.
이 페이지의 내용
PostgreSQL에서 중복을 찾으려면 중복 여부를 결정하는 열을 기준으로 그룹화하고, 개수가 1보다 큰 그룹을 찾습니다. 중복 행을 안전하게 정리하려면 같은 그룹 안에서 ROW_NUMBER()를 사용해 순위를 매기고, 남길 행 뒤에 번호가 매겨진 행을 먼저 확인한 다음 sid 같은 안정적인 고유 키를 기준으로 삭제합니다. 어떤 열을 비교할지는 데이터 규칙에 따라 달라집니다. 이름이 같다고 해서 학생 레코드까지 중복인 것은 아닙니다.
PostgreSQL 중복 탐지 예제 스키마
이 글에서는 기본 키와 설명용 열 세 개가 있는 Student 테이블을 사용합니다. SQL 예제는 쿼리의 동작을 보여 주기 위한 것입니다. 구성된 실행 환경에서는 PostgreSQL 문을 실행하지 않으므로 데이터베이스 실행 결과를 제시하지 않습니다.
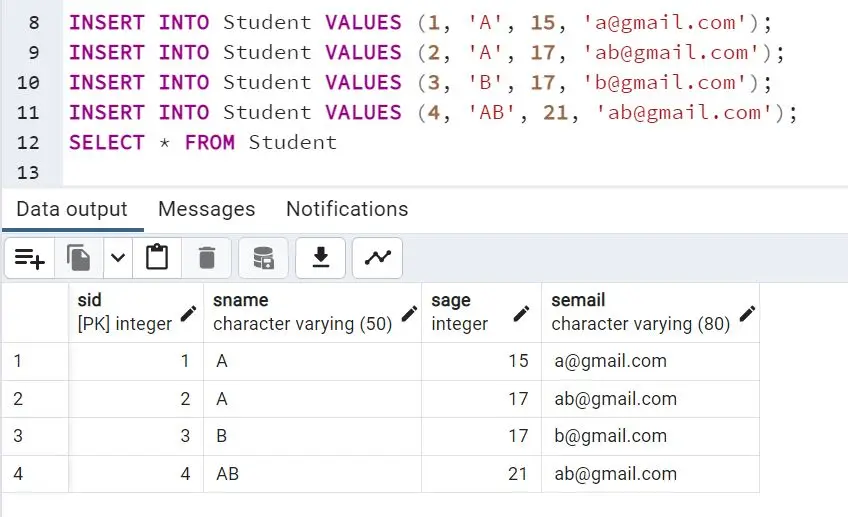
스키마는 CREATE TABLE Student (sid INT PRIMARY KEY, sname VARCHAR(50), sage INT, semail VARCHAR(80));입니다. 예제 행은 (1, 'A', 15, 'a@gmail.com'), (2, 'A', 17, 'ab@gmail.com'), (3, 'B', 17, 'b@gmail.com'), (4, 'AB', 21, 'ab@gmail.com')이며, Student (sid, sname, sage, semail)에 삽입됩니다.
sid는 기본 키이므로 고유합니다. 나머지 열은 중복될 수 있습니다. 예제에는 sname 값이 A인 행 두 개, sage 값이 17인 행 두 개, semail 값이 ab@gmail.com인 행 두 개가 있습니다. 표 상태 이미지는 제공된 예제 데이터를 보여 줍니다.
중복으로 볼 기준 정하기
쿼리를 실행하기 전에 먼저 데이터 규칙을 정하세요. 반복되는 이름을 찾으려면 sname을 비교하고, 반복되는 이메일 주소를 찾으려면 semail을 비교합니다. 이름과 나이가 모두 같은 조합을 찾으려면 sname과 sage를 함께 비교하세요. 행은 선택한 열의 값이 같은 경우에만 그 기준에서 중복입니다. 예를 들어 이름이 A인 두 행은 나이와 이메일이 다르므로 이름은 중복되지만 학생 정보 전체가 동일한 것은 아닙니다.
NULL 값과 텍스트 정규화도 같은 규칙에 맞춰 처리하세요. GROUP BY는 NULL 값들을 하나의 그룹으로 묶으므로, 누락된 값을 서로 일치하는 것으로 볼지 정해야 합니다. 대소문자나 앞뒤 공백을 무시하려면 이메일 비교에 lower(trim(semail))을 사용하는 것처럼 탐지와 삭제에서 동일한 정규화 식을 일관되게 적용하세요.
중복 값과 행 찾기
이 간단한 예제를 실행하면 이름 열을 기준으로 그룹화해 반복되는 이름을 찾는 방법을 확인할 수 있습니다. 예제는 샘플 행으로 그룹화 규칙을 설명하며 PostgreSQL SQL을 실행하지는 않습니다.
이 섹션의 코드와 표시되는 레이블 또는 출력은 영어로 유지됩니다.
from collections import Counter

students = [
    (1, "A", 15, "a@gmail.com"),
    (2, "A", 17, "ab@gmail.com"),
    (3, "B", 17, "b@gmail.com"),
    (4, "AB", 21, "ab@gmail.com"),
]
name_counts = Counter(student[1] for student in students)
for name, count in name_counts.items():
    if count > 1:
        print(f"{name}: {count}")
A: 2
PostgreSQL 쿼리에서 중복 이름을 세려면 SELECT sname, count(*) AS occurrences FROM Student GROUP BY sname HAVING count(*) > 1;을 사용합니다. 중복 조합을 찾으려면 비교할 각 열을 SELECT 목록과 GROUP BY 절에 모두 추가하세요. 예를 들어 GROUP BY sname, sage는 이름과 나이가 같은 조합을 찾습니다. HAVING은 행을 그룹화한 뒤 조건에 맞는 그룹을 걸러 냅니다.
중복 그룹에 속한 행을 모두 보려면 SELECT * FROM Student s WHERE (SELECT count(*) FROM Student m WHERE m.sname IS NOT DISTINCT FROM s.sname) > 1;을 사용하세요. IS NOT DISTINCT FROM은 두 이름이 모두 NULL이면 서로 일치하는 것으로 처리합니다. 따라서 이 상관 개수 쿼리는 반복되는 일반 이름뿐 아니라 NULL 이름이 반복되는 그룹의 모든 행도 포함합니다. 각 행마다 비교를 반복하므로 그룹별 요약 하나가 아니라 조건에 맞는 행을 모두 반환합니다. 큰 테이블에서는 그룹화 쿼리 결과를 Student와 조인해 일치하는 행을 살펴볼 수도 있습니다.
행 단위로 선택하려면 ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid)를 사용하고 바깥 쿼리에서 rn > 1인 행을 고르세요. PARTITION BY는 중복 그룹을 정하고 정렬 순서는 어떤 행이 1번이 될지 결정합니다. 이 스키마에서 sid를 포함해 전체 행을 비교하면 기본 키 때문에 동일한 행을 찾을 수 없습니다. 식별자를 제외하고 설명용 값 전체를 비교하려면 sname, sage, semail로 그룹화하세요. 이렇게 하면 식별자가 달라도 설명용 정보가 모두 같은 행을 찾습니다.
PostgreSQL에서 중복 행 안전하게 삭제하기
먼저 삭제 대상이 될 행을 정확히 확인하세요. 다음 패턴은 이름이 반복되는 각 그룹에서 가장 작은 sid를 남기고 나머지를 선택합니다. WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) SELECT s.* FROM Student s JOIN ranked r USING (sid) WHERE r.rn > 1;. PARTITION BY에는 정한 중복 기준 열을 사용하세요. 문서화된 생존 규칙이 있는 경우에만 ORDER BY sid를 바꾸세요. 식별자 순서는 결정적이지만, 어느 행이 최신인지를 증명하지는 않습니다.
미리보기 결과를 검토한 뒤 이에 대응하는 삭제 쿼리를 실행할 수 있습니다. WITH ranked AS (SELECT sid, ROW_NUMBER() OVER (PARTITION BY sname ORDER BY sid) AS rn FROM Student) DELETE FROM Student s USING ranked r WHERE s.sid = r.sid AND r.rn > 1;. sid 조인은 순위 계산에서 선택된 행만 대상으로 합니다. 가능하면 미리보기와 삭제를 트랜잭션 안에서 실행하고, 커밋 전에 영향을 받은 행을 확인하세요. 중요한 데이터라면 백업을 만들거나 일반적인 복구 절차를 따르세요. 이름만으로 조인하고 sid에 부등호 조건을 적용하는 방식은 사용하지 마세요. 다른 값이 달라도 이름이 같은 행을 삭제할 수 있으며, 정렬 순서만으로 최신 행을 판별할 수도 없습니다.
결과 확인 및 재발 방지
의도한 비교 열을 사용해 중복 그룹 쿼리를 다시 실행하세요. 이름을 기준으로 정리했다면 SELECT sname, count(*) FROM Student GROUP BY sname HAVING count(*) > 1;에서 중복 이름 그룹이 반환되지 않아야 합니다. 남은 행도 살펴보고 선택한 생존 규칙이 필요한 데이터를 보존했는지 확인하세요.
앞으로의 중복을 막으려면 실제 데이터 규칙에 맞는 열에 UNIQUE 제약 조건이나 고유 인덱스를 추가하세요. 예를 들어 NULL이 아닌 이메일 주소가 각각 고유해야 한다면 UNIQUE (semail)을 사용할 수 있습니다. 먼저 기존 충돌을 확인하고 해결하세요. PostgreSQL의 고유 제약 조건은 일반적으로 여러 NULL 값을 허용합니다. 이메일 누락 값도 고유해야 한다면 명시적인 정책을 정하고 그에 맞게 적용하세요. 서로 다른 학생이 같은 이름을 가질 수 있다면 sname에 제약 조건을 두는 것은 적절하지 않습니다.
결론
먼저 비교할 열을 정하고 GROUP BY 또는 ROW_NUMBER()로 해당 그룹을 살펴본 뒤, 안정적인 고유 키를 기준으로 삭제하세요. 데이터를 변경하는 작업을 커밋하기 전에 선택된 행을 미리 확인하고 결과를 검증하세요. 이렇게 하면 ‘중복’의 기준을 분명히 하고 유효한 레코드를 보호하는 데 도움이 됩니다.