HOWTO · R
R의 정규 분포
이 튜토리얼은 R에서 정규 분포를 수행하고 플롯하는 방법을 보여줍니다.
이 페이지의 내용
정규 분포는 데이터가 어떻게 분포되어 있는지 보여주는 확률 함수입니다. 정규분포는 실제 사례 시나리오에서 많은 이점을 제공하기 때문에 통계에서 사용되는 가장 중요한 확률 분포 방법 중 하나입니다.
이 튜토리얼은 R에서 정규 분포를 수행하고 플롯하는 방법을 보여줍니다.
R의 정규 분포
기본 R에는 정규 분포를 수행하는 데 사용되는 네 가지 기본 제공 함수가 있습니다.
dnorm(x, mean, sd)
pnorm(x, mean, sd)
qnorm(p, mean, sd)
rnorm(n, mean, sd)
어디:
x= 숫자 벡터p= 확률 벡터n= 관찰 수평균= 샘플 데이터의 평균값sd= 표준편차
평균의 기본값은 0이고 sd의 기본값은 1입니다. 함수를 하나씩 정의하고 해결해 봅시다.
R의 dnorm(x, 평균, sd)
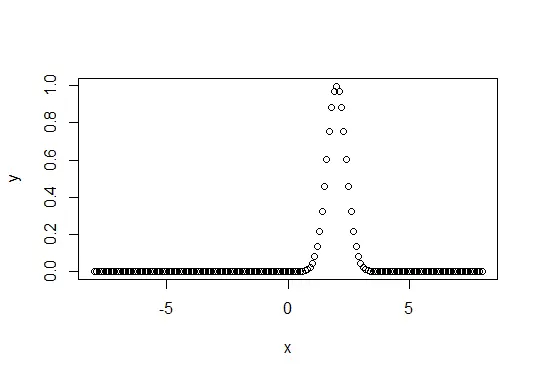
dnorm()은 주어진 표준 편차와 평균으로 각 포인트에 대한 확률 분포의 높이를 얻는 데 사용됩니다. R에서 예를 들어보자.
# a sequence of numbers between -8 and 8 incrementing by 0.1.
# it will passed to dnorm as x
x <- seq(-8, 8, by = .1)

# we chose mean as 2 and standard deviation as 0.4.
y <- dnorm(x, mean = 2, sd = 0.4)

plot(x,y)
위의 코드는 주어진 시퀀스에 대해 평균 2 및 sd 0.4와 함께 dnorm을 사용하여 정규 분포를 플로팅합니다. 출력 플롯을 참조하십시오.
R의 pnorm(x, 평균, sd)
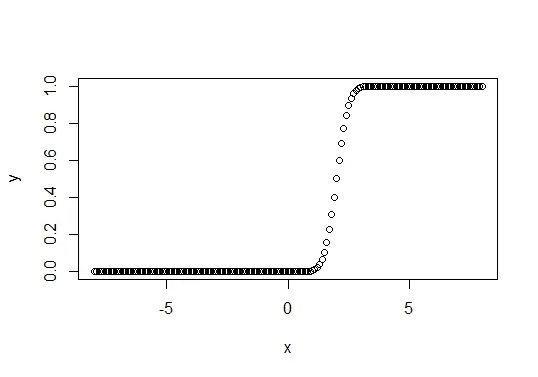
pnorm()은 주어진 숫자보다 작은 정규 분포 숫자의 확률을 얻는 데 사용됩니다. 이 함수는 누적 분포 함수라고도 합니다.
예를 들어 보겠습니다.
# a sequence of numbers between -8 and 8 incrementing by 0.1.
# it will passed to pnorm as x
x <- seq(-8, 8, by = .1)

# we chose mean as 2 and standard deviation as 0.4.
y <- pnorm(x, mean = 2, sd = 0.4)

plot(x,y)
위의 코드는 주어진 시퀀스에 대해 평균 2 및 sd 0.4와 함께 pnorm을 사용하여 정규 분포를 플로팅합니다. 출력 플롯을 참조하십시오.
R의 qnorm(p, 평균, sd)
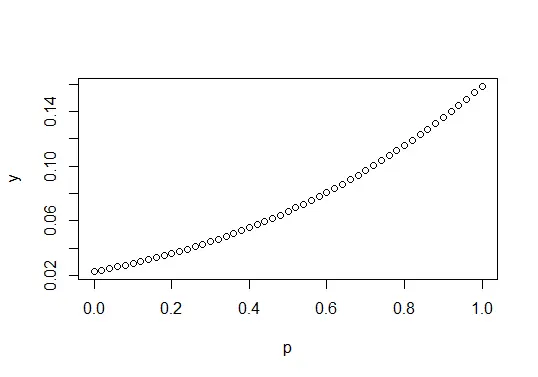
qnorm은 확률 값을 취하고 주어진 확률 값과 유사한 누적 값을 가진 숫자를 반환합니다. 예를 참조하십시오:
# sequence of probability values incrementing by 0.01.
# it will be passed to pnorm as x
p <- seq(0, 1, by = 0.02)

# we chose mean as 2 and standard deviation as 1.
y <- pnorm(p, mean = 2, sd = 1)

plot(p,y)
위의 코드는 주어진 확률 시퀀스에 대해 평균 2 및 sd 2와 함께 qnorm을 사용하여 정규 분포를 플로팅합니다. 출력 플롯을 참조하십시오.
R의 ‘정상(n, 평균, sd)’
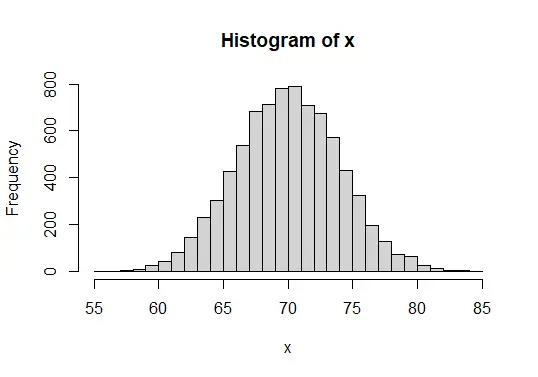
rnorm은 분포가 정상인 난수를 생성하는 데 사용됩니다. 숫자를 입력으로 사용하고 그와 동일한 난수를 생성합니다. 예를 들어 보겠습니다.
# vector of 8000 random numbers with mean 70 and standard deviation 4

x <- rnorm(8000, mean=70, sd=4)

# histogram with 40 bars
hist(x, breaks=40)
위의 코드는 mean이 70이고 sd가 4인 8000개의 난수를 사용하여 rnorm 확률 분포의 히스토그램을 보여줍니다. 출력 보기: