HOWTO · R
R의 T 분포
이 튜토리얼은 R에서 t-분포를 수행하는 방법을 보여줍니다.
이 페이지의 내용
t-분포는 표본 크기가 작고 표준 편차를 알 수 없는 정규 분포 모집단을 표본으로 추출하는 데 사용되는 확률 분포입니다. 이 튜토리얼은 R에서 t-분포를 수행하는 방법을 보여줍니다.
R의 스튜던트 T 분포
일반적으로 학생의 t-분포로 알려진 t-분포에는 dt, pt 및 qt와 같이 다양한 t-분포 작업을 수행하는 여러 기능이 있습니다.
dt()가 주어진 무작위 변수를 사용하여 t-분포의 PDF의 확률 밀도 함수를 찾는 데 사용되는 경우 두 개의 매개변수, 하나는 분위수 벡터이고 다른 하나는 자유도입니다. 구문은 dt(x, df)입니다.
pt() 함수는 t-분포의 CDF 누적 분포 함수를 가져옵니다.
첫 번째는 Quantile 벡터, 두 번째는 자유도, 세 번째는 lower.trail이며 true 또는 false일 수 있습니다. 구문은 pt(q, df, lower.tail = TRUE)입니다.
qt() 함수는 t-분포의 역 누적 밀도 함수를 가져옵니다.
세 가지 매개변수를 사용합니다. 첫 번째는 확률 벡터, 두 번째는 자유도, 세 번째는 lower.trail입니다. 구문은 qt(p, df, lower.tail = TRUE)입니다.
다음은 R에서 학생 t-분포를 수행하는 단계별 프로세스입니다.
-
먼저 자유도를 설정합니다.
-
다음은 스튜던트 t-분포에 대한 밀도 함수를 플로팅하는 것입니다.
-
밀도 함수를 플로팅하려면 먼저 벡터 분위수를 만든 다음
dt()메서드를 사용하여 t-분포 값을 찾고 마지막으로 값을 사용하여 학생 t-분포에 대한 밀도 함수를 플로팅합니다. -
이제
pt()메서드를 사용하여 t-분포의 누적 분포 함수를 구하고qt()함수를 사용하여 t-분포의 역 누적 밀도 함수를 구합니다.
이제 프로세스를 알았으면 R에서 학생 t-분포를 구현해 봅시다. x=1 및 자유도 50에서 t-분포의 값을 찾아봅시다.
예를 참조하십시오:
# value of t-distribution probality density function at x=1 and df = 50
dt(x = 1, df = 50)
위의 코드는 x=1 및 df = 50에서 t-분포 확률 밀도 함수의 값을 보여줍니다. 출력 참조:
[1] 0.2395711
이제 pt() 메서드를 사용하여 t-분포의 p-값과 신뢰 구간을 구해 보겠습니다. 예를 참조하십시오:
# area to the right of a t-statistic with the value of 3.1 quantile and 30 degrees of freedom
pt(q = 3.1, df = 30, lower.tail = FALSE)
위의 코드는 pt 메서드를 사용하여 3.1 분위수 및 30 자유도 값을 갖는 t-통계량의 오른쪽 영역을 찾습니다. 출력 참조:
[1] 0.002092242
우리는 여기서 단측 p-값이 0.2%임을 발견했습니다. 양면 50% 신뢰 구간을 구성하려면 qt() 함수를 사용하여 50% 신뢰도에 대한 t-점수 및 t-값을 찾을 수 있습니다.
# value in each tail is 0.2% and confidence is 50%, we will find 0.2th percentile of t-distribution with 30 degrees of freedom
qt(p = 0.002, df = 30, lower.tail = TRUE)
qt는 신뢰 구간 50%에 대한 임계 값으로 사용할 수 있는 t-값을 찾습니다. 출력 참조:
[1] -3.117682
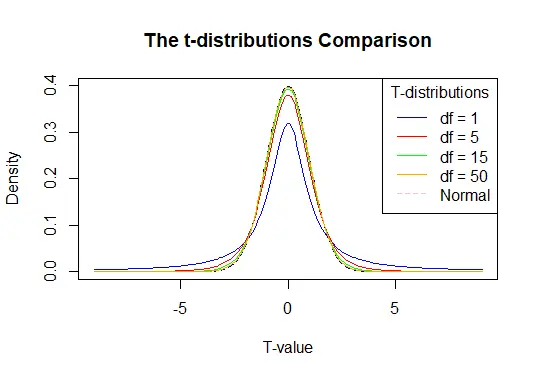
이제 자유도가 다른 확률 밀도 함수를 비교해 봅시다. 자유도가 클수록 플롯이 정규 분포에 가까워지기 때문에 그렇게 합니다.
예를 참조하십시오:
# vector of 200 values between -9 and 9
a <- seq(-9, 9, length = 200)

# Degrees of freedom with maximum 50 degrees
df = c(1,5,15,50)

#plot line colors
colour = c("blue", "red", "green", "orange","pink")

# the normal distribution
plot(a, dnorm(a), type = "l", lty = 2, xlab = "T-value", ylab = "Density",
     main = "The t-distributions Comparison", col = "darkblue")

# Adding t-distributions to the plot
for (i in 1:4){
  lines(a, dt(a, df[i]), col = colour[i])
}

# Adding legend
legend("topright", c("df = 1", "df = 5", "df = 15", "df = 50", "Normal"),
       col = colour, title = "T-distributions", lty = c(1,1,1,1,2))
위의 코드는 자유도가 다른 t-분포에 대한 비교 플롯을 보여줍니다. 줄거리 보기: