
HOWTO · Matplotlib
Matplotlib 밀도 플롯
Python을 사용하여 밀도 플롯을 생성하려면 먼저 scipy.stats 모듈의 gaussian_kde() 메서드를 사용하여 주어진 데이터에서 밀도 함수를 추정 한 다음 밀도 함수를 플로팅하여 밀도 플롯을 생성합니다.
이 페이지의 내용
밀도 플롯은 1차원 표본 데이터가 어떻게 분포되어 있는지를 매끄럽게 추정한 결과를 보여 줍니다. Python에서는 일반적으로 커널 밀도 추정(KDE)을 사용합니다. scipy.stats 모듈의 gaussian_kde()로 관측값에서 밀도 함수를 추정하고, x 값 격자에서 평가한 다음 Matplotlib로 결과 곡선을 그립니다. seaborn 패키지의 kdeplot()을 사용하거나 pandas.DataFrame.plot()에서 kind="density"를 설정하면 더 적은 코드로 같은 결과를 얻을 수 있습니다. 아래 예제는 NumPy, SciPy, Matplotlib를 사용하며, Seaborn과 pandas 변형에는 해당 패키지도 설치되어 있어야 하고, pandas 플롯은 내부적으로 gaussian_kde를 호출하므로 SciPy가 필요합니다.
scipy.stats.gaussian_kde로 밀도 플롯 만들기
gaussian_kde는 가우시안 형태의 작은 커널을 각 관측값 위에 놓고 이 커널들의 평균을 내어 추정치를 만듭니다. 결과는 호출 가능한 밀도 함수로, x 위치 격자를 전달하면 각 위치의 추정 밀도를 반환하며 바로 이 값이 Matplotlib이 그리는 선입니다.
먼저 표본에 추정치를 적합한 다음 격자에서 평가합니다.
이 섹션의 코드와 실행 출력, 그리고 그래프에 표시되는 제목과 축 레이블은 영어로 유지됩니다.
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data)
x = np.linspace(-2, 10, 300)
y = density(x)

print(f"Peak estimated density: {y.max():.4f} at x = {x[np.argmax(y)]:.2f}")
Peak estimated density: 0.2635 at x = 3.14
이 프로그램은 18개 표본 값으로 gaussian_kde 추정치를 만들고 -2와 10 사이에 균등하게 배치된 300개 위치에서 추정치를 계산합니다. 추정치는 대부분의 관측값이 모여 있는 x = 3 근처에서 최고점에 도달합니다. 격자는 예를 들어 최솟값보다 조금 낮은 지점에서 최댓값보다 조금 높은 지점까지, 사용 중인 데이터 범위에 맞게 선택하세요. 여기서 사용한 -2~10 범위는 이 표본에만 적합합니다.
아래 플로팅 스크립트는 디스플레이 연결 여부와 관계없이 동일하게 실행되도록 Matplotlib의 비대화형 Agg 백엔드를 고정하고, 첫 실행 시 나타날 수 있는 글꼴 관련 메시지가 표준 오류에 출력되지 않도록 라이브러리 로깅을 억제합니다. 어떤 백엔드가 선택되는지 확인하려면 다음을 실행하세요.
import logging
import matplotlib
matplotlib.use("Agg")
logging.getLogger("matplotlib").setLevel(logging.ERROR)
import matplotlib.pyplot as plt

print("Backend:", matplotlib.get_backend())
Backend: Agg
이제 전체 스크립트로 계산된 곡선을 그려 보겠습니다.
import logging
import matplotlib
matplotlib.use("Agg")
logging.getLogger("matplotlib").setLevel(logging.ERROR)
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data)
x = np.linspace(-2, 10, 300)
y = density(x)

plt.plot(x, y)
plt.title("Density Plot of the data")
plt.xlabel("Value")
plt.ylabel("Estimated density")

print("Plotted", len(plt.gca().get_lines()), "density line")
Plotted 1 density line
plt.plot()은 추정 밀도를 현재 축에 하나의 선으로 그리고, plt.gca().get_lines()는 추가된 선 하나를 반환합니다. 대화형 세션에서는 matplotlib.use("Agg") 호출을 생략하고 플로팅 호출 뒤에 plt.show()를 추가하여 그림 창을 열 수 있습니다.
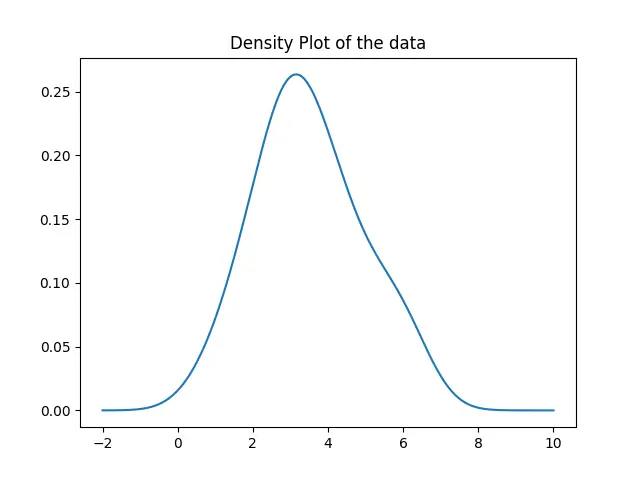
렌더링된 곡선은 추정 밀도로, 관측값이 집중된 곳에서는 높고 드문 곳에서는 낮습니다. 추정치이므로 곡선의 형태는 실제 분포의 측정값이 아니라 이 표본을 보여 주는 하나의 관점으로 해석하세요.
KDE 대역폭 조정
대역폭은 추정치를 얼마나 부드럽게 만들지 제어합니다. 대역폭이 크면 각 커널이 넓어져 실제 구조를 가릴 수 있는 더 평탄하고 매끄러운 곡선이 만들어지고, 대역폭이 작으면 커널이 좁아져 곡선이 표본을 가깝게 따라가며 이 데이터 세트에서만 나타나는 노이즈성 굴곡을 보일 수 있습니다. 기본적으로 gaussian_kde는 Scott 규칙으로 대역폭을 선택합니다. "scott" 또는 "silverman"을 명시적으로 전달하거나, 데이터의 퍼짐을 기준으로 커널 너비를 설정하는 bw_method 인수에 스칼라를 지정할 수도 있습니다. 추정기를 만든 뒤에도 공개 set_bandwidth() 메서드로 같은 조정을 적용할 수 있으므로 비공개 헬퍼를 호출할 필요가 없습니다.
이 섹션의 코드와 실행 출력, 그리고 그래프에 표시되는 제목과 축 레이블은 영어로 유지됩니다.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data, bw_method=0.25)
x = np.linspace(-2, 10, 300)
y = density(x)

plt.plot(x, y)
plt.title("Density Plot with a smaller bandwidth")
plt.xlabel("Value")
plt.ylabel("Estimated density")

print(f"Peak estimated density: {y.max():.4f}")
Peak estimated density: 0.3913
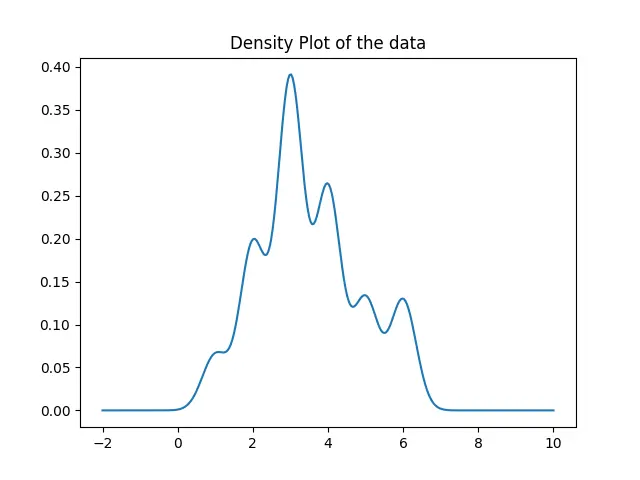
bw_method=0.25에서는 각 커널이 기본값보다 좁아지므로 곡선이 최고점에서 더 높아지고 표본의 군집을 더 밀접하게 따라갑니다. 더 부드럽게 하려면 값을 높이고 덜 부드럽게 하려면 낮추세요. 특정 대역폭 하나를 모든 경우에 옳다고 보지 말고 곡선 형태를 비교하세요.
Seaborn으로 밀도 플롯 만들기
seaborn는 같은 아이디어를 한 번의 호출로 처리합니다. kdeplot()은 내부적으로 밀도를 추정하여 Matplotlib 축에 그립니다. x로 표본을 전달하고 bw_adjust로 자동 선택된 대역폭의 크기를 조정합니다. 1보다 큰 값은 더 부드럽게, 1보다 작은 값은 덜 부드럽게 만듭니다. 이전 distplot() 함수는 더 이상 사용되지 않습니다. 곡선만 필요하면 kdeplot()을, 그림 수준 변형이 필요하면 displot(kind="kde")를 사용하세요.
이 섹션의 코드와 실행 출력, 그리고 그래프에 표시되는 제목과 축 레이블은 영어로 유지됩니다.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import seaborn as sns

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
ax = sns.kdeplot(x=data, bw_adjust=0.5)
ax.set_title("Density Plot of the data")
ax.set_xlabel("Value")

print("kdeplot drew", len(ax.get_lines()), "density line")
kdeplot drew 1 density line
kdeplot은 그림을 그린 Matplotlib Axes를 반환하므로 일반적인 축 메서드로 제목과 레이블을 적용할 수 있습니다. 대화형으로 그림 창을 표시하려면 plt.show()를 추가하세요.
pandas로 밀도 플롯 만들기
표본이 이미 DataFrame 또는 Series에 들어 있다면 pandas.DataFrame.plot로 곡선을 바로 만들 수 있습니다. kind="density"를 전달하세요(kind="kde" 별칭도 사용할 수 있습니다). pandas는 gaussian_kde로 추정치를 계산하므로 이 플롯 유형에는 SciPy가 설치되어 있어야 합니다.
이 섹션의 코드와 실행 출력, 그리고 그래프에 표시되는 제목과 축 레이블은 영어로 유지됩니다.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
df = pd.DataFrame(data, columns=["value"])
ax = df.plot(kind="density")
ax.set_title("Density Plot of the data")
ax.set_xlabel("Value")

print("pandas labeled the axis:", ax.get_ylabel())
pandas labeled the axis: Density
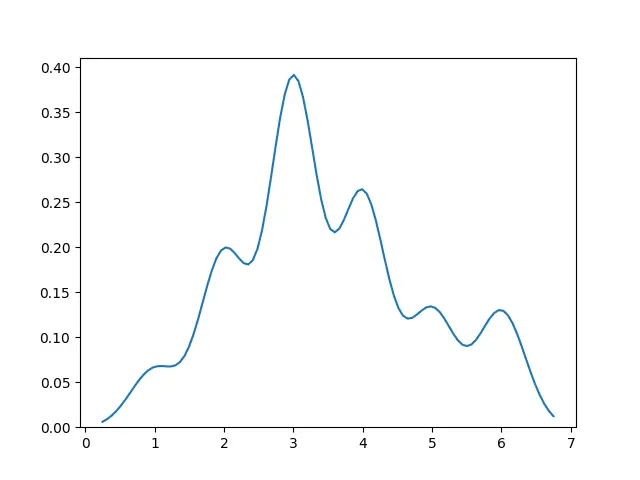
이 메서드를 DataFrame에 대해 호출하면 열당 하나의 곡선이 그려지고 y축 레이블이 자동으로 Density로 지정됩니다. 이름이 있는 변수 하나를 표시하려면 단일 Series에서 호출하세요. SciPy 방식과 마찬가지로 곡선의 매끄러움은 pandas가 데이터에서 도출한 추정기의 대역폭을 따릅니다.
