
HOWTO · Matplotlib
Matplotlib-Dichte-Plot
Um ein Dichtediagramm mit Python zu erzeugen, schätzen wir zunächst die Dichtefunktion aus den gegebenen Daten mit der `gaussian_kde()` Methode aus dem `scipy.stats` Modul und zeichnen dann die Dichtefunktion auf, um das Dichtediagramm zu erzeugen.
Auf dieser Seite
Ein Dichtediagramm zeigt eine geglättete Schätzung der Verteilung eindimensionaler Stichprobendaten. In Python ist der übliche Weg die Kerndichteschätzung (KDE): Schätzen Sie mit gaussian_kde() aus dem Modul scipy.stats eine Dichtefunktion aus den Beobachtungen, werten Sie sie auf einem Gitter von x-Werten aus und zeichnen Sie die resultierende Kurve mit Matplotlib. Zum gleichen Ergebnis gelangen Sie mit weniger Code über kdeplot() aus dem Paket seaborn oder indem Sie kind="density" in pandas.DataFrame.plot() setzen. Die folgenden Beispiele verwenden NumPy, SciPy und Matplotlib; die Seaborn- und pandas-Varianten benötigen zusätzlich die jeweiligen Pakete, und der pandas-Plot erfordert SciPy, weil er intern gaussian_kde aufruft.
Ein Dichtediagramm mit scipy.stats.gaussian_kde erzeugen
gaussian_kde erstellt die Schätzung, indem es auf jede Beobachtung einen Kernel setzt – einen kleinen Buckel in Form einer Gaußkurve – und die Buckel mittelt. Das Ergebnis ist eine aufrufbare Dichtefunktion: Übergeben Sie ihr ein Gitter von x-Positionen, und sie liefert die geschätzte Dichte an jeder Position – genau die Linie, die Matplotlib zeichnet.
Passen Sie zunächst die Schätzung an die Stichprobe an und werten Sie sie auf einem Gitter aus:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data)
x = np.linspace(-2, 10, 300)
y = density(x)

print(f"Peak estimated density: {y.max():.4f} at x = {x[np.argmax(y)]:.2f}")
Peak estimated density: 0.2635 at x = 3.14
Das Programm passt gaussian_kde an die 18 Stichprobenwerte an und wertet die Schätzung an 300 gleichmäßig verteilten Positionen zwischen -2 und 10 aus; die Schätzung erreicht ihr Maximum nahe x = 3, wo sich die meisten Beobachtungen häufen. Wählen Sie das Gitter aus dem Wertebereich Ihrer eigenen Daten, etwa von etwas unterhalb des Minimums bis etwas oberhalb des Maximums; das Fenster von -2 bis 10 passt hier nur zu dieser Stichprobe.
Das folgende Plot-Skript legt Matplotlibs nicht-interaktives Agg-Backend fest, damit es mit und ohne angeschlossene Anzeige identisch läuft, und unterdrückt das Logging der Bibliothek, damit eine Schriftmeldung beim ersten Lauf nicht in der Standardfehlerausgabe landet. Führen Sie Folgendes aus, um zu sehen, welches Backend ausgewählt ist:
import logging
import matplotlib
matplotlib.use("Agg")
logging.getLogger("matplotlib").setLevel(logging.ERROR)
import matplotlib.pyplot as plt

print("Backend:", matplotlib.get_backend())
Backend: Agg
Zeichnen Sie nun die ausgewertete Kurve mit dem vollständigen Skript:
import logging
import matplotlib
matplotlib.use("Agg")
logging.getLogger("matplotlib").setLevel(logging.ERROR)
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data)
x = np.linspace(-2, 10, 300)
y = density(x)

plt.plot(x, y)
plt.title("Density Plot of the data")
plt.xlabel("Value")
plt.ylabel("Estimated density")

print("Plotted", len(plt.gca().get_lines()), "density line")
Plotted 1 density line
plt.plot() zeichnet die geschätzte Dichte als eine Linie auf die aktuellen Achsen, und plt.gca().get_lines() meldet die einzelne hinzugefügte Linie. In einer interaktiven Sitzung können Sie den Aufruf matplotlib.use("Agg") weglassen und nach den Plot-Aufrufen plt.show() ergänzen, um das Figuren-Fenster zu öffnen.
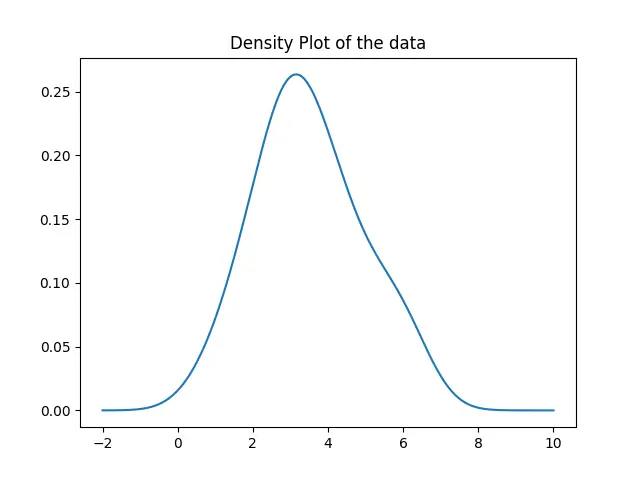
Die gezeichnete Kurve ist die geschätzte Dichte: höher dort, wo Beobachtungen konzentriert sind, niedriger dort, wo sie spärlich auftreten. Da es sich um eine Schätzung handelt, sollten Sie ihre Form als Ansicht dieser Stichprobe betrachten und nicht als Messung der wahren Verteilung.
Die KDE-Bandbreite anpassen
Die Bandbreite steuert, wie stark die Schätzung geglättet wird. Eine große Bandbreite verbreitert jeden Kernel und erzeugt eine flachere, glattere Kurve, die reale Strukturen verdecken kann; eine kleine Bandbreite verschmälert die Kernel, sodass die Kurve der Stichprobe eng folgt und möglicherweise Zacken zeigt, die in diesem konkreten Datensatz nur Rauschen sind. Standardmäßig wählt gaussian_kde die Bandbreite nach der Scott-Regel; Sie können auch explizit "scott" oder "silverman" übergeben oder über das Argument bw_method einen Skalar angeben, der die Kernelbreite relativ zur Streuung der Daten festlegt. Dieselbe Anpassung ist später über die öffentliche Methode set_bandwidth() möglich, sodass keine privaten Hilfsfunktionen aufgerufen werden müssen.
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import gaussian_kde

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
density = gaussian_kde(data, bw_method=0.25)
x = np.linspace(-2, 10, 300)
y = density(x)

plt.plot(x, y)
plt.title("Density Plot with a smaller bandwidth")
plt.xlabel("Value")
plt.ylabel("Estimated density")

print(f"Peak estimated density: {y.max():.4f}")
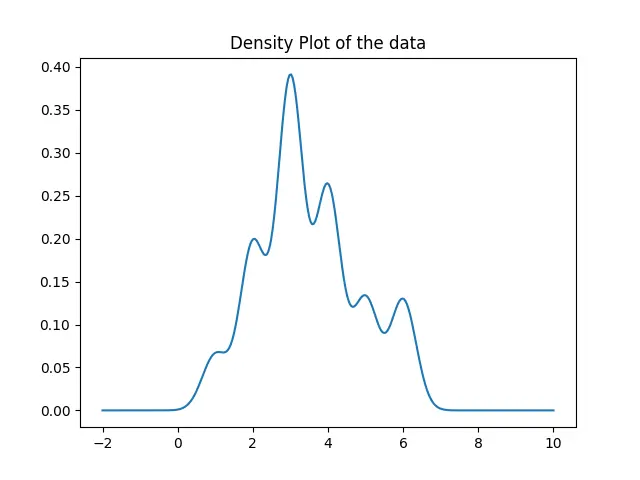
Peak estimated density: 0.3913
Mit bw_method=0.25 ist jeder Kernel schmaler als im Standard, sodass die Kurve an ihrem Gipfel höher ansteigt und der Häufung der Stichprobe enger folgt. Erhöhen Sie den Wert für stärkere Glättung, verringern Sie ihn für schwächere Glättung, und vergleichen Sie die Kurvenformen, statt eine einzelne Bandbreite als allgemein richtig anzusehen.
Ein Dichtediagramm mit Seaborn erzeugen
seaborn packt dieselbe Idee in einen einzigen Aufruf: kdeplot() schätzt die Dichte intern und zeichnet sie auf ein Matplotlib-Achsenobjekt. Übergeben Sie die Stichprobe über x und skalieren Sie die automatisch gewählte Bandbreite mit bw_adjust – Werte über 1 glätten stärker, Werte unter 1 glätten weniger. Die ältere Funktion distplot() ist veraltet; verwenden Sie kdeplot() für die Kurve allein oder displot(kind="kde") für die Variante auf Figuren-Ebene.
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import seaborn as sns

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
ax = sns.kdeplot(x=data, bw_adjust=0.5)
ax.set_title("Density Plot of the data")
ax.set_xlabel("Value")

print("kdeplot drew", len(ax.get_lines()), "density line")
kdeplot drew 1 density line
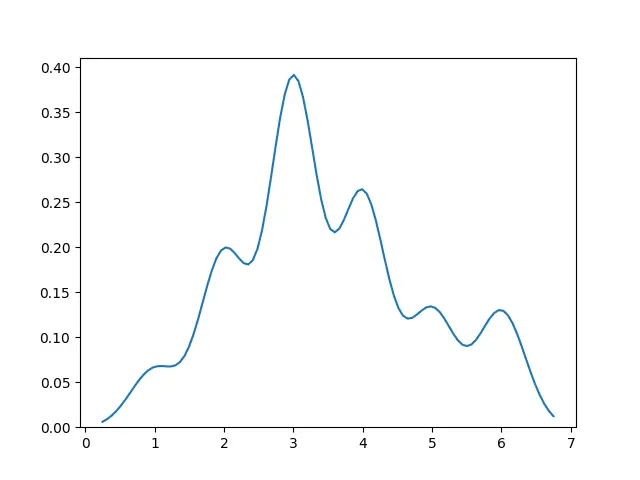
kdeplot gibt das Matplotlib-Axes-Objekt zurück, auf das es gezeichnet hat; Titel und Beschriftungen werden daher mit den üblichen Achsenmethoden gesetzt. Ergänzen Sie plt.show(), um das Figuren-Fenster interaktiv anzuzeigen.
Ein Dichtediagramm mit pandas erzeugen
Liegt die Stichprobe bereits in einem DataFrame oder einer Series vor, kann pandas.DataFrame.plot die Kurve direkt erzeugen: Übergeben Sie kind="density" (der Alias kind="kde" funktioniert ebenfalls). pandas berechnet die Schätzung mit gaussian_kde, sodass SciPy für diesen Plot-Typ installiert sein muss.
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt
import pandas as pd

data = [2, 3, 3, 4, 2, 1, 5, 6, 4, 3, 3, 3, 6, 4, 5, 4, 3, 2]
df = pd.DataFrame(data, columns=["value"])
ax = df.plot(kind="density")
ax.set_title("Density Plot of the data")
ax.set_xlabel("Value")

print("pandas labeled the axis:", ax.get_ylabel())
pandas labeled the axis: Density
Auf einem DataFrame aufgerufen, zeichnet die Methode eine Kurve pro Spalte und beschriftet die y-Achse automatisch mit Density; rufen Sie sie auf einer einzelnen Series für eine benannte Variable auf. Wie beim SciPy-Ansatz folgt die Glätte der Bandbreite des Schätzers, die pandas aus den Daten ableitet.
