
HOWTO · Python
Daten in Python glätten
Dieses Tutorial zeigt, wie man eine Kurve in einem Graphen in Python glättet
Auf dieser Seite
Glätten kann eine verrauschte eindimensionale Reihe in einem Plot leichter prüfbar machen. Es verändert jedoch die Werte und kann echte Spitzen, Stufen oder kurzlebige Änderungen verbergen; behandeln Sie eine geglättete Kurve als eine Ansicht der Daten und nicht als Validierung oder Ersatz für die Beobachtungen. Python bietet mehrere Ansätze, und die richtige Wahl hängt davon ab, ob Ihre Stichproben gleichmäßig verteilt sind, ob Sie eine kausale Schätzung benötigen und wie viel lokales Detail wichtig ist.
Die folgenden Beispiele verwenden eine reproduzierbare verrauschte Sinuswelle, damit ihre Roh- und geglätteten Linien verglichen werden können. Die Ausgabe-Fences zeigen die kurzen Zusammenfassungszeilen, die von drei Beispielen ausgegeben werden; jedes Skript erstellt auch einen Plot mit beiden Reihen. Installieren Sie die genannten Pakete in Ihrer Umgebung, bevor Sie ein Beispiel ausführen, das sie verwendet.
Verwenden Sie den Savitzky-Golay-Filter, um Daten in Python zu glätten
Der Savitzky-Golay-Filter passt ein Polynom niedrigen Grades an jedes lokale Fenster nach der Methode der kleinsten Quadrate an und verwendet dann den angepassten Wert in dessen Mitte. Dies kann die Form und Amplitude breiter Merkmale besser erhalten als ein einfacher Durchschnitt, sofern das Fenster für diese Merkmale geeignet ist. Er ist als Funktion scipy.signal.savgol_filter verfügbar.
window_length ist eine positive ungerade Anzahl von Stichproben, und polyorder muss kleiner als die Fensterlänge sein. Vergrößern Sie das Fenster, um aggressiver zu glätten; erhöhen Sie die Polynomordnung nur, wenn die lokale Form des Signals es rechtfertigt. Ein Fenster, das eine schmale Spitze überspannt, kann sie abflachen. Dieses Beispiel benötigt NumPy, SciPy und Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
from scipy.signal import savgol_filter

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
smoothed = savgol_filter(raw, window_length=9, polyorder=2)
print(f"Smoothed samples: {len(smoothed)}")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Savitzky-Golay")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Smoothed samples: 200
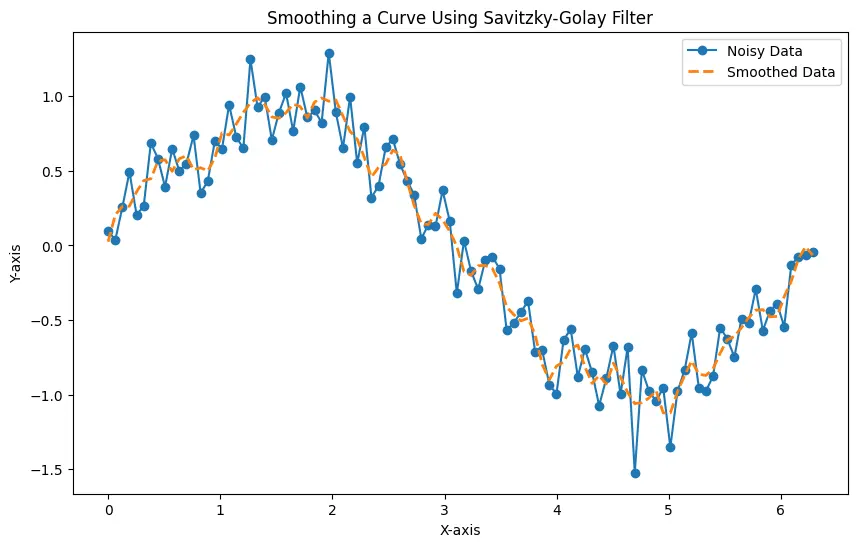
Die ersten und letzten Stichproben werden mit dem Standard-Interpolationsmodus der Funktion behandelt, sodass Ergebnisse nahe den Enden separat geprüft werden sollten. Lassen Sie die rohe Reihe sichtbar, wenn Sie entscheiden, ob das gewählte Fenster für Ihre Analyse relevante Merkmale erhält.
Verwenden Sie den gleitenden Durchschnitt, um Daten in Python zu glätten
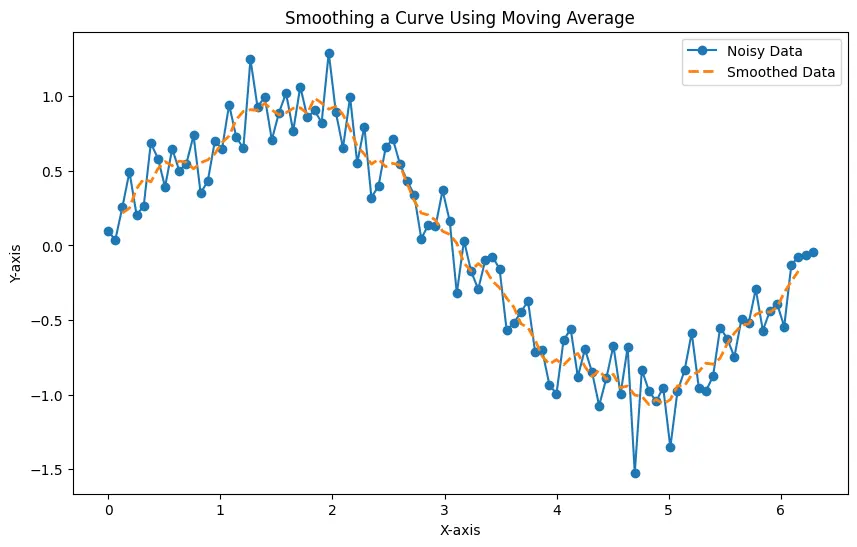
Ein gleitender Durchschnitt ersetzt jeden Wert durch den Mittelwert nahegelegener Beobachtungen. Er ist eine nützliche, einfache Basislinie, um kurzfristige Schwankungen zu reduzieren, und die Faltung ist eine gültige Art, ihn zu berechnen. Ein breiteres Fenster glättet mehr, verwischt aber auch Übergänge und Spitzen. Ein zentriertes gleitendes Fenster ist für rückblickende Plots praktisch; es verwendet Beobachtungen auf beiden Seiten jedes Punkts und ist keine Echtzeitprognose.
Dieses pandas-Beispiel verwendet ein ungerades Fenster, sodass jede innere Schätzung auf einer Stichprobe zentriert ist. Pandas markiert Positionen ohne vollständiges Fenster als fehlend, was Lücken an den Enden der geplotteten geglätteten Linie hinterlässt. Installieren Sie NumPy, pandas und Matplotlib, um es auszuführen:
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
window = 9
smoothed = pd.Series(raw).rolling(window=window, center=True).mean()

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label=f"Moving average ({window} samples)")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Gleitender Durchschnitt bietet eine ausführlichere Diskussion dieser Technik. Wählen Sie für einen gleitenden Mittelwert center=False, wenn jedes Ergebnis nur die aktuelle und frühere Beobachtungen verwenden darf. Das Fenster zählt Stichproben, sodass es nur dann eine feste Dauer darstellt, wenn die Abtastung regelmäßig ist.
Verwenden Sie die Kernel-Regression, um Daten in Python zu glätten
Die Kernel-Regression schätzt eine Antwort bei einem Prädiktorwert, indem sie nahegelegene Beobachtungen gewichtet, wobei nähere Punkte im Allgemeinen mehr Gewicht erhalten. In statsmodels akzeptiert KernelReg die beobachteten Werte als endog und ihre x-Koordinaten als exog. Setzen Sie var_type="c" für einen stetigen Prädiktor und reg_type="lc" für lokal konstante (Nadaraya-Watson) Regression. Die Bandbreite steuert, wie lokal jede Schätzung ist: Ein kleinerer Wert folgt Details enger, während ein größerer Wert über eine breitere Nachbarschaft glättet. Ein Gauß-Kernel gibt näheren x-Werten höhere Gewichte. Diese direkte Berechnung macht die Bandbreitenwahl explizit; die Kreuzvalidierung kann in Bibliotheken wie statsmodels automatisch eine Bandbreite auswählen, bei zusätzlichen Rechenkosten.
Das Beispiel passt Werte an den beobachteten x-Koordinaten an und plottet die angepasste Reihe gegen die rohen Beobachtungen. Es erfordert NumPy, statsmodels und Matplotlib:
import math
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
bandwidth = 0.35
smoothed = []
for target in x:
    weights = [math.exp(-0.5 * ((value - target) / bandwidth) ** 2) for value in x]
    smoothed.append(sum(weight * value for weight, value in zip(weights, raw)) / sum(weights))
smoothed = np.asarray(smoothed)
print(f"Kernel regression: {len(smoothed)} fitted values")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Kernel regression")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Kernel regression: 200 fitted values
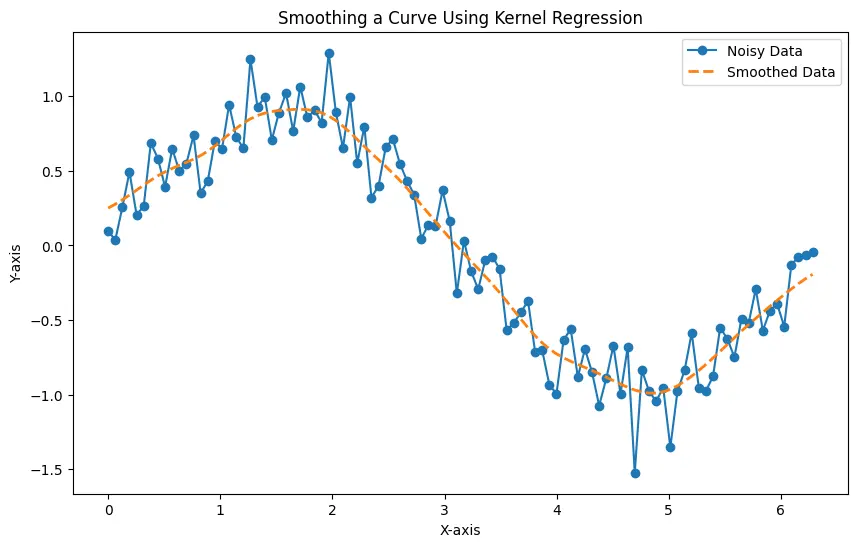
Die Kernel-Regression erfordert keine gleichmäßig verteilten Prädiktorwerte, anders als viele Standard-Digitalfilter. Ihre Anpassung kann bei großen Datensätzen langsam sein; prüfen Sie daher Datengröße und Kosten der Bandbreitenauswahl, bevor Sie sie in einer wiederholten Pipeline verwenden. Fourier-basiertes Glätten ist eine andere Option, wenn das Signal periodisch ist; seine Periodizitätsannahme macht es für beliebige Trends ungeeignet.
Verwenden Sie Lowess, um Daten in Python zu glätten
LOWESS (lokal gewichtete Scatterplot-Glättung) passt lokale Regressionen an und gibt nahegelegenen Beobachtungen mehr Einfluss als entfernten. Es kann wechselnden Steigungen folgen, ohne ein globales Polynom anzugeben. Die Funktion statsmodels.nonparametric.lowess gibt angepasste Werte zusammen mit x-Werten zurück; verwenden Sie return_sorted=False, wenn Sie angepasste Werte in der Eingabereihenfolge zum Plotten möchten.
Der Parameter frac setzt den Anteil der Beobachtungen, die in jeder lokalen Anpassung verwendet werden. Ein kleinerer Anteil betont lokale Details, während ein größerer einen breiteren Trend erzeugt. Wählen Sie ihn mit Blick auf den Maßstab sinnvoller Änderungen. Das folgende Beispiel verwendet dieselbe Eingabe wie die anderen Abschnitte und erfordert NumPy, statsmodels und Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
frac = 0.12
smoothed = sm.nonparametric.lowess(raw, x, frac=frac, return_sorted=False)

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label=f"LOWESS (frac={frac})")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
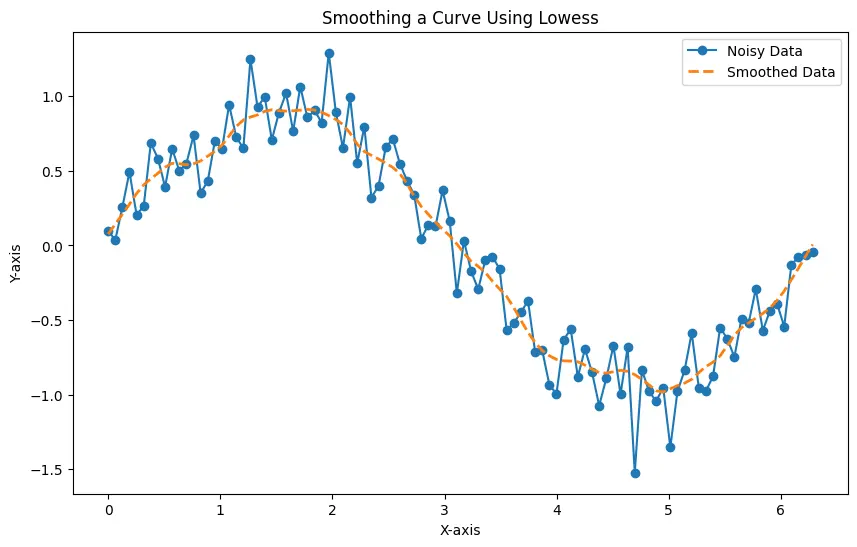
LOWESS ist ein Regressionsglätter und kein kausaler Filter: Ein angepasster Punkt kann Beobachtungen auf beiden Seiten verwenden. Behalten Sie x-Werte in ihrer vorgesehenen Reihenfolge für einen sinnvollen Linienplot, und vergleichen Sie mehr als einen plausiblen frac-Wert, wenn lokale Details wichtig sind.
Verwenden Sie den Butterworth-Filter, um Daten in Python zu glätten
Ein Butterworth-Tiefpassfilter dämpft Frequenzen oberhalb einer gewählten Grenzfrequenz. Seine Passbandantwort ist maximal flach, und seine Ordnung steuert die Steilheit des Übergangs. Verwenden Sie scipy.signal.butter, um den Filter zu entwerfen, und filtfilt, um ihn vorwärts und rückwärts anzuwenden. Diese Zwei-Durchlauf-Operation vermeidet die Phasenverzögerung eines Filters in nur einer Richtung, aber sie verwendet zukünftige Stichproben und eignet sich daher für Offline-Analysen statt für einen Live-Stream.
Geben Sie butter die Abtastrate mit fs, und drücken Sie cutoff in denselben Zyklen-pro-Zeit-Einheiten aus. Die Grenzfrequenz muss unterhalb der Nyquist-Frequenz liegen, der Hälfte der Abtastrate. Wählen Sie sie aus den Signalfrequenzen, die Sie behalten möchten; der Filter kann Rauschen nicht allein anhand ihrer Quelle von sinnvollem Inhalt unterscheiden. filtfilt benötigt außerdem genügend Stichproben für sein Padding, sodass sehr kurze Aufzeichnungen möglicherweise nicht geeignet sind. Dieses Beispiel erfordert NumPy, SciPy und Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
from scipy.signal import butter, filtfilt

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
sampling_rate = (x.size - 1) / (x[-1] - x[0])
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
cutoff = 0.8
order = 3
b, a = butter(order, cutoff, btype="low", fs=sampling_rate)
smoothed = filtfilt(b, a, raw)

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Butterworth low-pass")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
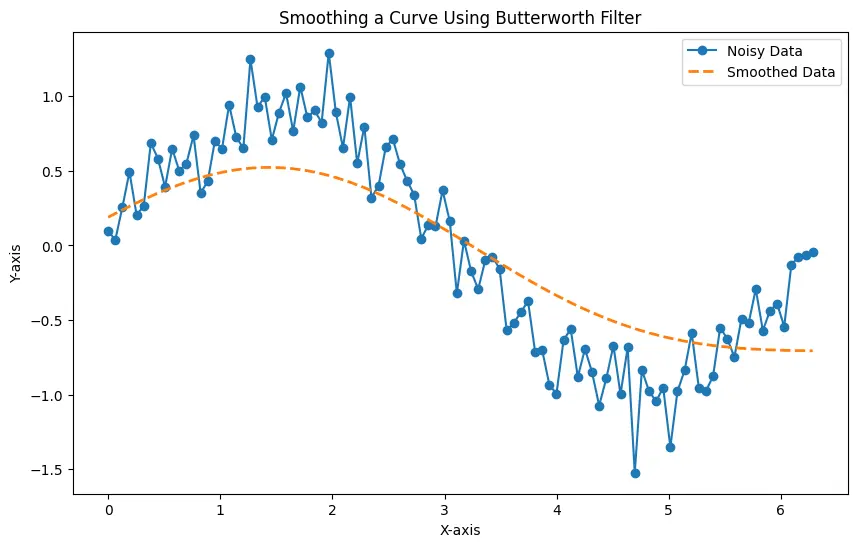
Die Abtastrate des Beispiels stammt aus gleichmäßig verteilten x-Werten. Wählen Sie für unregelmäßige Zeitstempel zuerst eine begründete Resampling-Strategie oder verwenden Sie eine Methode, die unregelmäßige Prädiktoren akzeptiert; einen konventionellen digitalen Filter so anzuwenden, als wäre der Abstand gleichmäßig, kann das Ergebnis verzerren.
Verwenden Sie den Kalman-Filter, um Daten in Python zu glätten
Ein Kalman-Filter schätzt einen verborgenen Zustand über die Zeit, indem er die Vorhersage eines Modells mit jeder neuen Beobachtung kombiniert. Ein einfaches Lokal-Niveau-Modell nimmt an, dass sich der zugrunde liegende Wert allmählich ändert: Der Zustandsübergang ist die Identität, und jede Beobachtung misst diesen Zustand plus Rauschen. Diese Annahme ist für manche Zeitreihen nützlich, aber sie modelliert eine sich wiederholende Sinuswelle oder beliebige wechselnde Dynamiken nicht automatisch.
Der untenstehende Code implementiert einen skalaren Lokal-Niveau-Kalman-Filter und einen Rückwärts-Glättungsdurchlauf mit Pythons Standardbibliothek. Die Prozessvarianz repräsentiert Zustandsänderungen, während die Beobachtungsvarianz Messrauschen repräsentiert; ihre relativen Größen steuern, wie bereitwillig Schätzungen Beobachtungen folgen. Der Rückwärtsdurchlauf verwendet spätere Beobachtungen, um frühere Zustände zu verfeinern, während die reinen Vorwärtsschätzungen für die Online-Verwendung geeignet sind.
import math
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
process_variance = 0.02
observation_variance = 0.04
estimates = []
variances = []
estimate = raw[0]
variance = 0.04
for observation in raw:
    predicted_variance = variance + process_variance
    gain = predicted_variance / (predicted_variance + observation_variance)
    estimate += gain * (observation - estimate)
    variance = (1 - gain) * predicted_variance
    estimates.append(estimate)
    variances.append(variance)
smoothed = list(estimates)
for index in range(len(raw) - 2, -1, -1):
    predicted_variance = variances[index] + process_variance
    gain = variances[index] / predicted_variance
    smoothed[index] += gain * (smoothed[index + 1] - estimates[index])
print(f"Kalman smoother: {len(smoothed)} estimates")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Kalman smoother")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Kalman smoother: 200 estimates
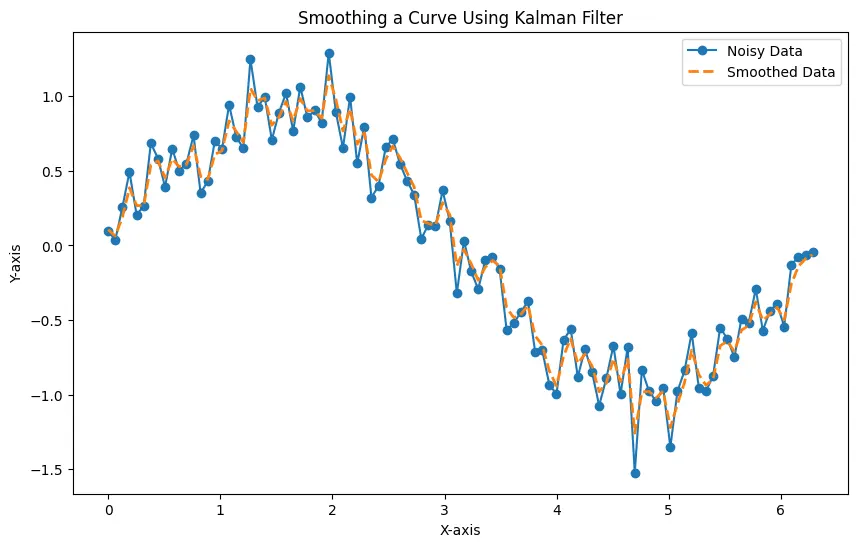
Die geplottete Schätzung ist ein geglätteter Zustand, nicht die Ausgabe des reinen Vorwärtsfilters. Das Lokal-Niveau-Modell kann systematischen Änderungen hinterherhinken oder sie abflachen; verwenden Sie ein Zustandsmodell, das den Trend oder die Dynamik repräsentiert, die Sie erwarten, und stimmen Sie die Kovarianzwerte gegen dieses Modell ab, statt sie als universelle Einstellungen zu behandeln.
Fazit
Beginnen Sie mit einem gleitenden Durchschnitt für eine transparente Basislinie mit Stichprobenfenster, oder mit Savitzky-Golay, wenn der Erhalt breiter lokaler Form wichtig ist. LOWESS und Kernel-Regression können gekrümmte Beziehungen und unregelmäßige x-Werte behandeln, wobei Bandbreite oder Anteil ihre Lokalität festlegen. Verwenden Sie einen Butterworth-Tiefpassfilter, wenn die Abtastung regelmäßig ist und eine Frequenzgrenze eine sinnvolle Interpretation hat. Ein Kalman-Filter oder -Glätter passt zu sequentiellen Zustandsschätzungsproblemen, wenn sein Zustandsmodell den Prozess beschreibt.
Vergleichen Sie für jede Methode die geglättete Linie mit den Rohdaten und variieren Sie den Hauptglättungsparameter. Prüfen Sie Grenzen, schmale Merkmale, Abtastannahmen und ob zukünftige Beobachtungen verwendet werden. Glätten kann eine Visualisierung verdeutlichen, aber es kann nicht belegen, dass ein Trend echt ist, oder jede nachgelagerte Analyse verbessern; halten Sie die ungeglätteten Daten zur Interpretation verfügbar.