
HOWTO · Python
如何在 Python 中平滑資料
本教程演示瞭如何在 Python 中平滑圖形中的曲線
本頁內容
平滑可以使嘈雜的一維序列在繪圖中更容易檢查。然而,它會改變數值,並可能隱藏真實的峰值、階梯或短暫的變化;請將平滑曲線視為資料的一種檢視,而不是對觀測值的驗證或替代。Python 提供了幾種方法,正確的選擇取決於您的樣本是否均勻分布、是否需要因果估計,以及局部細節有多重要。
下面的範例使用可複現的帶噪正弦波,以便比較其原始線條和平滑線條。輸出塊顯示了三個範例列印的簡短摘要行;每個腳本還會建立一個包含兩個序列的繪圖。在執行使用這些套件的範例之前,請在您的環境中安裝提到的套件。
使用 Savitzky-Golay 濾波器在 Python 中平滑資料
Savitzky-Golay 濾波器透過最小平方法將低階多項式擬合到每個局部視窗,然後使用其中心的擬合值。這可以比簡單的平均更好地保留廣泛特徵的形狀和幅度,前提是視窗適合這些特徵。它以 scipy.signal.savgol_filter 函數的形式提供。
window_length 是正的奇數個樣本,polyorder 必須小於視窗長度。增大視窗可以更積極地平滑;僅當訊號的局部形狀需要時才增加多項式階數。跨越窄峰的視窗可能會將其壓平。此範例需要 NumPy、SciPy 和 Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
from scipy.signal import savgol_filter

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
smoothed = savgol_filter(raw, window_length=9, polyorder=2)
print(f"Smoothed samples: {len(smoothed)}")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Savitzky-Golay")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Smoothed samples: 200
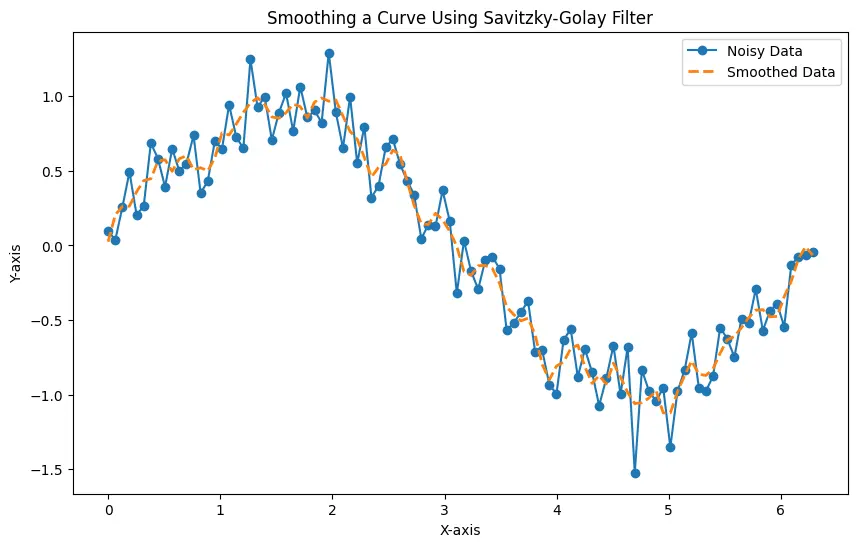
第一個和最後一個樣本使用函數的預設插值模式處理,因此靠近兩端的結果值得單獨檢查。在決定所選視窗是否保留與您的分析相關的特徵時,請保持原始序列可見。
使用移動平均在 Python 中平滑資料
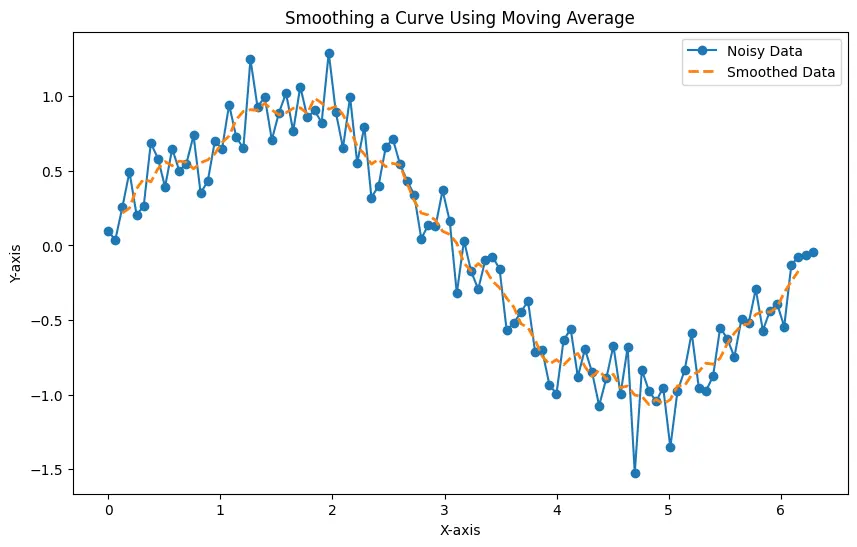
移動平均將每個值替換為附近觀測值的平均值。它是減少短期變動的有用簡單基線,卷積是計算它的一種有效方法。更寬的視窗平滑得更多,但也會模糊過渡和峰值。居中的滾動視窗對回顧性繪圖很方便;它使用每個點兩側的觀測值,而不是即時預測。
此 pandas 範例使用奇數視窗,以便每個內部估計都以一個樣本為中心。Pandas 將沒有完整視窗的位置標記為缺失,從而在繪製的平滑線條兩端留下間隙。安裝 NumPy、pandas 和 Matplotlib 來執行它:
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
window = 9
smoothed = pd.Series(raw).rolling(window=window, center=True).mean()

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label=f"Moving average ({window} samples)")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
移動平均 對這一技術提供了更完整的討論。對於滾動平均,當每個結果必須僅使用目前和較早的觀測值時,請選擇 center=False。視窗計算的是樣本數,因此僅當採樣規則時它才表示固定的持續時間。
使用核迴歸在 Python 中平滑資料
核迴歸透過對附近的觀測值加權來估計預測變量值處的響應,越近的點通常獲得越多的權重。在 statsmodels 中,KernelReg 接受觀測值作為 endog,它們的 x 座標作為 exog。對於連續預測變量設定 var_type="c",對於局部常數(Nadaraya-Watson)迴歸設定 reg_type="lc"。頻寬控制每個估計的局部程度:較小的值更緊密地跟隨細節,而較大的值在更寬的鄰域內平滑。高斯核賦予較近的 x 值更高的權重。這種直接計算使頻寬選擇明確;交叉驗證可以在像 statsmodels 這樣的庫中自動選擇頻寬,但會有額外的計算成本。
該範例在觀測到的 x 座標處擬合值,並將擬合的序列與原始觀測值繪圖比較。它需要 NumPy、statsmodels 和 Matplotlib:
import math
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
bandwidth = 0.35
smoothed = []
for target in x:
    weights = [math.exp(-0.5 * ((value - target) / bandwidth) ** 2) for value in x]
    smoothed.append(sum(weight * value for weight, value in zip(weights, raw)) / sum(weights))
smoothed = np.asarray(smoothed)
print(f"Kernel regression: {len(smoothed)} fitted values")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Kernel regression")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Kernel regression: 200 fitted values
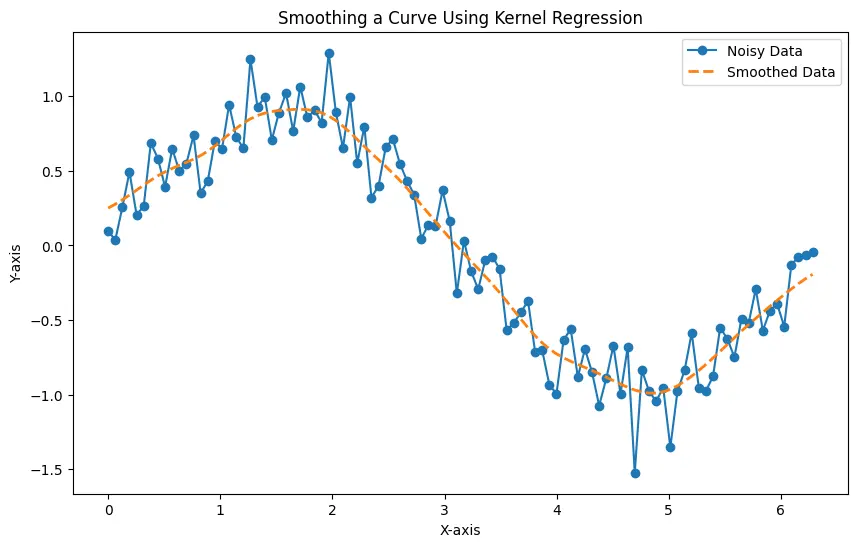
與許多標準數位濾波器不同,核迴歸不需要均勻分布的預測變量值。它的擬合在大型資料集上可能很慢,因此在重複的流水線中使用它之前,請檢查資料大小和頻寬選擇成本。基於傅里葉的平滑是訊號具有週期性時的另一種選擇;它的週期性假設使其不適用於任意趨勢。
使用 Lowess 在 Python 中平滑資料
LOWESS(局部加權散點圖平滑)擬合局部迴歸,賦予附近觀測值比遠處觀測值更大的影響。它可以跟隨變化的斜率,而無需指定一個全域多項式。statsmodels.nonparametric.lowess 函數返回擬合值以及 x 值;當您希望擬合值按輸入順序用於繪圖時,請使用 return_sorted=False。
frac 參數設定每個局部擬合中使用的觀測值的比例。較小的比例強調局部細節,而較大的比例產生更廣泛的趨勢。選擇時要考慮有意義變化的規模。以下範例使用與其他部分相同的輸入,需要 NumPy、statsmodels 和 Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
import statsmodels.api as sm

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
frac = 0.12
smoothed = sm.nonparametric.lowess(raw, x, frac=frac, return_sorted=False)

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label=f"LOWESS (frac={frac})")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
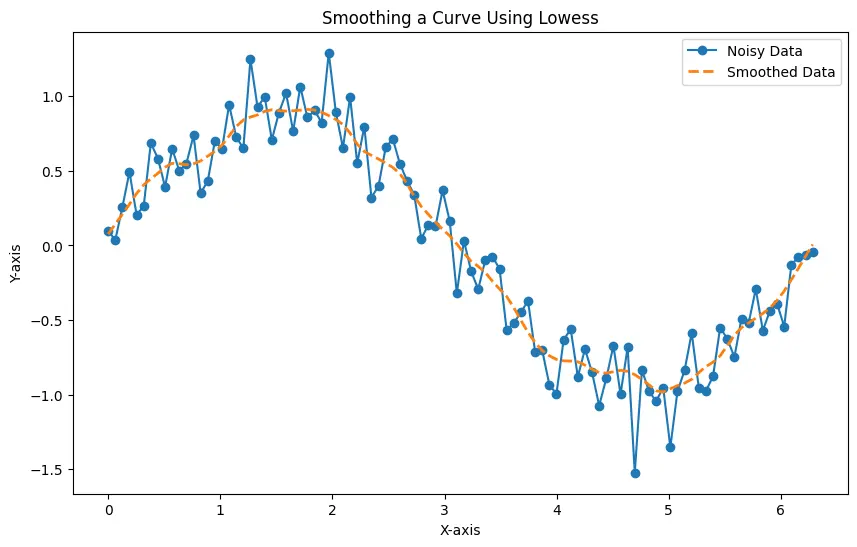
LOWESS 是迴歸平滑器而不是因果濾波器:擬合點可以使用任一側的觀測值。為了有意義的線圖,請保持 x 值的預期順序,如果局部細節很重要,請比較多個合理的 frac 值。
使用 Butterworth 濾波器在 Python 中平滑資料
低通 Butterworth 濾波器衰減高於選定截止頻率的頻率。它的通帶響應最大平坦,其階數控制過渡的陡峭度。使用 scipy.signal.butter 設計濾波器,使用 filtfilt 向前和向後應用它。這種雙向操作避免了單向濾波器的相位延遲,但它使用未來的樣本,因此適合離線分析而不是即時流。
使用 fs 將採樣率提供給 butter,並以相同的每時間週期單位表示 cutoff。截止頻率必須低於奈奎斯特頻率,即採樣率的一半。根據您打算保留的訊號頻率選擇它;濾波器無法僅根據來源區分噪音和有意義的內容。filtfilt 還需要足夠的樣本用於填充,因此非常短的記錄可能不適合。此範例需要 NumPy、SciPy 和 Matplotlib:
import matplotlib.pyplot as plt
import numpy as np
from scipy.signal import butter, filtfilt

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
sampling_rate = (x.size - 1) / (x[-1] - x[0])
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
cutoff = 0.8
order = 3
b, a = butter(order, cutoff, btype="low", fs=sampling_rate)
smoothed = filtfilt(b, a, raw)

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Butterworth low-pass")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
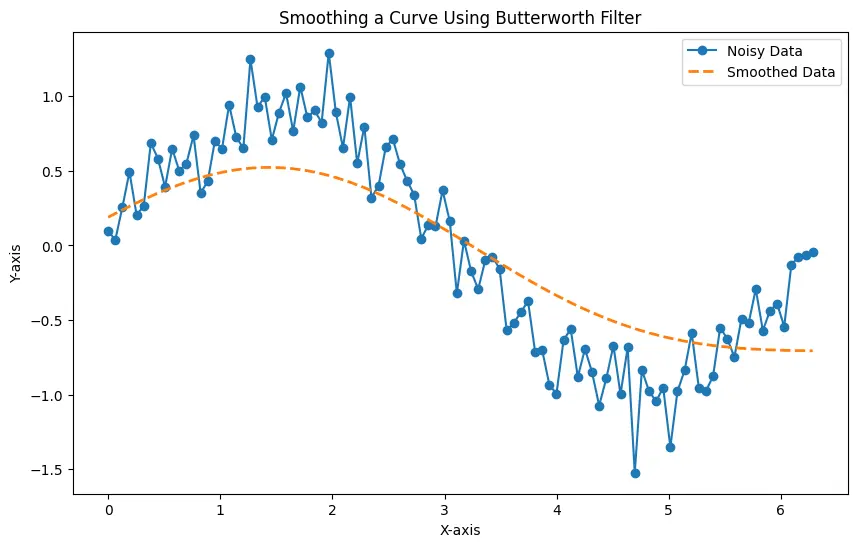
該範例的採樣率來自均勻分布的 x 值。對於不規則的時間戳,請首先選擇合理的重採樣策略或使用接受不規則預測變量的方法;將傳統數位濾波器當作間隔均勻來應用可能會扭曲結果。
使用卡爾曼濾波器在 Python 中平滑資料
卡爾曼濾波器透過將模型的預測與每個新觀測值相結合來估計隨時間變化的隱藏狀態。簡單的局部水平模型假設底層值逐漸變化:狀態轉移是恆等的,每個觀測值測量該狀態加上噪音。此假設對某些時間序列有用,但它不會自動建模重複的正弦波或任意變化的動態。
下面的程式碼使用 Python 的標準庫實現了一個標量局部水平卡爾曼濾波器和一個向後平滑過程。過程方差表示狀態變化,而觀測方差表示測量噪音;它們的相對大小控制估計值跟隨觀測值的意願程度。向後過程使用較晚的觀測值來細化較早的狀態,而僅向前的估計適合在線使用。
import math
import matplotlib.pyplot as plt
import numpy as np

rng = np.random.default_rng(42)
x = np.linspace(0, 10, 200)
raw = np.sin(2 * np.pi * 0.3 * x) + 0.2 * rng.normal(size=x.size)
process_variance = 0.02
observation_variance = 0.04
estimates = []
variances = []
estimate = raw[0]
variance = 0.04
for observation in raw:
    predicted_variance = variance + process_variance
    gain = predicted_variance / (predicted_variance + observation_variance)
    estimate += gain * (observation - estimate)
    variance = (1 - gain) * predicted_variance
    estimates.append(estimate)
    variances.append(variance)
smoothed = list(estimates)
for index in range(len(raw) - 2, -1, -1):
    predicted_variance = variances[index] + process_variance
    gain = variances[index] / predicted_variance
    smoothed[index] += gain * (smoothed[index + 1] - estimates[index])
print(f"Kalman smoother: {len(smoothed)} estimates")

plt.plot(x, raw, label="Raw")
plt.plot(x, smoothed, label="Kalman smoother")
plt.xlabel("Time")
plt.ylabel("Value")
plt.legend()
plt.show()
Kalman smoother: 200 estimates
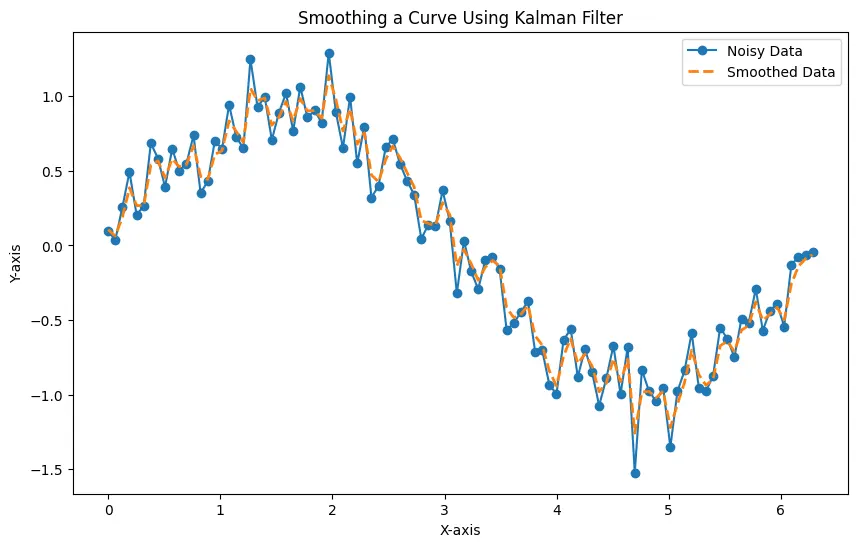
繪製的估計是平滑後的狀態,而不是僅向前濾波器的輸出。局部水平模型可能會滯後於系統性變化或將其壓平;請使用表示您預期的趨勢或動態的狀態模型,並根據該模型調整共變異數值,而不是將其視為通用設定。
結論
從移動平均開始,以獲得透明的樣本視窗基線,或當保留廣泛的局部形狀很重要時從 Savitzky-Golay 開始。LOWESS 和核迴歸可以處理彎曲的關係和不規則的 x 值,頻寬或比例決定了它們的局部性。當採樣規則且頻率截止具有有意義的解釋時,使用低通 Butterworth 濾波器。當其狀態模型描述該過程時,卡爾曼濾波器或平滑器適合順序狀態估計問題。
對於每種方法,請將平滑線條與原始資料進行比較,並改變主要的平滑參數。檢查邊界、窄特徵、採樣假設以及是否使用了未來的觀測值。平滑可以使視覺化更清晰,但它不能確立趨勢是真實的,也不能改善每個下游分析;請保留未平滑的資料以供解釋。