
이 페이지의 내용
Python 문자열: 변환, 정리, 찾기 및 서식 지정
문자열은 Python에서 가장 자주 다루는 데이터 타입입니다. 사용자 입력, 파일 내용, 웹 페이지, CSV 행은 모두 텍스트로 도착합니다. 문자열은 과소평가하기 쉽습니다. Python 문자열은 불변(immutable)이기 때문입니다. 어떤 메서드도 문자열을 제자리에서 변경하지 않으며, 모든 연산은 새 문자열을 반환합니다. 이 페이지는 DelftStack의 문자열 가이드 115개 전체를 수행하려는 작업 기준으로 정리했습니다. 네 가지 작업 축, 즉 텍스트를 다른 타입으로 변환하고 되돌리기, 속하지 않는 문자 정리하기, 문자열에 무엇이 들어 있는지 찾고 확인하기, 출력을 위해 텍스트 서식 지정 및 바꾸기를 따라 구성했습니다.
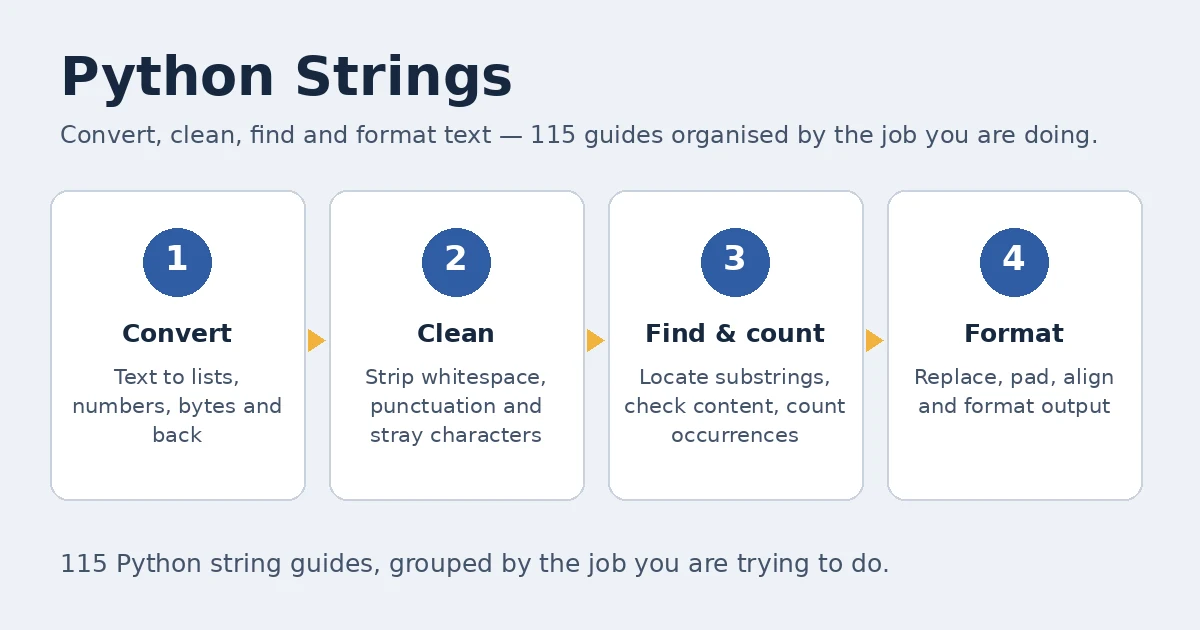
문자열 학습 경로
먼저 5분간 기초부터 시작하세요. 문자열이 어떻게 만들어지고, 인덱싱과 슬라이싱이 어떻게 동작하며, 불변성 때문에 왜 항상 반환값을 보관해야 하는지 익힙니다. 다음으로 찾기와 정리를 배웁니다. find(), in 연산자, strip(), replace()가 일상적인 텍스트 작업의 대부분을 처리합니다. 이어서 변환으로 넘어갑니다. 여기서는 문자열이 리스트, 숫자, 딕셔너리, 바이트와 자리를 맞바꿉니다. 마지막은 서식 지정과 바꾸기입니다. f-문자열이 기본값이며, 예전 스타일은 여전히 제 몫을 하는 자리에서만 등장합니다. 아래의 각 단계는 이 페이지의 그룹 하나씩에 대응하며, 배워야 할 순서대로 배열했습니다.
5분 기초: 만들기, 연결하기, 반복하기
문자열은 작은따옴표나 큰따옴표로 감싼 문자의 나열입니다. 삼중 따옴표는 여러 줄에 걸쳐 있고, 인덱싱과 슬라이싱으로 어떤 부분이든 읽을 수 있습니다. 작업의 대부분을 담당하는 사실은 두 가지입니다. len()이 문자열의 길이를 재고, 더 긴 문자열을 만들면 항상 새 값이 생긴다는 것입니다.
- Python에서 문자열 N번 반복 — 고정된 횟수의 복사본은
*로 곱하고, 이후 반복과 슬라이싱으로 목표 길이에 정확히 맞추며, 빈 소스와 음수 길이를 검증합니다. - 파이썬에서 문자열 복사 — 불변성 때문에 두 변수가 하나의 값을 공유하는 이유를 설명한 뒤, 빈 문자열 연결, 전체 슬라이싱,
str(),%,format(), f-문자열이라는 여섯 가지 복제 방법을 소개합니다. - Python에서 여러 줄 문자열 만들기 — 진짜 여러 줄 텍스트에는 삼중 따옴표를, 하나의 논리 줄에는 백슬래시와 괄호 연결을, 고정 폭 출력에는
textwrap.fill()을 사용합니다. - Python에서 한 문자열을 다른 문자열에 추가 —
+와str.join()의 비교입니다. 조각이 많을 때는join()이 이깁니다.+를 쓸 때마다 새 중간 문자열이 만들어지기 때문입니다.
변환: 문자열을 리스트와 숫자로, 그리고 반대로
변환이야말로 문자열 작업이 진가를 발휘하는 곳입니다. 데이터는 텍스트로 도착해 다른 무언가로 사용됩니다. 가장 붐비는 출입구는 리스트이고, 그다음이 숫자입니다. 컨테이너는 str()이나 join()으로 평평해지고, 바이트는 명시적인 인코딩을 통해서만 넘어옵니다. 한편 이웃 주제 하나는 다른 곳에 있습니다. datetime을 문자열로 바꾸는 작업은 Datetime 가이드의 담당이니, Python 필러의 Datetime 섹션을 참고하세요.
- Python에서 문자열을 리스트로 변환하는 방법 — 대표 가이드입니다. 문자 단위에는
list(), 단어와 필드에는split(), 리터럴 텍스트에는ast.literal_eval()을 사용합니다. 신뢰할 수 없는 입력에는 절대eval()을 쓰지 마세요. - Python에서 튜플을 문자열로 변환 —
str()은 튜플의 구조를 유지하고,join()은 깔끔하게 구분된 결과를 내놓으며, 요소마다str()을 적용하는 제너레이터는 타입이 섞인 경우를 처리합니다. - Python에서 사전을 문자열로 변환 — 네 가지 방법, 즉 직접 작성한 루프,
str(), 교환용json.dumps(), 중첩을 읽기 좋게 만드는pprint.pformat()을 소개합니다. - Python에서 tostring()에 해당하는 기능 — Python에는
toString()이 없습니다. 하나의 값에는str(), 여러 값에는join(), 메시지에는 f-문자열, 직접 만든 클래스에는__str__()을 사용하세요. - Python에서 문자열 목록을 정수로 변환 — 같은 변환을 네 가지 방법, 즉 컴프리헨션,
map(int, ...), 명시적 루프, 대규모 데이터셋용 NumPy로 보여줍니다. - Python에서 Bytearray를 문자열로 변환 —
bytes()를 쓰면b'...'repr이 남는 이유와,bytearray.decode()가 실제 텍스트를 반환하는 이유를 보여줍니다. - Python에서 문자열을 바이너리로 변환 —
ord()를 이용한 코드 포인트 기준 이진 표현과,08b채우기를 지정한bytearray()를 이용한 인코딩된 바이트 기준 이진 표현을 구분합니다. - Python에서 문자열을 부울로 변환 — 먼저 함정부터 시작합니다.
bool("False")는True입니다. 그 뒤로 알 수 없는 표기가 나오면 예외를 발생시키는 명시적인 토큰 파서를 구축합니다.
정리 및 삭제: 속하지 않는 문자 제거하기
정리는 이 클러스터의 홈그라운드입니다. 스크레이핑한 페이지, 내보낸 파일, 사용자 입력은 초대받지 않은 문자를 끼워 넣은 채 도착합니다. 오염의 모양에 따라 고르세요. 알려진 부분 문자열 하나에는 replace(), 문자 집합 전체를 한 번에 처리할 때는 테이블을 쓰는 translate(), 오염이 리터럴이 아니라 패턴일 때는 정규식이 적합합니다.
- Python의 문자열에서 xa0을 제거하는 방법 — 보이지 않는 줄바꿈 없는 공백에 대한 두 가지 공략법입니다.
unicodedata.normalize("NFKD", ...)를 이용한 분해와replace("\xa0", " ")를 이용한 직접 치환입니다. - Python의 문자열에서 쉼표 제거 — 모든 쉼표에는
replace(",", "")를, 첫 번째만이라면count인자를, 패턴 작업에는re.sub()를 사용합니다. - 파이썬에서 문자열에서 구두점을 제거하는 방법 — 완전한 도구 모음입니다.
string.punctuation필터, 정규식[^\w\s]치환,maketrans()로 만드는 빠른str.translate()테이블을 소개합니다. - Python의 문자열에서 따옴표 제거 —
replace()는 모든 곳의 따옴표를 지웁니다.strip('"')은 앞뒤의 한 쌍만 다듬고 내부 따옴표는 건드리지 않습니다. - Python의 문자열에서 특수 문자 제거 — 먼저 ‘특수’가 무엇인지 정의한 뒤,
isalnum()필터,translate()집합, 또는 ASCII 전용 정규식을 적용합니다. - Python의 문자열에서 \n 제거 — 줄바꿈에는
replace()를, 줄을 단일 공백으로 다시 이을 때는split()과join()을, 공백이 섞여 있을 때는 정규식을 사용합니다. - 파이썬에서 문자열에서 마지막 문자를 제거하는 방법 — 슬라이싱으로 해결합니다.
s[:-1]이 마지막 문자를 떨어뜨리고, 음수 인덱싱을 쓰면 마지막 세 문자까지 일반화할 수 있습니다.
찾기, 확인 및 개수 세기
찾기는 이 클러스터에서 가장 충족되지 않은 수요입니다. 독자는 원하는 문자를 알고 있고, 그 위치, 개수, 또는 예/아니오라는 답을 필요로 합니다. 역할 분담을 분명히 하세요. in은 ‘있는지’에, find()는 ‘첫 번째가 어디인지’에, index()는 ‘어디인지’에 답하면서 일치하는 것이 없으면 크게 항의하고, count()는 ‘몇 개인지’에 답합니다.
- Python에서 문자열의 문자 위치 찾기 — 첫 번째 일치에는
find(), 마지막 일치에는rfind(), 없음이 예외가 되어야 할 때는index(), 모든 인덱스에는enumerate()루프를 사용합니다. - Python에서 문자열의 문자 발생 횟수 계산 — 한 문자에는
str.count()를, 겹치지 않는 부분 문자열을 세는 규칙과 함께 소개합니다. 모든 문자를 세야 할 때는collections.Counter를 사용합니다. - Python에서 문자열에 Word가 포함되어 있는지 확인 — 단순한 테스트에는
in을 사용하되,"is" in "This"가 참이 된다는 점에 유의합니다. 단어 전체가 중요하면\b단어 경계를 쓰는 정규식이 적합합니다. - Python에서 변수가 문자열인지 여부를 확인합니다 — 기본값은
isinstance(value, str)입니다. 서브클래스를 놓치는 더 엄격한type()비교와 try-except 변형도 소개합니다. - 파이썬 if 문에서 문자열 비교하기 —
==,in멤버십, 대소문자를 정규화한 비교로 조건을 만듭니다.is는 텍스트가 아니라 동일성을 테스트합니다. - 파이썬은 문자열에서 모든 항목 찾기 — 빠른 합계에는 경계를 지정한
count()를, 모든 인덱스를 반환하려면startswith()를 사용하는 컴프리헨션을 사용합니다.
대소문자, 비교 및 채우기
대소문자는 비교가 조용히 어긋나는 지점입니다. Python은 유니코드 코드 포인트 기준으로 비교하므로 대소문자와 특수 문자가 모두 영향을 줍니다. 비교 전에 정규화하세요. 일반 텍스트에는 lower()나 upper()를, 유니코드 쌍을 일치시켜야 할 때는 casefold()를 사용하고, 표현을 위해서는 ljust(), rjust(), center(), zfill()로 채웁니다.
- Python에서 대소 문자를 구분하지 않는 문자열 비교 — 양쪽을
lower()나upper()로 정규화한 뒤, 유니코드 관점에서casefold()의 필요성을 제시합니다. 이는straße와STRASSE를 같은 것으로 취급합니다. - Python에서 공백으로 문자열 채우기 — 전체 구성을 소개합니다.
ljust(),rjust(), 채움 문자를 지정한center(), 그리고 정렬된 출력을 위한%,format(), f-문자열 등가 방법입니다. - Python에서 문자열 비교 — 연산자 레퍼런스입니다. 동등성에는
==와!=, 사전식 순서에는<와>를 사용하며, 순서는 처음 달라지는 코드 포인트에서 결정됩니다. - Python에서 문자별로 두 문자열 비교 —
zip()으로 문자를 짝짓고 일치하는 위치를 세며,None입력과 길이가 다른 경우를 명시적으로 처리합니다.
서식 지정 및 바꾸기
새 코드에서 서식 지정이란 f-문자열을 뜻합니다. 값이 템플릿 안, 읽을 수 있는 자리에 놓이고, 서식 지정자가 너비와 정밀도를 제어합니다. str.format()은 템플릿이 따로 있거나 재사용될 때 여전히 적합하고, % 서식은 앞으로도 만나게 될 오래된 코드 속에 살아남아 있습니다. 바꾸기도 다른 모든 것과 마찬가지로 불변성을 따릅니다. 문자열을 편집하는 것이 아니라, 수정된 새 문자열을 만드는 것입니다.
- Python에서 문자열의 문자 바꾸기 — 인덱스를 이용한 리스트화와 대입, 알려진 위치 전후의 슬라이싱, 모든 일치에 대한
replace()입니다. 모두 새 문자열을 반환합니다. - Python 문자열 형식화에서 % s와 % d의 차이점 —
%s는str()변환을 통해 어떤 값이든 받아들입니다.%d는 정수를 요구하고 소수를 버립니다. 대부분의 놀라움 뒤에 있는, 오래된 구분입니다. - Python Sprintf: Python의 형식화된 문자열 — Python에는
sprintf()가 없습니다. 그 일은%연산자,format(), f-문자열, 또는 직접 만든 래퍼에 대응합니다. - Python의 인덱스에서 문자열의 문자 바꾸기 —
Meatloaf예제를 슬라이싱 후 재구성하는 방법과 리스트 사본을 변경하는 방법 두 가지로 보여주고, 여러 인덱스로 확장합니다.
문자열 메서드 맵
Python에는 47개의 내장 문자열 메서드가 들어 있으며, 이 맵을 쓰면 알맞은 것을 빠르게 찾을 수 있습니다. 동사 기준으로 읽으세요. is* 계열은 확인을, 대소문자 메서드는 변환을, split과 join은 분해와 재구성을, 검색 계열 메서드는 위치 찾기를 담당합니다. 어떤 메서드를 더 깊게 다루는 가이드가 있으면 세 번째 열에서 링크합니다. 셀이 비어 있으면 한 줄 설명으로 충분하다는 뜻입니다.
| 메서드 | 역할 | 자세히 보기 |
|---|---|---|
capitalize() |
첫 문자를 대문자로, 나머지를 소문자로 변환 | 자세히 보기 |
casefold() |
대소문자를 구분하지 않는 매칭을 위해 만들어진 강력한 소문자화 | 자세히 보기 |
center() |
지정한 너비의 필드 중앙에 문자열을 배치 | 자세히 보기 |
count() |
부분 문자열이 겹치지 않게 등장하는 횟수를 셈 | 자세히 보기 |
encode() |
선택한 인코딩으로 문자열을 바이트로 인코딩 | 자세히 보기 |
endswith() |
문자열이 접미사로 끝나는지 테스트 | |
expandtabs() |
탭 문자를 공백으로 바꿈 | |
find() |
부분 문자열의 가장 낮은 인덱스, 없으면 -1 | 자세히 보기 |
format() |
{} 플레이스홀더에 값을 서식 지정 | 자세히 보기 |
format_map() |
format()과 같지만 값은 매핑에서 가져옴 | |
index() |
부분 문자열의 가장 낮은 인덱스, 없으면 ValueError 발생 | 자세히 보기 |
isalnum() |
모든 문자가 문자 또는 숫자이면 True | 자세히 보기 |
isalpha() |
모든 문자가 알파벳이면 True | |
isascii() |
모든 문자가 ASCII이면 True | |
isdecimal() |
모든 문자가 10진수 숫자이면 True | |
isdigit() |
모든 문자가 숫자이면 True | 자세히 보기 |
isidentifier() |
문자열이 유효한 Python 식별자이면 True | |
islower() |
대소문자가 있는 문자가 모두 소문자이면 True | |
isnumeric() |
모든 문자가 수치이면 True | |
isprintable() |
모든 문자가 인쇄 가능하면 True | |
isspace() |
모든 문자가 공백이면 True | |
istitle() |
문자열이 타이틀 케이스이면 True | |
isupper() |
대소문자가 있는 문자가 모두 대문자이면 True | |
join() |
이 문자열을 구분자로 삼아 문자열 이터러블을 연결 | 자세히 보기 |
ljust() |
지정한 너비의 필드에서 왼쪽 정렬 | 자세히 보기 |
lower() |
소문자로 바꾼 복사본을 반환 | 자세히 보기 |
lstrip() |
앞부분 문자를 제거 (기본값은 공백) | |
maketrans() |
translate()용 변환 테이블을 생성 | 자세히 보기 |
partition() |
첫 번째 구분자에서 나눠 세 부분 튜플로 반환 | |
removeprefix() |
접두사가 있으면 제거 | |
removesuffix() |
접미사가 있으면 제거 | |
replace() |
부분 문자열의 등장 위치를 다른 문자열로 바꿈 | 자세히 보기 |
rfind() |
부분 문자열의 가장 높은 인덱스, 없으면 -1 | 자세히 보기 |
rindex() |
부분 문자열의 가장 높은 인덱스, 없으면 ValueError 발생 | |
rjust() |
지정한 너비의 필드에서 오른쪽 정렬 | 자세히 보기 |
rpartition() |
마지막 구분자에서 나눠 세 부분 튜플로 반환 | |
rsplit() |
오른쪽부터 세면서 구분자로 나눔 | |
rstrip() |
끝부분 문자를 제거 (기본값은 공백) | |
split() |
구분자로 나눠 리스트로 반환 | 자세히 보기 |
splitlines() |
줄 경계에서 나눠 리스트로 반환 | |
startswith() |
문자열이 접두사로 시작하는지 테스트 | 자세히 보기 |
strip() |
앞부분과 끝부분 문자를 제거 | 자세히 보기 |
swapcase() |
모든 문자의 대소문자를 뒤바꾼 복사본을 반환 | |
title() |
각 단어의 첫 글자가 대문자인 타이틀 케이스 복사본을 반환 | |
translate() |
변환 테이블을 통해 문자를 매핑 | 자세히 보기 |
upper() |
대문자로 바꾼 복사본을 반환 | 자세히 보기 |
zfill() |
지정한 너비가 되도록 앞에 0을 채움 | 자세히 보기 |
자주 묻는 질문
Python에서 문자열을 리스트로 변환하려면 어떻게 하나요?
하나의 요소가 무엇이어야 할지 정한 뒤, 거기에 맞는 도구를 고르세요. list(text)는 문자마다 하나의 요소를, text.split()은 단어를, text.split(",")는 구분자로 나뉜 필드를 주며 빈 필드도 보존합니다. 이미 Python 리스트처럼 보이는 텍스트는 ast.literal_eval()로 파싱하고, 결과가 정말 리스트인지 확인하세요. 통제할 수 없는 입력에는 절대 eval()을 쓰지 마세요. 전체 절차는 Python에서 문자열을 리스트로 변환하는 방법에 있습니다.
문자열에 부분 문자열이나 단어가 포함되어 있는지 어떻게 확인하나요?
단순한 부분 문자열 테스트에는 in 연산자를 사용합니다. "word" in text는 불리언을 반환하며 대소문자를 구분합니다. 위치도 필요하면 find()가 첫 번째 인덱스나 -1을 반환하고, index()는 대신 ValueError를 발생시킵니다. in은 더 큰 단어 안에서도 일치한다는 점에 유의하세요. "is" in "This"는 참입니다. 따라서 단어 전체를 대상으로 할 때는 토큰화하거나 \b 경계를 쓰는 정규식을 사용합니다. Python에서 문자열에 Word가 포함되어 있는지 확인에서 보여주는 방식입니다.
문자열에서 구두점이나 특수 문자를 제거하려면 어떻게 하나요?
먼저 무엇을 없앨지 정의하세요. 구두점만인지, 문자와 숫자가 아닌 전부인지에 따라 달라집니다. 구두점에는 string.punctuation에 대한 필터, 정규식 [^\w\s] 치환, maketrans()로 만든 str.translate() 테이블을 이용한 일괄 삭제(가장 빠른 선택지)가 있습니다. 더 넓은 정리에는 isalnum() 필터가 유니코드 문자와 숫자를 보존합니다. 파이썬에서 문자열에서 구두점을 제거하는 방법이 각 변형을 설명합니다.
Python에서 “not all arguments converted during string formatting” 오류가 발생하는 이유는 무엇인가요?
이 TypeError는 % 서식 지정에서 발생합니다. 템플릿 안의 플레이스홀더 수가 전달한 값 튜플보다 적어서, 인자가 남은 채로 템플릿의 끝에 도달하기 때문입니다. 예를 들어 "Value: " % (1, 2)가 그렇습니다. 각 값마다 정확히 하나의 플레이스홀더를 주고, 단일 값은 요소가 하나인 튜플로 감싸며, 리터럴 퍼센트 기호는 %%`로 이스케이프하세요. 전용 오류 가이드가 이 메시지를 사례별로 해부합니다.
Python에 toString()이 있나요?
없습니다. Python에는 toString() 메서드가 없습니다. 그것을 찾는 것은 Java에서 가져온 습관입니다. 동등한 것은 내장 str(value)로, 숫자, 컬렉션, 대부분의 객체에 대해 읽기 좋은 문자열을 반환합니다. 여러 문자열을 합칠 때는 join()을, 메시지를 만들 때는 f-문자열을, 출력 방식을 제어하려면 직접 만든 클래스에 __str__()을 정의하세요. 단, str()이 만드는 것은 표시용 텍스트이지 JSON이나 CSV가 아닙니다. Python에서 tostring()에 해당하는 기능을 참고하세요.
특정 인덱스에 있는 한 문자를 바꾸려면 어떻게 하나요?
문자열에 대입할 수는 없습니다. 문자열은 불변이므로 text[2] = "m"은 TypeError를 발생시킵니다. 대신 바꿀 문자열을 새로 만드세요. 위치 전후를 슬라이싱하는 text[:2] + "m" + text[3:], 또는 리스트로 변환해 인덱스에 대입한 뒤 "".join(...)으로 다시 합치는 방법이 있습니다. 둘 다 새 문자열을 반환하고 원본은 건드리지 않습니다. 인덱스가 사용자 입력에서 온 경우 len(text)에 대해 검증하세요. Python의 인덱스에서 문자열의 문자 바꾸기가 두 방법을 모두 보여줍니다.
모든 Python 문자열 가이드
기초
- 파이썬에서 문자열 복사
- Python에서 문자열 N번 반복
- Python에서 여러 줄 문자열 만들기
- 파이썬에서 문자열 루프
- Python에서 한 문자열을 다른 문자열에 추가
- Python에서 문자열과 Int 값 연결하기
- Python에서 문자열에 문자 추가
- Python에서 동등한 문자열 작성기
- Python에서 문자열에 문자열 삽입
- How to Fix String Indices Must Be Integers Error in Python
변환
- Python에서 문자열을 리스트로 변환하는 방법
- Python에서 튜플을 문자열로 변환
- Python에서 문자열 목록을 정수로 변환
- Python에서 Bytearray를 문자열로 변환
- Python에서 사전을 문자열로 변환
- Python에서 tostring()에 해당하는 기능
- 파이썬에서 문자열을 부동 또는 정수로 변환하는 방법
- 파이썬에서 부동 소수점을 문자열로 변환하는 방법
- How to Convert String to Unicode in Python
- Python에서 문자열을 바이너리로 변환
- Python에서 문자열을 부울로 변환
- 파이썬에서 정수를 문자열로 변환하는 방법
- 파이썬에서 부동 숫자를 문자열로 포맷하기
- How to Convert List to Comma-Separated String in Python
- 파이썬에서 리스트를 문자열로 변환하는 방법
- Python에서 문자열 목록 연결
- Python에서 문자열을 문자 배열로 분할
- How to Parse String to List in Python
- 파이썬에서 여러 구분 기호를 기반으로 문자열을 분할하는 방법
- Python에서 공백으로 문자열 분할
- 파이썬에서 문자열을 반으로 나누기
- Python에서 문자열을 ASCII 값으로 변환
- Python에서 유니 코드 문자를 ASCII 문자열로 변환
- Python에서 숫자 문자열을 배정밀도 부동소수점 수로 변환하는 방법
- Python에서 문자열을 10진수로 변환
- Python 2 및 Python 3에서 바이트를 문자열로 변환하는 방법
- 파이썬에서 문자열을 바이트로 변환하는 방법
- How to Convert Datetime to String in Python
- 파이썬에서 문자열을 날짜 / 시간으로 변환하는 방법
- Python에서 문자열을 변수 이름으로 변환
- How to Stringify JSON in Python
- How to Convert a String to a Float Value in Python
- Python에서 문자열을 정수로 변환
정리 및 삭제
- Python의 문자열에서 xa0을 제거하는 방법
- Python의 문자열에서 쉼표 제거
- 파이썬에서 문자열에서 구두점을 제거하는 방법
- Python의 문자열에서 따옴표 제거
- Python의 문자열에서 특수 문자 제거
- Python의 문자열에서 \n 제거
- 파이썬에서 문자열에서 마지막 문자를 제거하는 방법
- Python의 문자열에서 특정 문자 제거
- Python의 문자열에서 숫자 제거
- Python의 문자열에서 줄 바꿈 제거
- Python의 문자열에서 첫 번째 문자 제거
- Python의 문자열에서 괄호 제거
- 파이썬에서 문자열에서 부분 문자열을 제거하는 방법
- 파이썬에서 문자열에서 공백을 제거하는 방법
찾기, 확인 및 개수 세기
- Python에서 문자열에 Word가 포함되어 있는지 확인
- Python에서 변수가 문자열인지 여부를 확인합니다
- 파이썬에서 문자열이 숫자를 포함하는지 확인하는 방법
- 파이썬에서 문자열이 정수인지 확인
- Python에서 문자열의 문자 위치 찾기
- Python에서 문자열의 문자 발생 횟수 계산
- 파이썬 if 문에서 문자열 비교하기
- 파이썬은 문자열에서 모든 항목 찾기
- Python에서 문자열이 숫자인지 확인
- 파이썬에서 문자열에 하위 문자열이 포함되어 있는지 확인하는 방법
- Python에서 문자열에 단어가 있는지 확인
- Python 문자열에서 문자의 모든 인덱스 찾기
- Python의 문자열에서 부분 문자열 추출
- Python의 문자열에서 숫자 추출
- Python에서 문자열의 단어 계산
- Python을 사용하여 문자열의 모음 세기
- 파이썬에서 가장 긴 공통 부분 문자열
- Python의 목록에서 문자열 찾기
- Python에서 퍼지 문자열 일치
- 목록에 문자열이 포함되어 있는지 Python 확인
- Python 파일에서 문자열 찾기
- 파이썬 방식으로 문자열이 비어 있는지 확인하는 방법
대소문자, 비교 및 채우기
- Python에서 대소 문자를 구분하지 않는 문자열 비교
- Python에서 공백으로 문자열 채우기
- Python에서 문자열 비교
- Python에서 문자별로 두 문자열 비교
- Python에서 0으로 문자열 채우기
- Python의 문자열 대문자
- Python에서 문자열 오른쪽 정렬
- Python 알파벳순으로 문자열 정렬
서식 지정 및 바꾸기
- Python Sprintf: Python의 형식화된 문자열
- Python에서 문자열의 문자 바꾸기
- Python 문자열 형식화에서 % s와 % d의 차이점
- Python의 인덱스에서 문자열의 문자 바꾸기
- String Interpolation in Python
- TypeError 해결: Python에서 문자열 형식 지정 중에 일부 인수가 변환되지 않음
- How to Fix TypeError: Not Enough Arguments for Format String Error in Python
- TypeError 수정: Python에서 Object.__format__에 전달된 비어 있지 않은 형식 문자열
- Python을 사용하여 파일의 문자열 바꾸기
- Python에서 문자열 및 변수 인쇄
추가 문자열 문서
- Python 문자열 암호화
- Python의 문자열 이름에서 함수 호출
- Python에서 문자열 앞의 B
- Python의 원시 문자열
- Python의 원시 문자열 및 유니코드 문자열
- Python에서 문자열 반전
- 파이썬에서 문자열의 순열
- Python에서 파일을 문자열로 읽기
- Python에서 파일에 문자열 쓰기
- Python을 사용하여 문자열을 텍스트 파일로 인쇄
- Python 소켓을 사용하여 문자열 보내기
- Python의 문자열에서 백슬래시 인용
- Python에서 문자열 리터럴을 스캔하는 동안 EOL
- TypeError: __str__이 문자열이 아닌 출력을 반환했습니다.
- 파이썬에서 독스트링 접근하기
- Most Common Docstring Patterns in Python
- 두 문자열의 비트별 XOR을 파이썬에서 수행하는 방법
- Python에서 임의의 문자열 생성
이것이 문자열 클러스터의 처음부터 끝까지입니다. 리스트, 딕셔너리, 파일, 날짜, 오류를 아우르는 더 넓은 지도가 필요하면 Python 필러로 돌아가세요. 거기에는 이 페이지가 확장하는 Strings 그룹과 나란히 Dictionary 그룹과 List 그룹이 있습니다.