
このページの内容
Python チュートリアル:実践 How-To ガイド集
Python は自動化、データ処理、Web バックエンド、科学技術計算に使われる汎用言語で、多くの人は具体的な問題を一つずつ解決しながら身につけていきます。このページは、DelftStack にある 1,400 本以上の Python How-To ガイドの地図です。ガイドは「やりたいこと」ごとにグループ分けされています。テキストの整形、リストと辞書の操作、ファイルと日付の扱い、エラーの修正など、各グループの冒頭には、読者からの質問が最も多いテーマを扱う厳選ガイドを置きました。初めてスクリプトを書く人も、日々の業務で Python を使いながら確かな答えが一つ欲しい人も、まずは学習パスから始めるか、今まさに直面している問題のグループへ直接進んでください。
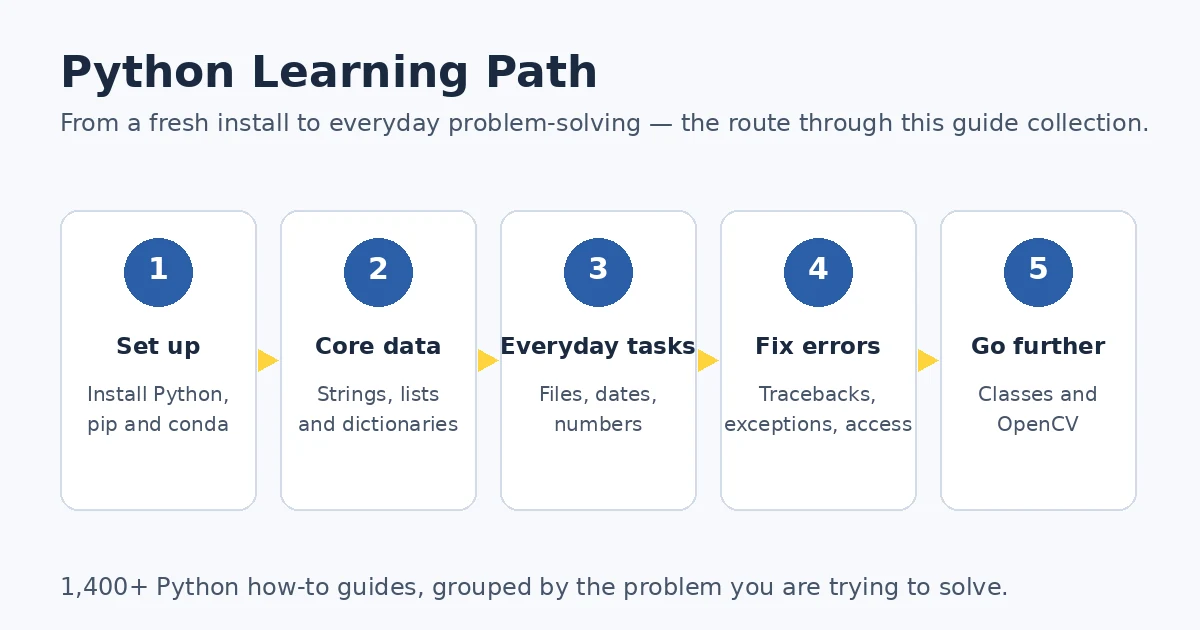
Python 学習パス
1,400 本のガイドを順番に読む必要はありません。確実なルートは、まず環境を整え、次に毎日使うデータ型――文字列、リスト、辞書――を習得し、それからファイル、日付、数値を加え、最後にエラー処理とオブジェクト指向に進むことです。Python ではこの順序が活きます。各段階が前の段階の上に積み上がるからです。テキスト処理が身につけばファイル操作が楽になり、ファイル操作が身につけばデータ処理が楽になり、コードが何をしようとしていたか分かればエラーメッセージは謎ではなくなります。以下の段階をチェックリストとして使い、簡単だと感じたら次へ進んでください。
- 環境構築。 Python をインストールし、Anaconda と Python のバージョン確認で自分が何を実行しているか確かめます。バージョンの混同は「インストールが壊れた」という報告の大きな原因です。
- 基本データ。 文字列をリストに変換する方法と、辞書の最初のキーを取得する方法を学びます。これらの型はほぼすべてのプログラムに登場します。
- 日々のタスク。 ファイルから行を削除する、日時をフォーマットする、移動平均を計算する。下のファイル、日付、数値のグループがこの日常作業をカバーします。
- エラー修正。 コードが壊れたら、ConnectionRefusedErrorをはじめとするエラーガイドが、推測ではなく原因の見つけ方を示します。
- さらに先へ。 オブジェクトの属性を調べ、OpenCV で画像を切り抜きます。クラスと OpenCV のグループが大きなプロジェクトへの橋渡しになります。
このパスの後は、このページをリファレンスとして使ってください。各グループは独立して読めますし、各セクションの下にある索引には厳選リストに収まらない細かな疑問のガイドも含め、1,400 本以上すべてが並びます(自動一覧)。
文字列とテキスト
Python のスクリプトはほぼ必ずテキストを扱います。ユーザー入力、ファイルの内容、スクレイピングした Web ページ、CSV エクスポートなどです。このグループでは、テキストに対して行う4つの操作――変換、クリーニング、比較、そして時には装飾――を扱います。まず変換のガイドを読んでください。文字列を単語や値のリストに変える操作は、あらゆる処理の入口だからです。次はクリーニングです。不可視文字は発見しづらいバグの原因になります。最後に、検証ロジックが置かれることの多い比較へ進みます。コマンドラインツールを作る日が来たら、装飾のガイドも役立ちます。
- Python で文字列をリストに変換する — 文字単位なら
list()、単語や区切り値ならsplit()、リテラル文字列ならast.literal_eval()を選びます。信頼できない入力にeval()は厳禁です。 - Python で太字テキストを出力する — ANSI エスケープシーケンスを直接使う方法と、
termcolorやcoloramaなどのライブラリでターミナル出力を太字にする方法。 - Python で文字列から
\xa0を取り除く — スクレイピングしたテキストに紛れ込む不可視のノーブレークスペースを、unicodedata.normalize()とreplace()で除去します。 - 大文字小文字を区別せずに文字列を比較する —
lower()やupper()でケースを無視して比較し、ßとssのような Unicode ペアを一致させたいときはcasefold()に切り替えます。 - Python で文字列からカンマを取り除く —
str.replace()でカンマをすべて除去し、複雑なパターンにはreモジュールを使います。 - Python で文字列から句読点を取り除く —
string.punctuationフィルタ、正規表現、str.translate()テーブルの3通りの方法で句読点を除去します。
さらに深く: Python 文字列サブハブ では、115 本の文字列ガイドを変換・クリーニング・検索・整形の作業別に整理し、文字列メソッドマップも用意しています。
リスト・辞書とコレクション
リストと辞書は Python の標準コンテナであり、使いこなせるかどうかで「動くだけのスクリプト」と「短くて明快なスクリプト」が分かれます。まずは辞書のガイドから。マッピングにおける「最初」とは挿入順のことだという点と、キーを直接読む方法が整理されています。もう一つの基礎がスライスで、リストの前半・先頭・末尾は日常的に登場します。その後はデータ衛生の話です。実際の数値リストには NaN が混ざって届くため、その上に成り立つ分析が意味を持つよう、極値とばらつきを特定し測定しなければなりません。
- 辞書の最初のキーを取得する —
next(iter(d))、リスト変換、ループのいずれかで辞書の最初のキーを取得します。空の辞書に対する安全なデフォルト値も解説。 - Python でリストから NaN を取り除く —
math.isnan()や NumPy で数値のNaNを除外し、文字列'nan'は別問題として扱います。 - リストの最大値と最小値のインデックスを取得する —
max()とmin()にlist.index()を組み合わせる方法と、NumPy のargmax()とargmin()を使う方法。 - Python でリストの標準偏差を計算する —
statistics.pstdev()や NumPy のstd()でリストのばらつきを測定します。フランス語の検索python écart typeがたどり着く計算です。 - Python でリストを半分に分割する — スライスと
len()でリストを2つに分け、大きな入力にはitertools.islice()で遅延処理します。
エラーと例外
エラーメッセージは構造化された報告です。例外名は「どの前提が崩れたか」を、値は「どこでか」を教えてくれます。このグループは、その前提の順に読んでください。KeyError は、コードが期待したデータが存在しなかったという意味です。スカラーに対する IndexError は、NumPy の値の次元が想定より少なかったという意味です。接続エラーと権限エラーは性質が異なります。コードのロジックは正しくても、環境が操作を拒否したのです。修正はプログラムの書き直しではなく、サーバー、ポート、ファイル権限の確認です。
- ConnectionRefusedError: [Errno 111] Connection refused を修正する — 拒否された TCP 接続を順番に切り分けます。サーバーの起動、正しいインターフェースとポート、ファイアウォールの確認。
- Python の KeyError 0 を解決する —
KeyError: 0は辞書にキー0がないという意味です。try/exceptやdict.get()で検索をガードします。 - IndexError: invalid index to scalar variable を修正する — すでにスカラーの値にインデックスを付けたときに NumPy が出すエラー。
ndimとshapeを確認し、小さな配列が欲しいときはスライスします。 - PermissionError: [WinError 5] Access is denied を修正する — Windows のアクセス拒否を、権限の確認、ファイルを使用中のプログラムを閉じること、所有権の変更、管理者として実行することで修正します。
数値・数学と演算子
この小さなグループは複数の言語で大きな需要を集めています。各ガイドが「検索ボックスに入力しづらい質問」に答えているからです。XOR のガイドは概念編です。ビット演算はフラグ、チェックサム、そして有名な変数交換トリックの基礎であり、コピーするより理解する価値があります。移動平均のガイドは実践編で、多くの読者にとって最初の時系列ツールです。残りの2本は実際のバグの原因になる用語を整理します。Euler 数には入力の形によって3つの「正しい」関数があり、float の切り捨ては丸めとは別の操作です。
- Python の XOR —
^をビット単位および真偽値の XOR に使い、真理値表と変数交換トリックを学びます。 - Python で移動平均を計算する —
convolveやcumsumで作る移動平均で NumPy 系列を平滑化し、大規模データには pandas や Bottleneck を使います。 - Python の Euler 数 — 定数は
math.e、スカラーにはmath.exp()、配列にはnumpy.exp()、ゼロ近傍ではexpm1()を使います。 - Python で float を切り捨てる — float を指定した小数桁で切り捨て、
round()と真の切り捨ての違いを確認します。
環境とセットアップ
環境の問題は他のすべてを止めてしまうため、このグループは「プログラミング」そのものではなくてもコレクションの入口に置かれています。出会う順番通りに進めてください。初日には、自分が実際に持っている Python と conda を確認します。バージョン確認のガイドがあるのは、この2つが別の数値でありながら常に混同されるからです。プロジェクトが正確なパッケージ版を必要とするなら pip で固定します。pip がインストールするのはパッケージであり、インタープリタではないことも覚えておきましょう。アンインストールのガイドは、きれいにやり直すためのものです。
- Python と Anaconda のバージョンを確認する — 2つの数値を区別します。
conda -Vはパッケージマネージャ、python -Vは有効な環境のインタープリタを報告します。 - Miniconda を完全にアンインストールする — Windows、macOS、Linux で安全に削除します。先に環境をエクスポートし、インストール接頭辞を確認し、残存ファイルの掃除はリセット時のみ。
- Ubuntu で Python をアンインストールする —
apt removeで Python を削除し、設定ファイルも消すならpurge、仕上げにautoremoveを使います。 - pip を使わずに Python パッケージをインストールする — PyPI からソース配布物をダウンロードして
setup.pyを実行する手動インストール。pip が使えないマシン向けです。 - pip で特定のパッケージバージョンをインストールする —
python -m pip install PACKAGE==VERSIONで正確なリリースを固定し、分離した環境で検証します。
日付と時刻
日付と時刻のコードは、別のシステム向けに書式化したり、確実に並べ替えたり、タイムゾーンをまたいで比較したりするまでは簡単に見えます。この3本のガイドは、日々の datetime 作業のほぼすべてをカバーします。書式化が最初なのは、最も検索されるからです。ミリ秒のガイドは、よくある検索 python datetime to string の受け皿であり、安易なスライスという近道が値を壊す理由も示します。並べ替えは、sorted() が datetime オブジェクトを受け付けることを知れば1つの関数で済みます。引き算にこそ本当の注意点があります。結果は timedelta であり、ナイーブな値とタイムゾーン対応の値を混ぜるとエラーになります。ここで先に出会っておきましょう。
- datetime をミリ秒付きの文字列に変換する —
isoformat(timespec="milliseconds")かstrftime()と%fで、ちょうど3桁のミリ秒を持つ書式に変換し、オフセットも保持します。 - Python で日付と時刻を並べ替える — 日付文字列から
datetimeオブジェクトのリストまで、sorted()で昇順にも降順にも並べ替えます。 - Python で datetime を引き算する — datetime 同士の引き算で
timedeltaを得て、total_seconds()で秒・分・時間に読み替えます。
ファイル・データ形式とシステム
Python のファイル操作は「読む、変換する、書き戻す」という1つのパターンに従い、行削除のガイドはその典型例です。大きすぎてメモリに載らないファイル向けのメモリ安全な変種も含みます。このグループのもう半分は、コードがどこに住むかという話です。モジュール置き場のフォルダには、Python が単位として読み込むためのパッケージ構造が必要な理由と、モジュール名が事前に分からないときの動的読み込みを、インポートのガイドが説明します。ホイールのガイドで輪が閉じます。.whl ファイルはインデックスのないマシンへパッケージを届ける手段であり、そのファイル名が自分のインタープリタに合うかどうかを教えてくれます。ロックされたサーバーでもよくある状況です。
- Python でファイルから行を削除する — 読んで、選別して、書き戻すことで、番号指定の行や先頭・末尾の行だけを削除します。大きなファイルにはストリーミング方式も。
- ディレクトリ内のモジュールをすべてインポートする — フォルダをパッケージとして全モジュールを読み込みます。明示的な
__init__.pyインポート、またはimportlibによる発見。 - Python パッケージの .whl ファイルをインストールする — ファイル名の互換性タグから始めて、ローカルの
.whlをpython -m pip installでインストールします。
関数・クラスとオブジェクト
このグループは意図的に絞り込まれています。3本のガイドがそれぞれ大きなテーマの扉を開きます。シグモイドのガイドは機械学習への橋渡しです。活性化関数をゼロから実装し、素朴な公式にはない数値的に安定した形も示します。属性のガイドは、装いを変えたデバッグ技術です。「なぜこのオブジェクトがおかしいのか」という調査の大半は、オブジェクトが実際に何を保持しているか出力することから始まり、Python にはその見方が4通りあります。クラス変数のガイドは、オブジェクト指向 Python で最も根強い初心者の誤解を解きます。クラス本体で定義した変数は全インスタンスで共有され、global キーワードとは無関係です。
- Python のシグモイド関数 —
math.exp()でシグモイドを実装して数値的に安定化し、配列には NumPy や SciPy のexpitに切り替えます。 - オブジェクトの属性を出力する — ドットアクセス、
getattr()、保存データの__dict__、すべてのdir()という4通りの方法でオブジェクトを調べます。 - Python でクラス変数を定義する — クラス本体でクラス変数を定義して
ClassName.attributeとして読み、globalとの違いを確認します。
OpenCVと画像処理
OpenCV は Python コレクションの中の独立した関心クラスターです。一般プログラミングではなく画像処理なので、ここでは1つの集中セクションとし、専用のサブガイドは後日用意します。順序が大切です。切り抜きが最初なのは、中心となる考え方を教えてくれるからです。OpenCV の画像は NumPy 配列であり、ほとんどの操作は配列操作です。矩形検出はその上に輪郭――形を見つける標準的な方法――を積み上げます。solvePnP による姿勢推定は応用編で、2D 画像点、3D モデル点、カメラキャリブレーションを組み合わせます。
- OpenCV で画像を切り抜く — NumPy 配列のスライス、関心領域の定義、マウスによる対話的選択で画像を切り抜きます。
- OpenCV の solvePnP() 関数を使う — カメラ行列と顔ランドマークの例を通じて、
cv2.solvePnPで2D–3D 点対応からオブジェクトの姿勢を推定します。 - OpenCV で矩形を検出する — 輪郭を見つけ、面積で順位付けし、4つの角を持つ多角形を残して矩形を検出します。代替手段として
HoughLinesP()も紹介。
よくある質問
Pythonで文字列をリストに変換するには?
各要素が何であるべきかによって変わります。文を単語に分けるなら引数なしの split()、カンマ区切りの値なら split(",") を呼びます。1文字ずつ要素にしたいなら list(text) を使います。文字列が "[1, 2, 3]" のような Python リテラル構文をすでに含んでいる場合は、任意のコードを実行してしまう eval() ではなく ast.literal_eval() で解析してください。各ケースは文字列をリストに変換するガイドで扱っており、引用符付き CSV フィールドも含まれます。
[:-1] は何をするものですか?
[:-1] は「先頭から、最後の要素を含めず、それより前まで」というスライスです。文字列に適用すれば最後の1文字を除いた全体が、リストに適用すれば最後の要素を除いた新しいリストが返ります。スライスは新しいオブジェクトを作るため、[:-1] は末尾の改行を落とす標準的な方法になっています。
ConnectionRefusedError [Errno 111] はどう直しますか?
このエラーは TCP 接続が能動的に拒否されたことを意味します。通常は、クライアントが使ったアドレスとポートで何も待ち受けていません。まずサーバーを起動し、クライアントが同じアドレスとポートを向いているか確認してください。127.0.0.1 にバインドされたサーバーは同じマシンからの接続しか受け付けません。別のコンピュータからならファイアウォールを確認してください。切り分けの順序はConnectionRefusedError ガイドで解説しています。
Anaconda / Python のバージョンを確認するには?
Anaconda Prompt を開き、conda のバージョンには conda -V、Python のバージョンには python -V を実行します。この2つは別の数値で、混同こそがバージョン確認で最も多い間違いです。Python の結果は、そのプロンプトで有効な環境を反映します。プロジェクト環境を先に有効化してください。全体像には conda list が両方のパッケージ行を示し、conda info が両バージョンを出力します。詳しくはAnaconda バージョン確認ガイドへ。
文字列から \xa0 を取り除くには?
\xa0 はノーブレークスペースです。見た目は空白でも通常の空白と等しくならない Unicode 文字で、Web ページなどからコピーしたテキストに混入します。確実な除去方法は2つあります。unicodedata.normalize("NFKD", text) で通常の空白に分解する方法と、text.replace("\xa0", " ") で直接置き換える方法です。削除するより空白に置き換えるほうが安全です。単語同士がくっついてしまうのを防げます。方法の比較は\xa0 除去ガイドにあります。
Pythonをアンインストールするには(Ubuntu / Windows / Miniconda)?
正しい方法は Python のインストール方法によって異なります。Ubuntu では sudo apt-get remove python3 でパッケージを削除し、設定ファイルも消すなら purge、仕上げに autoremove で孤立した依存関係を片付けます。Miniconda の場合は、残したい環境を先にエクスポートし、公式アンインストーラを使い、手作業で削除する前に接頭辞を確認してください。どちらのケースも、Ubuntu のアンインストールガイドとMiniconda のアンインストールガイドで手順を追って解説しています。
次のステップ
上のグループのうち2つは、専用サブガイドへと育ちつつあります。このコレクションで最もクリックされるグループ「文字列とテキスト」と、切実な問題を抱えた読者がたどり着く「エラーと例外」です。それらが公開されるまでは、上のセクションが入口です。静的型付けの言語や別のエコシステムへ仕事が移ったら、同じ「問題から入る」構成のJava の How-To ガイドやC# の How-To ガイドへ進んでください。