
HOWTO · Python
Python での NumPy 配列の移動平均
このチュートリアルでは、Python で numpy 配列の移動平均を計算する方法を示します
このページの内容
単純移動平均は、連続する値を固定サイズのウィンドウに分け、その平均を求めたものです。NumPy配列では numpy.convolve または numpy.cumsum で直接計算できます。また、bottleneck.move_mean や、rolling().mean() を使う pandas も選べます。ウィンドウサイズが4なら、各結果は隣接する4つの入力値をまとめた平均です。移動平均を使うと短期的な変動がなめらかになり、傾向を把握しやすくなります。一方、加重移動平均では新しいデータほど大きな重みを与えます。
以下の例では12個の値を使います。最初の方法では、4つの値がそろったウィンドウごとに結果が1つ得られるため、結果は9個です。どの範囲の観測値を平均するかに合わせてウィンドウサイズを選びましょう。サイズを変えると、平滑化の度合いと有効なウィンドウの結果数が変わります。
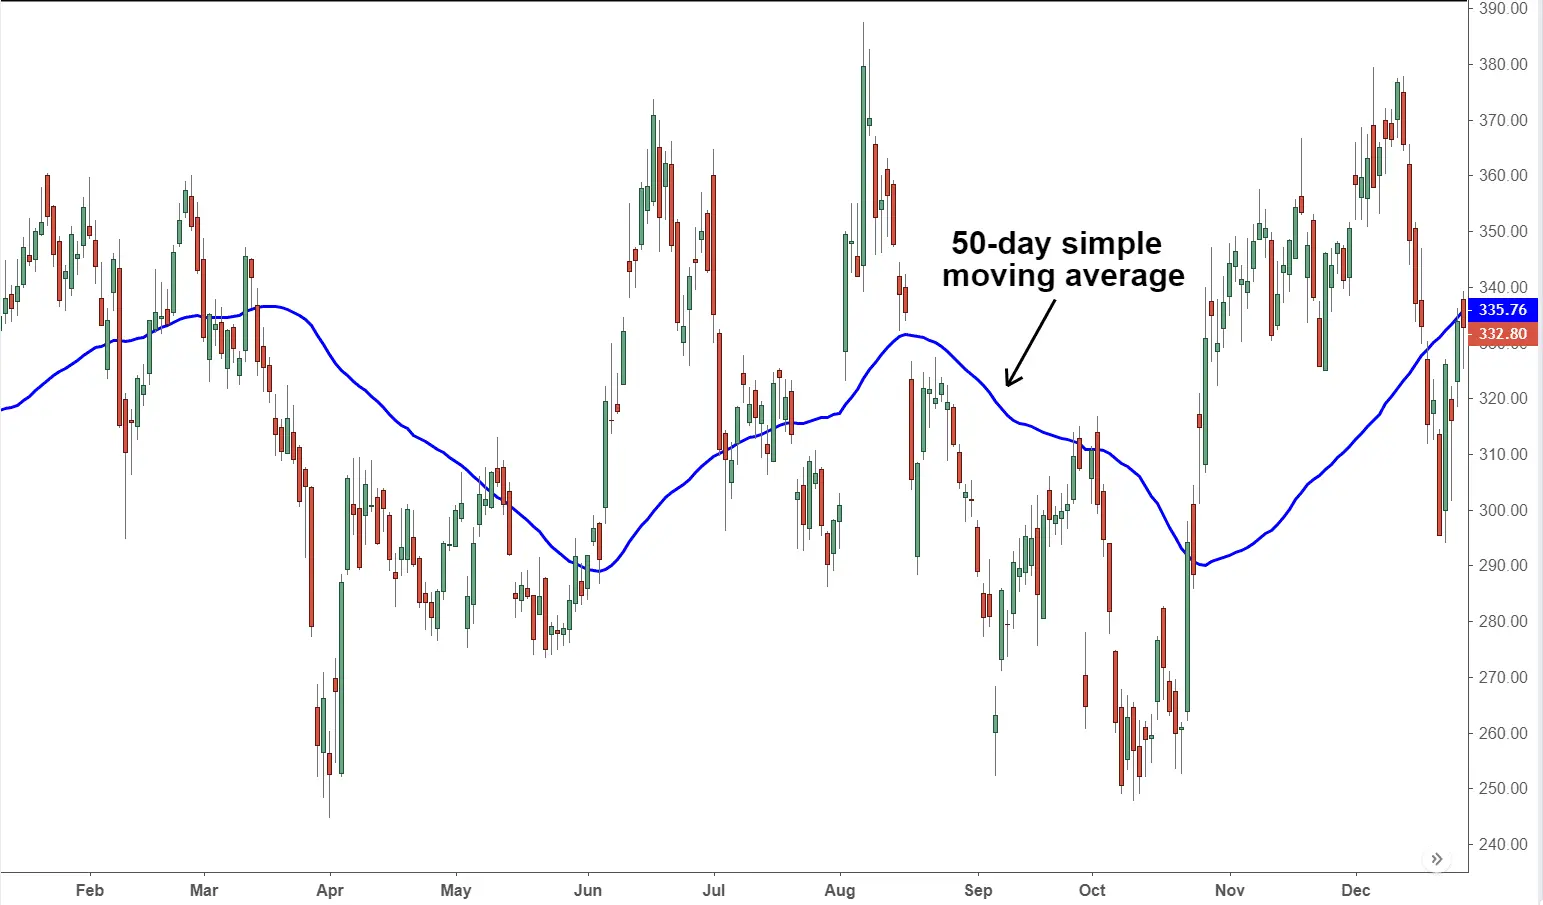
コード例と出力に含まれるラベルは変更されず、英語のままです。
numpy.convolve で NumPy 配列の移動平均を計算する
numpy.convolve は線形畳み込みを計算します。ここでは2つ目の配列に4個の1を入れているため、畳み込みの各結果は4つの値の合計です。その合計を4で割ると平均になります。valid モードでは入力データに完全に収まるウィンドウだけが対象になるため、入力が12個、ウィンドウサイズが4なら結果は9個です。結果は左から順に各ウィンドウに対応します。最初の平均は入力位置0〜3、最後の平均は位置8〜11の値から計算されます。
import numpy as np


def moving_average(values, window):
    weights = np.ones(window) / window
    return np.convolve(values, weights, mode="valid")

data = np.array([10, 5, 8, 9, 15, 22, 26, 11, 15, 16, 18, 7])
print(moving_average(data, 4))
[ 8. 9.25 13.5 18. 18.5 18.5 17. 15. 14. ]
numpy.cumsum で NumPy 配列の移動平均を計算する
累積和を使うと、ウィンドウの末尾までの累積合計から、その直前までの累積合計を引いて、各ウィンドウの合計を求められます。最初のウィンドウには差し引く前の累積合計がないため、この関数は最初の完全なウィンドウから結果を切り出します。これにより、numpy.convolve の例と同じ9個の平均が得られます。この方法では、累積合計からウィンドウごとの合計を組み立てる仕組みを確認できます。各合計をウィンドウサイズで割れば平均になります。
import numpy as np


def moving_average(values, window):
    cumulative = np.cumsum(values, dtype=float)
    cumulative[window:] -= cumulative[:-window]
    return cumulative[window - 1:] / window

data = np.array([10, 5, 8, 9, 15, 22, 26, 11, 15, 16, 18, 7])
print(moving_average(data, 4))
[ 8. 9.25 13.5 18. 18.5 18.5 17. 15. 14. ]
bottleneck モジュールで移動平均を計算する
bottleneck パッケージには、配列の移動平均を計算する move_mean があります。既定ではウィンドウ全体の値がそろってから計算するため、サイズ4の場合、最初の3位置では結果を求められず、インデックス3から最初の平均が得られます。結果の長さは入力と同じで、先頭の位置には nan が入ります。例では、bottleneck が利用できる場合はそれを使い、インストールされていない環境向けに簡単な純粋なPythonの代替処理も示します。入力と同じ数の結果位置を保ちたい場合に便利です。先頭の nan は、完全なウィンドウがまだできていないことを示します。
from importlib.util import find_spec


data = [10, 5, 8, 9, 15, 22, 26, 11, 15, 16, 18, 7]
window = 4

if find_spec("bottleneck") is not None:
    import bottleneck as bn

    result = bn.move_mean(data, window=window).tolist()
else:
    result = [float("nan")] * (window - 1)
    result.extend(
        sum(data[start:start + window]) / window
        for start in range(len(data) - window + 1)
    )

print(result)
[nan, nan, nan, 8.0, 9.25, 13.5, 18.0, 18.5, 18.5, 17.0, 15.0, 14.0]
pandas モジュールで移動平均を計算する
pandas の Series に格納された時系列データでは、rolling(4).mean() を呼び出して、値が4つそろった各ウィンドウの平均を計算できます。既定ではSeriesの長さとインデックスが保たれます。最初の3項目は、その位置までに4つの値がそろわないため NaN になり、最初の平均はインデックス3に対応します。ここでも他の例と同じ値が得られますが、Seriesのインデックスを使うと、各結果を元の観測値と簡単に対応付けられます。ウィンドウサイズが変数に入っている場合は、その変数を rolling() に渡せます。
import pandas as pd


data = [10, 5, 8, 9, 15, 22, 26, 11, 15, 16, 18, 7]
series = pd.Series(data)
print(series.rolling(4).mean())
0       NaN
1       NaN
2       NaN
3      8.00
4      9.25
5     13.50
6     18.00
7     18.50
8     18.50
9     17.00
10    15.00
11    14.00
dtype: float64
