HOWTO · Seaborn
Wie man Seaborn-Liniendiagramme erstellt
Dieses Tutorial zeigt, wie man in Python mit dem Modul Seaborn Liniendiagramme erstellt. Lernen Sie, Daten effektiv mit anpassbaren Liniendiagrammen, Konfidenzintervallen und mehreren Linien für vergleichende Analysen zu visualisieren. Perfekt für Anfänger und erfahrene Benutzer, die ihre Fähigkeiten in der Datenvisualisierung verbessern möchten.
Auf dieser Seite
Ein Seaborn-Liniendiagramm ordnet Werte einer x-Variablen und einer y-Variablen Punkten zu, die durch eine Linie verbunden sind. Es wird häufig für Zeitreihen verwendet, aber x kann eine beliebige geordnete oder kontinuierliche Variable sein. Die Funktion seaborn.lineplot() kann außerdem wiederholte Beobachtungen zusammenfassen und für Kategorien getrennte Linien zeichnen, was sie nützlich macht, um zu untersuchen, wie sich Messwerte verändern, und um Gruppen zu vergleichen.
Erste Schritte mit Seaborn
Seaborn ist eine Bibliothek für statistische Diagramme, die auf Matplotlib aufbaut. Die folgenden Beispiele verwenden ein pandas DataFrame, eine bequeme Möglichkeit, benannte Spalten zusammenzuhalten. Installieren Sie Seaborn und seine Abhängigkeiten in Ihrer Python-Umgebung, falls sie noch nicht verfügbar sind; importieren Sie dann Seaborn und Matplotlib. In den Diagrammbeispielen ist kein separater Installationsbefehl nötig.
Die Beispiele in diesem Tutorial wurden mit Seaborn 0.13.2, Matplotlib 3.11.2 und pandas 3.1.0 unter Python 3.12 ausgeführt und überprüft, und jede Abbildung unten ist die Ausgabe, die diese Beispiele tatsächlich erzeugt haben.
Ein einfaches Liniendiagramm erstellen
Übergeben Sie das DataFrame an data und benennen Sie die Spalten für x und y. Das folgende Beispiel verwendet feste Werte, sodass die gezeichneten Punkte reproduzierbar sind. Der Aufruf von plt.show() öffnet die Abbildung in einer interaktiven Umgebung; in einem Notebook wird die Abbildung üblicherweise als Ergebnis der Zelle angezeigt.
Führen Sie dieses Beispiel aus:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitors")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Visitors by day")
plt.tight_layout()
plt.show()
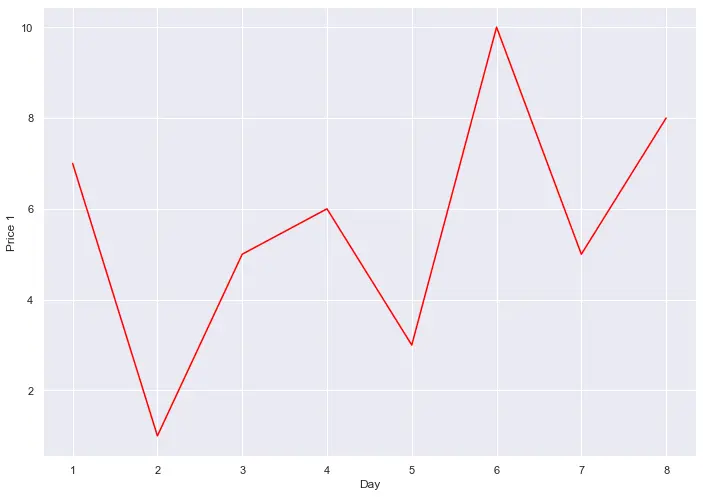
Die horizontale Achse verwendet day, die vertikale Achse verwendet visitors. Ersetzen Sie diese Namen und Werte durch Spalten aus Ihrer eigenen Tabelle. Wenn Zeilen denselben x-Wert teilen, kann Seaborn die y-Beobachtungen an dieser Position aggregieren und ein Unsicherheitsband anzeigen; die nächsten Abschnitte erklären, wie diese Merkmale zu interpretieren sind.
Liniendiagramme anpassen
Einstellungen zum Erscheinungsbild helfen einem Leser, eine Reihe zu unterscheiden oder ihren Werten zu folgen. So legt color eine Linienfarbe fest, marker platziert ein Symbol an jeder Beobachtung, und linestyle ändert das Strichmuster. Dies sind visuelle Entscheidungen; sie erzeugen keine Gruppen und ändern nicht, welche Zeilen zu den Daten gehören. Wählen Sie Farben und Marker, die in der Größe, in der die Abbildung gelesen wird, leicht zu unterscheiden bleiben.
Verwenden Sie dieselbe deterministische Tabelle wie oben in einem Skript, in dem die Importe und die Definition von data enthalten sind. Diese vollständige Variante betont die Punkte mit einer gestrichelten Linie:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitors", color="darkorange", marker="o", linestyle="--")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Visitors by day")
plt.tight_layout()
plt.show()
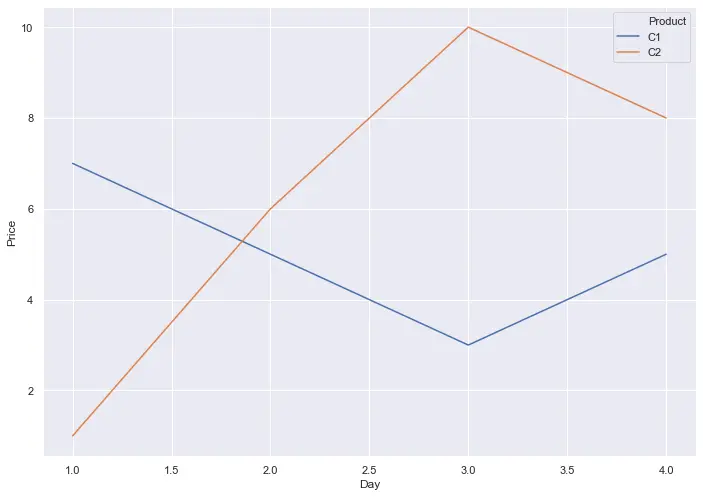
Für ein anderes Erscheinungsbild ändern Sie diese Argumente oder verwenden Matplotlib-Methoden, um Beschriftungen und Titel festzulegen. Halten Sie die Zuordnung von x und y explizit, damit spätere Leser erkennen können, was jeder Punkt darstellt.
Konfidenzintervalle hinzufügen
Ein Unsicherheitsband um eine Linie fasst Variation oder Unsicherheit um eine Schätzung zusammen. Seine Bedeutung hängt von den Daten und dem Schätzer ab: Wenn mehrere Beobachtungen zu einer x-Position beitragen, kann die Mittellinie sie zusammenfassen, und das Band vermittelt die Unsicherheit um diese Zusammenfassung. Es ist nicht einfach ein anderer Name für die Standardabweichung. Die Standardabweichung beschreibt die Streuung unter den Beobachtungen; ein Konfidenzintervall beschreibt die Unsicherheit einer geschätzten Größe.
Das folgende Beispiel gibt jedem Tag drei Beobachtungen. Der Code gibt zuerst den Mittelwert jeder Gruppe aus, sodass Sie die gezeichnete Linie anhand einfacher Zahlen überprüfen können:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4],
    "visitors": [10, 12, 14, 14, 16, 18, 13, 15, 17, 19, 21, 23],
})

print(data.groupby("day")["visitors"].mean())

sns.lineplot(data=data, x="day", y="visitors", marker="o")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Mean visitors by day with 95% confidence band")
plt.tight_layout()
plt.show()
Ausgabe:
day
1    12.0
2    16.0
3    15.0
4    21.0
Name: visitors, dtype: float64
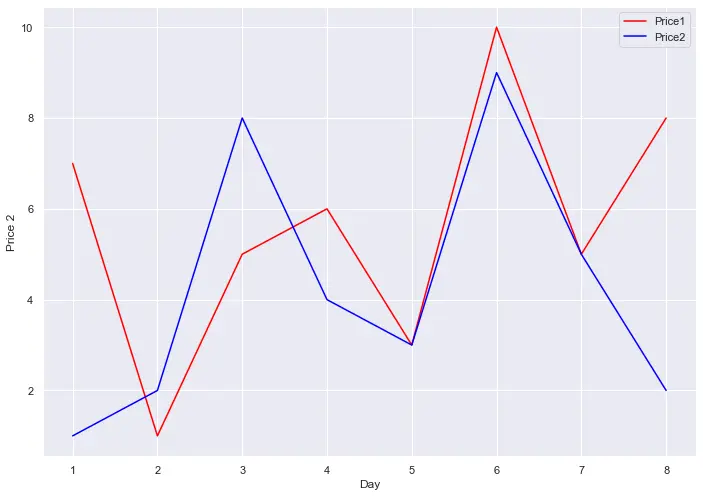
Die Mittellinie verläuft durch die ausgegebenen Mittelwerte (12, 16, 15 und 21): Bei wiederholten Beobachtungen aggregiert lineplot() jede x-Gruppe standardmäßig mit dem Mittelwert. Das schattierte Band ist das 95-%-Konfidenzintervall für diesen Mittelwert, berechnet durch Bootstrapping. Wo eine Gruppe stärker streut, ist das Band breiter; es sagt nichts darüber aus, wo einzelne Beobachtungen liegen.
Prüfen Sie vor der Interpretation eines Bandes, ob jeder x-Wert wiederholte Beobachtungen hat und was diese Beobachtungen darstellen. Wiederholte Messungen an demselben Subjekt stellen beispielsweise nicht unbedingt unabhängige Stichproben dar. Mit nur einer Beobachtung an jedem x-Wert gibt es keine Replikation innerhalb einer Position, aus der sich auf dieselbe Weise auf Variation schließen ließe. Die angemessene Interpretation hängt auch von der verwendeten Seaborn-Version und den Diagrammoptionen ab. Die Beispiele hier verwenden den Parameter errorbar, der seit Seaborn 0.12 verfügbar ist; in Seaborn 0.13.2 ist der Standardwert errorbar=("ci", 95), und errorbar="sd" zeichnet stattdessen ein Band, das eine Standardabweichung auf beiden Seiten des Mittelwerts umfasst. Konsultieren Sie die Dokumentation der installierten Version, wenn Sie den Schätzer oder die Intervallmethode steuern müssen. Wenn das Band für Ihre Daten nicht aussagekräftig ist, konfigurieren Sie das Diagramm entsprechend oder lassen es weg und erklären, wie die Linie berechnet wurde.
Wenn das Band nicht aussagekräftig ist, schalten Sie es mit errorbar=None aus. Die Aggregation findet weiterhin statt — die Linie verbindet weiterhin die Gruppenmittelwerte — aber es wird kein Band gezeichnet:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4],
    "visitors": [10, 12, 14, 14, 16, 18, 13, 15, 17, 19, 21, 23],
})

sns.lineplot(data=data, x="day", y="visitors", marker="o", errorbar=None)
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Mean visitors by day without uncertainty band")
plt.tight_layout()
plt.show()
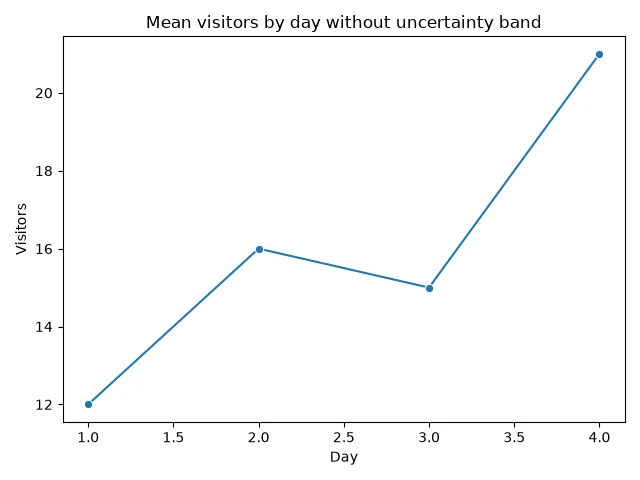
Die beiden Abbildungen zeichnen dieselben Mittelwerte; nur das Band unterscheidet sich. Entscheiden Sie sich zwischen ihnen danach, ob die Zusammenfassung der Unsicherheit dem Leser hilft, nicht danach, welche Abbildung sauberer aussieht.
Mehrere Linien zeichnen
Für Vergleiche nach Kategorien fügen Sie eine Kategoriespalte ein und ordnen sie hue zu. Seaborn zeichnet für jede Kategorie eine eigene farbige Linie und fügt eine Legende hinzu. Ordnen Sie style derselben oder einer anderen Kategoriespalte zu, wenn Linienmuster eine zusätzliche visuelle Unterscheidung liefern können. Verwenden Sie Kategorien nur, wenn die Zeilen dieselben x- und y-Maße teilen; halten Sie Beschriftungen und Einheiten über die Gruppen hinweg konsistent.
Hier ist ein vollständiges Beispiel mit gruppierten Daten und festen Beobachtungen:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "week": [1, 2, 3, 1, 2, 3],
    "orders": [8, 11, 14, 6, 9, 10],
    "store": ["North", "North", "North", "South", "South", "South"],
})

sns.lineplot(data=data, x="week", y="orders", hue="store", style="store", markers=True, dashes=True)
plt.xlabel("Week")
plt.ylabel("Orders")
plt.title("Orders by store")
plt.tight_layout()
plt.show()
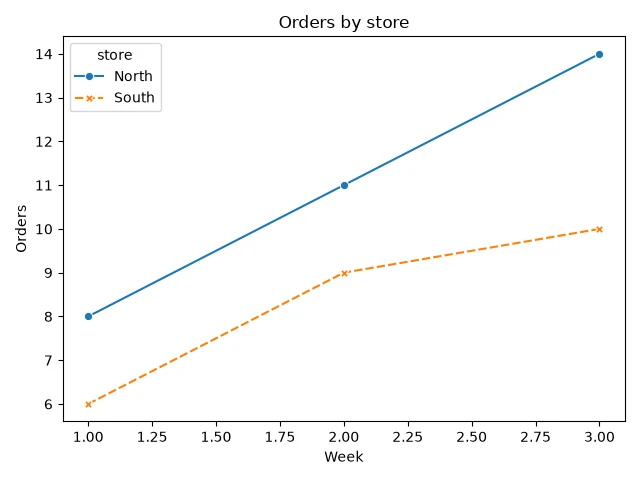
Wenn die Daten stattdessen für jede Reihe eigene numerische Spalten haben, formen Sie sie zu einer langen Tabelle mit einer Wertespalte und einer Spalte für den Reihennamen um und ordnen den Reihennamen dann hue zu. Alternativ zeichnen Sie jede y-Spalte auf gemeinsame Matplotlib-Achsen und weisen jeder Linie eine Beschriftung zu, bevor Sie eine Legende hinzufügen. In beiden Ansätzen sollte die Legende jede Linie identifizieren und zu ihren Daten passen. Verwenden Sie keine Kategoriedarstellung, um unterschiedliche Einheiten oder Skalen zu verbergen; erwägen Sie getrennte Achsen oder getrennte Abbildungen, wenn ein direkter Vergleich irreführen würde.
Einen falsch geschriebenen Spaltennamen korrigieren
Die an x und y übergebenen Namen müssen exakt mit den Spaltennamen in data übereinstimmen. Wenn ein Name falsch geschrieben ist, löst lineplot() einen Fehler aus, bevor irgendetwas gezeichnet wird. Dieser Aufruf verlangt eine Spalte namens visitor, aber das DataFrame hat nur visitors:
import pandas as pd
import seaborn as sns

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitor")
Ausgabe:
ValueError: Could not interpret value `visitor` for `y`. An entry with this name does not appear in `data`.
Die Meldung nennt das Argument (y), den fehlgeschlagenen Wert (visitor) und den Grund, wodurch sich dieser Fehler schnell beheben lässt: Vergleichen Sie den Namen mit den tatsächlichen Spalten — das Ausgeben von data.columns listet sie auf — und korrigieren Sie die Schreibweise. Derselbe Fehler tritt bei x oder bei einer falsch geschriebenen hue- oder style-Spalte auf.
Fazit
Verwenden Sie seaborn.lineplot(), um y-Messungen über x-Werte hinweg zu verbinden, und wählen Sie dann Einstellungen zum Erscheinungsbild oder Kategoriezuordnungen, um die Abbildung lesbar zu machen. Prüfen Sie, wie wiederholte Beobachtungen zusammengefasst werden, bevor Sie ein Unsicherheitsband interpretieren, und beschriften Sie jede verglichene Reihe klar.
Häufige Fragen
- Was fügt Seaborn zu Matplotlib hinzu? Seaborn bietet eine höherstufige Schnittstelle für statistische Grafiken und arbeitet mit Matplotlib für die Anzeige der Abbildungen und weitere Formatierungen zusammen.
- Kann ich ein pandas DataFrame übergeben? Ja. Setzen Sie
dataauf das DataFrame und übergeben Sie Spaltennamen anxundy. - Wie ändere ich das Erscheinungsbild der Linie? Verwenden Sie Optionen wie
color,markerundlinestyle; diese ändern das Erscheinungsbild, währendhueKategorien getrennten Linien zuordnet. - Was bedeutet das schattierte Band? Es stellt eine Unsicherheitszusammenfassung dar, die mit der gezeichneten Schätzung verbunden ist. Ihre Interpretation hängt von wiederholten Beobachtungen, dem Schätzer und der gewählten Intervallmethode ab; sie ist nicht automatisch eine Standardabweichung.
- Wie kann ich mehrere Linien vergleichen? Ordnen Sie eine Kategoriespalte
huezu oder zeichnen Sie getrennt beschriftete Reihen auf gemeinsamen Achsen. Stellen Sie sicher, dass die Legende jede Linie genau benennt. - Wie entferne ich das schattierte Band? Übergeben Sie
errorbar=None. Die Linie aggregiert wiederholte Beobachtungen weiterhin mit dem Mittelwert; nur das Unsicherheitsband wird weggelassen.