HOWTO · Seaborn
Come creare grafici a linee con Seaborn
Questo tutorial mostra come creare grafici a linee in Python utilizzando il modulo Seaborn. Impara a visualizzare i dati in modo efficace con grafici a linee personalizzabili, intervalli di confidenza e più linee per l'analisi comparativa. Perfetto sia per i principianti sia per gli utenti esperti che vogliono migliorare le proprie capacità di visualizzazione dei dati.
In questa pagina
Un grafico a linee di Seaborn associa i valori di una variabile x e di una variabile y a punti uniti da una linea. Viene spesso utilizzato per le serie temporali, ma x può essere qualsiasi variabile ordinata o continua. La funzione seaborn.lineplot() può anche riassumere osservazioni ripetute e disegnare linee separate per le categorie, rendendola utile per esplorare come cambiano le misurazioni e confrontare i gruppi.
Iniziare con Seaborn
Seaborn è una libreria di grafici statistici costruita su Matplotlib. Gli esempi seguenti utilizzano un DataFrame di pandas, un modo comodo per tenere insieme colonne con nome. Installa Seaborn e le sue dipendenze nel tuo ambiente Python se non sono già disponibili; poi importa Seaborn e Matplotlib. Negli esempi di grafico non è necessario alcun comando di installazione separato.
Gli esempi di questo tutorial sono stati eseguiti e verificati con Seaborn 0.13.2, Matplotlib 3.11.2 e pandas 3.1.0 su Python 3.12, e ogni figura seguente è l’output che tali esempi hanno effettivamente prodotto.
Creare un grafico a linee di base
Passa il DataFrame a data e indica le colonne per x e y. L’esempio seguente utilizza valori fissi, quindi i punti disegnati sono riproducibili. La chiamata a plt.show() apre la figura in un ambiente interattivo; in un notebook, la figura viene comunemente mostrata come risultato della cella.
Esegui questo esempio:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitors")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Visitors by day")
plt.tight_layout()
plt.show()
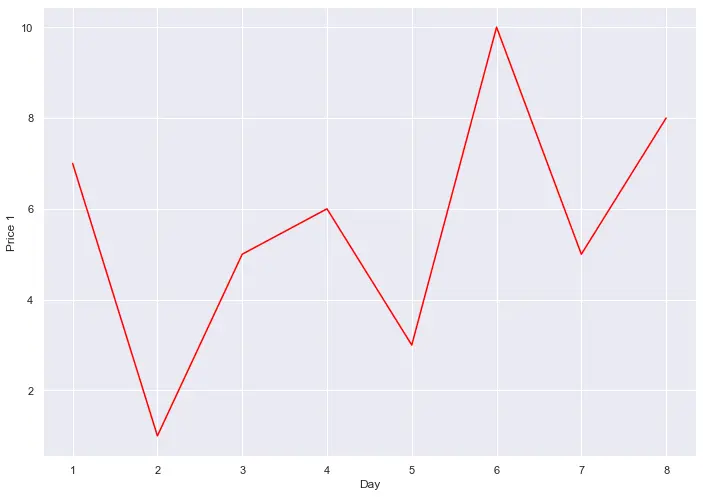
L’asse orizzontale utilizza day, e l’asse verticale utilizza visitors. Sostituisci questi nomi e valori con le colonne della tua tabella. Se le righe condividono un valore di x, Seaborn può aggregare le osservazioni di y in quella posizione e mostrare una banda di incertezza; le sezioni seguenti spiegano come interpretare queste caratteristiche.
Personalizzare i grafici a linee
Le impostazioni di aspetto aiutano il lettore a distinguere una serie o a seguirne i valori. Ad esempio, color imposta il colore di una linea, marker posiziona un simbolo a ogni osservazione, e linestyle cambia il motivo del tratto. Sono scelte visive; non creano gruppi e non cambiano quali righe appartengono ai dati. Scegli colori e marcatori che restino facili da distinguere alla dimensione alla quale la figura verrà letta.
Usa la stessa tabella deterministica di cui sopra in uno script in cui sono incluse le importazioni e la definizione di data. Questa variante completa enfatizza i punti con una linea tratteggiata:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitors", color="darkorange", marker="o", linestyle="--")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Visitors by day")
plt.tight_layout()
plt.show()
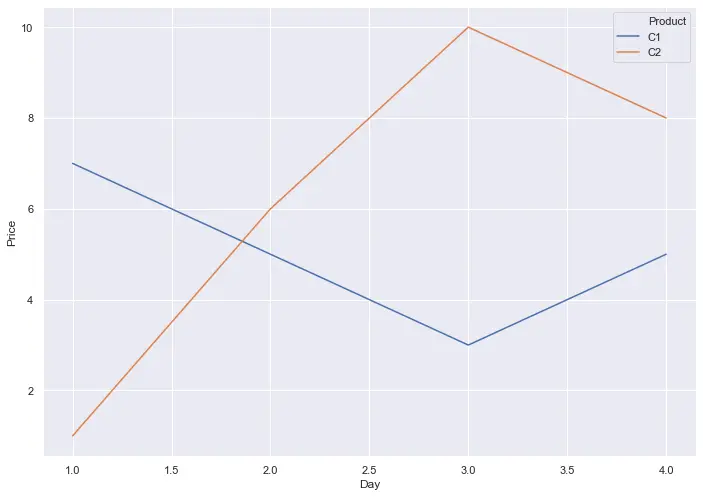
Per un aspetto diverso, cambia questi argomenti o usa i metodi di Matplotlib per impostare etichette e titoli. Mantieni esplicita la mappatura di x e y in modo che i lettori successivi possano capire cosa rappresenta ciascun punto.
Aggiungere intervalli di confidenza
Una banda di incertezza intorno a una linea riassume la variazione o l’incertezza intorno a una stima. Il suo significato dipende dai dati e dallo stimatore: quando più osservazioni contribuiscono a una posizione x, la linea centrale può riassumerle, e la banda comunica l’incertezza intorno a quel riepilogo. Non è semplicemente un altro nome per la deviazione standard. La deviazione standard descrive la dispersione tra le osservazioni; un intervallo di confidenza descrive l’incertezza di una quantità stimata.
L’esempio seguente assegna a ciascun giorno tre osservazioni. Il codice stampa prima la media di ciascun gruppo, così puoi verificare la linea disegnata rispetto a numeri semplici:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4],
    "visitors": [10, 12, 14, 14, 16, 18, 13, 15, 17, 19, 21, 23],
})

print(data.groupby("day")["visitors"].mean())

sns.lineplot(data=data, x="day", y="visitors", marker="o")
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Mean visitors by day with 95% confidence band")
plt.tight_layout()
plt.show()
Produzione:
day
1    12.0
2    16.0
3    15.0
4    21.0
Name: visitors, dtype: float64
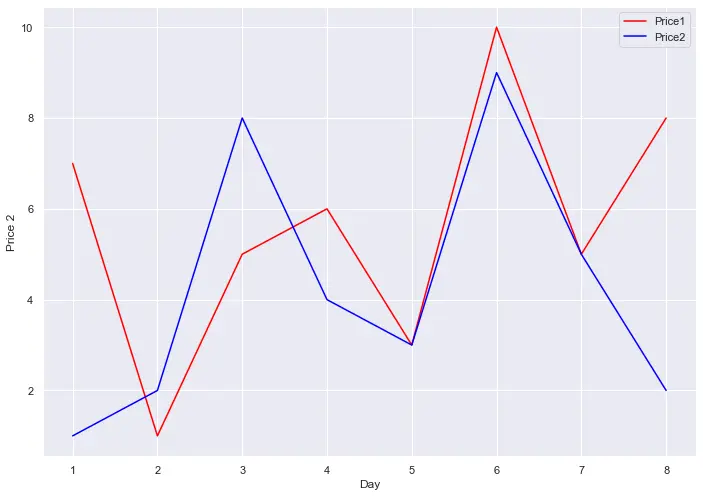
La linea centrale passa per le medie stampate (12, 16, 15 e 21): con osservazioni ripetute, lineplot() aggrega per impostazione predefinita ciascun gruppo di x con la media. La banda ombreggiata è l’intervallo di confidenza al 95% per quella media, calcolato tramite bootstrapping. Dove un gruppo è più disperso, la banda è più larga; non dice nulla su dove cadono le singole osservazioni.
Prima di interpretare una banda, verifica se ciascun valore di x ha osservazioni ripetute e che cosa rappresentano tali osservazioni. Le misurazioni ripetute dello stesso soggetto, ad esempio, non rappresentano necessariamente campioni indipendenti. Con una sola osservazione a ciascun valore di x, non c’è replicazione all’interno della posizione da cui inferire la variazione allo stesso modo. L’interpretazione appropriata dipende anche dalla versione di Seaborn e dalle opzioni di grafico in uso. Gli esempi qui utilizzano il parametro errorbar, disponibile da Seaborn 0.12; in Seaborn 0.13.2 il valore predefinito è errorbar=("ci", 95), e errorbar="sd" disegna invece una banda che copre una deviazione standard su ciascun lato della media. Consulta la documentazione della versione installata quando hai bisogno di controllare lo stimatore o il metodo dell’intervallo. Se la banda non è significativa per i tuoi dati, configura il grafico di conseguenza oppure omettila e spiega come è stata calcolata la linea.
Quando la banda non è significativa, disattivala con errorbar=None. L’aggregazione avviene comunque — la linea collega ancora le medie dei gruppi — ma non viene disegnata alcuna banda:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "day": [1, 1, 1, 2, 2, 2, 3, 3, 3, 4, 4, 4],
    "visitors": [10, 12, 14, 14, 16, 18, 13, 15, 17, 19, 21, 23],
})

sns.lineplot(data=data, x="day", y="visitors", marker="o", errorbar=None)
plt.xlabel("Day")
plt.ylabel("Visitors")
plt.title("Mean visitors by day without uncertainty band")
plt.tight_layout()
plt.show()
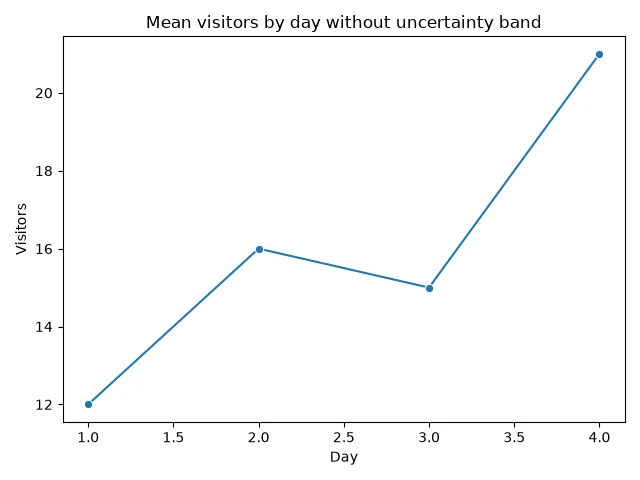
Le due figure disegnano le stesse medie; differisce solo la banda. Scegli tra loro in base al fatto che il riepilogo dell’incertezza aiuti il lettore, non in base a quale figura sembri più pulita.
Disegnare più linee
Per i confronti basati sulle categorie, includi una colonna di categoria e mappala su hue. Seaborn disegna una linea colorata separata per ciascuna categoria e aggiunge una legenda. Mappa style sulla stessa colonna categorica o su un’altra quando i motivi delle linee possono fornire un’ulteriore distinzione visiva. Usa le categorie solo quando le righe condividono le stesse misure x e y; mantieni etichette e unità coerenti tra i gruppi.
Ecco un esempio completo di dati raggruppati con osservazioni fisse:
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt

data = pd.DataFrame({
    "week": [1, 2, 3, 1, 2, 3],
    "orders": [8, 11, 14, 6, 9, 10],
    "store": ["North", "North", "North", "South", "South", "South"],
})

sns.lineplot(data=data, x="week", y="orders", hue="store", style="store", markers=True, dashes=True)
plt.xlabel("Week")
plt.ylabel("Orders")
plt.title("Orders by store")
plt.tight_layout()
plt.show()
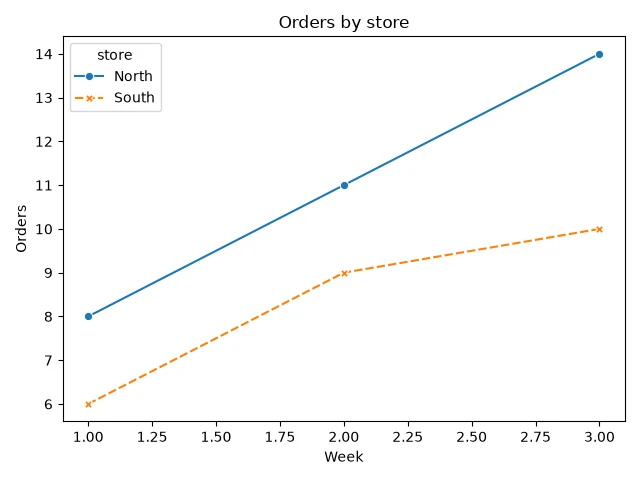
Quando invece i dati hanno colonne numeriche separate per ciascuna serie, rimodellali in una tabella lunga con una colonna di valori e una colonna con il nome della serie, quindi mappa il nome della serie su hue. In alternativa, disegna ciascuna colonna y su assi Matplotlib condivisi e assegna un’etichetta a ciascuna linea prima di aggiungere una legenda. In entrambi gli approcci, la legenda deve identificare ciascuna linea e corrispondere ai suoi dati. Non usare lo stile per categorie per nascondere unità o scale diverse; considera assi separati o figure separate quando il confronto diretto potrebbe fuorviare.
Correggere un nome di colonna scritto male
I nomi passati a x e y devono corrispondere esattamente ai nomi delle colonne in data. Se un nome è scritto male, lineplot() solleva un errore prima di disegnare qualsiasi cosa. Questa chiamata chiede una colonna chiamata visitor, ma il DataFrame ha solo visitors:
import pandas as pd
import seaborn as sns

data = pd.DataFrame({
    "day": [1, 2, 3, 4, 5],
    "visitors": [12, 15, 13, 18, 21],
})

sns.lineplot(data=data, x="day", y="visitor")
Produzione:
ValueError: Could not interpret value `visitor` for `y`. An entry with this name does not appear in `data`.
Il messaggio indica l’argomento (y), il valore non valido (visitor) e il motivo, il che rende questo errore rapido da correggere: confronta il nome con le colonne effettive — stampare data.columns le elenca — e correggi la grafia. Lo stesso errore appare per x o per una colonna hue o style scritta male.
Conclusione
Usa seaborn.lineplot() per collegare le misurazioni di y lungo i valori di x, quindi scegli le impostazioni di aspetto o le mappature di categoria per rendere la figura leggibile. Verifica come vengono riassunte le osservazioni ripetute prima di interpretare una banda di incertezza, ed etichetta chiaramente ciascuna serie confrontata.
Domande frequenti
- Cosa aggiunge Seaborn a Matplotlib? Seaborn fornisce un’interfaccia di livello superiore per la grafica statistica e lavora con Matplotlib per la visualizzazione delle figure e l’ulteriore formattazione.
- Posso passare un DataFrame di pandas? Sì. Imposta
datasul DataFrame e passa i nomi delle colonne axey. - Come cambio l’aspetto della linea? Usa opzioni come
color,markerelinestyle; queste cambiano l’aspetto, mentrehuemappa le categorie su linee separate. - Cosa significa la banda ombreggiata? Rappresenta un riepilogo dell’incertezza associato alla stima disegnata. La sua interpretazione dipende dalle osservazioni ripetute, dallo stimatore e dal metodo di intervallo scelto; non è automaticamente una deviazione standard.
- Come posso confrontare più linee? Mappa una colonna di categoria su
hue, oppure disegna serie etichettate separatamente su assi condivisi. Assicurati che la legenda nomini accuratamente ciascuna linea. - Come rimuovo la banda ombreggiata? Passa
errorbar=None. La linea aggrega comunque le osservazioni ripetute con la media; viene omessa solo la banda di incertezza.