HOWTO · Python
Ableitung der ReLU-Funktion in Python
Die ReLU-Funktion wird am häufigsten beim maschinellen Lernen im Sinne von Deep Learning verwendet. In diesem Artikel wird erläutert, wie Sie die ReLU-Ableitung in Python zusammen mit der Implementierung der ReLU-Funktion implementieren.
Auf dieser Seite
ReLU ist definiert als f(x) = max(0, x). In Python lässt sich die Funktion für einen Skalar mit max und für ein Array mit numpy.maximum implementieren. Die mathematische Ableitung beträgt 0 für x < 0 und 1 für x > 0; bei x = 0 ist sie nicht definiert. Im Code wird dort häufig 0 als Subgradient gewählt. Die folgenden Beispiele verwenden diese Konvention.
Die ReLU-Funktion in Python implementieren
Für einen skalaren Eingabewert bildet die eingebaute Funktion max die Definition direkt ab. Führe dieses Beispiel aus:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
def relu(x):
    return max(0, x)


print(relu(3))
print(relu(0.5))
3
0.5
Die Funktion gibt den Eingabewert zurück, wenn er positiv ist, andernfalls 0. Diese skalare Implementierung verarbeitet jeweils eine Zahl und lässt sich nicht direkt auf ein NumPy-Array anwenden.
Die skalare Ableitung von ReLU implementieren
Bei Eingabewerten ungleich null entspricht die Ableitung der Steigung der stückweise linearen Funktion: Unterhalb von null beträgt sie 0, oberhalb von null 1. Bei null existiert die mathematische Ableitung nicht, da die links- und rechtsseitigen Steigungen unterschiedlich sind. Für die Gradientenberechnung muss ein Programm dort dennoch einen Wert verwenden. Diese Funktion legt daher ausdrücklich den häufig verwendeten Subgradienten 0 fest:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
def relu_derivative(x):
    return 1 if x > 0 else 0


for value in (-2, 0, 3):
    print(value, relu_derivative(value))
-2 0
0 0
3 1
Die Regel gibt nur für strikt positive Eingabewerte 1 zurück; bei null und bei negativen Eingabewerten gibt sie 0 zurück. Am nicht differenzierbaren Punkt handelt es sich um eine Implementierungskonvention und nicht um die Behauptung, die mathematische Ableitung sei dort gleich 0.
ReLU und ihre Ableitung auf NumPy-Arrays anwenden
NumPy wendet diese Operationen elementweise an. np.maximum berechnet ReLU, während np.where für jedes Array-Element den Wert der Ableitung auswählt. Der Ausdruck für die Ableitung verwendet denselben Subgradienten 0 wie die skalare Funktion:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
import numpy as np

values = np.array([-2.0, 0.0, 3.0])
outputs = np.maximum(values, 0)
gradients = np.where(values > 0, 1, 0)

print(outputs)
print(gradients)
[0. 0. 3.]
[0 0 1]
Bei Array-Eingaben sind beide ausgegebenen Arrays elementweise auf values abgestimmt; Einträge an der Stelle null erhalten gemäß der gewählten Konvention den Ableitungswert 0. Verwende np.maximum und np.where für Array-Eingaben und die skalaren Funktionen oben, wenn jeder Aufruf nur eine Zahl verarbeitet.
Lambda-Ausdrücke für skalare Eingaben verwenden
Ein Lambda-Ausdruck ist eine knappe Möglichkeit, eine kurze skalare Funktion direkt einzusetzen. Diese Ausdrücke verwenden dieselben Definitionen und dieselbe Konvention für null wie die benannten Funktionen:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
relu = lambda x: max(0, x)
relu_derivative = lambda x: 1 if x > 0 else 0

print(relu(3), relu_derivative(3))
3 1
Diese Lambdas akzeptieren skalare Eingabewerte; sie ersetzen nicht die elementweisen Operationen von NumPy auf Arrays. Für wiederverwendbare Logik oder ausführlichere Erläuterungen sind benannte def-Funktionen in der Regel leichter zu lesen und zu erweitern.
ReLU und ihre Ableitung darstellen und überprüfen
In einem Diagramm werden der flache Bereich und der Wechsel der Steigung sichtbar. Das bereitgestellte Diagramm verwendet bei null für die Ableitungskurve den Wert 0 und entspricht damit der Implementierungskonvention; die mathematische Ableitung bleibt an dieser Stelle undefiniert. Die folgende eigenständige Überprüfung kontrolliert repräsentative Werte, ohne eine Plot-Bibliothek zu benötigen:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
points = (-2, 0, 2)
for x in points:
    relu = max(0, x)
    derivative = 1 if x > 0 else 0
    print(x, relu, derivative)
-2 0 0
0 0 0
2 2 1
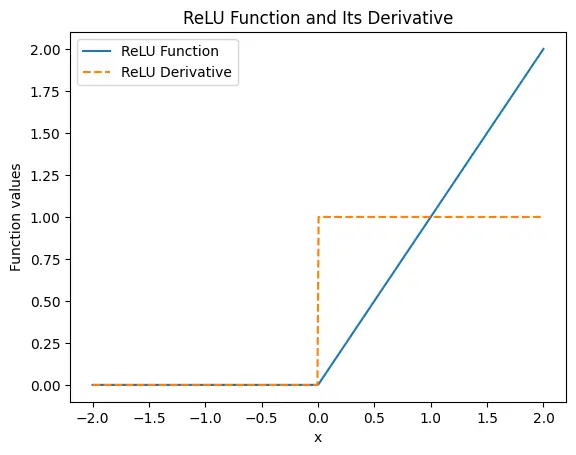
Die ReLU-Kurve bleibt für negative Eingabewerte bei null und steigt für positive Eingabewerte mit der Steigung 1 an. Ihre mathematische Ableitung ist bei x = 0 nicht definiert; die obige Implementierung wählt dort den Subgradienten 0. Die gestrichelte senkrechte Verbindungslinie markiert den Sprung von 0 auf 1 und stellt keine Zwischenwerte der Ableitung dar. In neuronalen Netzen können wiederholt auftretende Nullgradienten dazu führen, dass sich manche Einheiten bei negativen Eingabewerten nicht aktualisieren. Leaky ReLU ist eine mögliche Alternative: Sie verwendet auf dieser Seite eine kleine, von null verschiedene Steigung.