HOWTO · Python
Derivada de la función ReLU en Python
La función ReLU se usa con mayor frecuencia en el aprendizaje automático en términos de aprendizaje profundo. Este artículo analiza cómo implementar la derivación ReLU en Python junto con la implementación de la función ReLU.
En esta página
ReLU se define como f(x) = max(0, x). En Python, puedes implementarla con max para un escalar o con numpy.maximum para un array. Su derivada matemática es 0 cuando x < 0 y 1 cuando x > 0; en x = 0, la derivada no está definida. En el código suele elegirse 0 como subgradiente, y los ejemplos siguientes usan esa convención.
Implementar la función ReLU en Python
Para una entrada escalar, la función integrada max expresa directamente la definición. Ejecuta este ejemplo:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
def relu(x):
    return max(0, x)


print(relu(3))
print(relu(0.5))
3
0.5
La función devuelve la entrada si es positiva y, en caso contrario, devuelve 0. Esta implementación escalar espera un número cada vez y no se aplica directamente a un array de NumPy.
Implementar la derivada escalar de ReLU
Para entradas distintas de cero, la derivada sigue la pendiente de la función lineal por tramos: es 0 por debajo de cero y 1 por encima. La derivada matemática no existe en cero porque las pendientes por la izquierda y por la derecha son distintas. Al calcular gradientes, el programa necesita asignar un valor en ese punto; por eso, esta función elige explícitamente el valor común de subgradiente 0:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
def relu_derivative(x):
    return 1 if x > 0 else 0


for value in (-2, 0, 3):
    print(value, relu_derivative(value))
-2 0
0 0
3 1
La regla devuelve 1 solo para entradas estrictamente positivas y devuelve 0 para las entradas iguales o inferiores a cero. En el punto no diferenciable, esto es una convención de implementación; no significa que la derivada matemática sea 0 allí.
Aplicar ReLU y su derivada a arrays de NumPy
NumPy aplica estas operaciones elemento por elemento. np.maximum calcula ReLU, mientras que np.where selecciona el valor de la derivada para cada elemento del array. La expresión de la derivada usa el mismo subgradiente 0 en cero que la función escalar:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
import numpy as np

values = np.array([-2.0, 0.0, 3.0])
outputs = np.maximum(values, 0)
gradients = np.where(values > 0, 1, 0)

print(outputs)
print(gradients)
[0. 0. 3.]
[0 0 1]
Con entradas de tipo array, ambos arrays impresos se corresponden elemento por elemento con values; según la convención elegida, los elementos iguales a cero reciben el valor de derivada 0. Si las entradas son arrays, usa np.maximum y np.where; si cada llamada procesa un solo número, usa las funciones escalares anteriores.
Usar expresiones lambda con entradas escalares
Una expresión lambda es una opción concisa cuando resulta útil definir una función escalar breve en línea. Estas expresiones usan las mismas definiciones y la misma convención en cero que las funciones con nombre:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
relu = lambda x: max(0, x)
relu_derivative = lambda x: 1 if x > 0 else 0

print(relu(3), relu_derivative(3))
3 1
Estas expresiones lambda aceptan entradas escalares; no sustituyen las operaciones elemento por elemento de NumPy para arrays. Para reutilizar la lógica o explicarla mejor, las funciones con nombre definidas con def suelen ser más fáciles de leer y ampliar.
Graficar y verificar ReLU y su derivada
Un gráfico permite ver la región plana y el cambio de pendiente. El gráfico proporcionado asigna el valor 0 a la curva de la derivada en cero, de acuerdo con la convención de implementación; la derivada matemática sigue sin estar definida en ese punto. La siguiente comprobación autónoma verifica valores representativos sin necesitar una biblioteca de gráficos:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
points = (-2, 0, 2)
for x in points:
    relu = max(0, x)
    derivative = 1 if x > 0 else 0
    print(x, relu, derivative)
-2 0 0
0 0 0
2 2 1
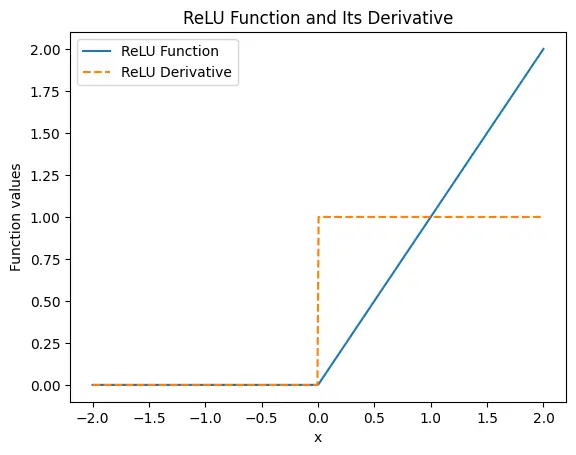
La curva de ReLU permanece en cero para las entradas negativas y aumenta con pendiente 1 para las positivas. Su derivada matemática no está definida en x = 0; la implementación anterior elige allí el subgradiente 0. El conector vertical discontinuo marca el salto de 0 a 1 y no representa valores intermedios de la derivada. En las redes neuronales, los gradientes que permanecen en cero pueden impedir que algunas unidades se actualicen con entradas negativas. Leaky ReLU es una alternativa: usa una pendiente pequeña y distinta de cero en ese lado.