HOWTO · SciPy
SciPy Berechnen Sie die Wahrscheinlichkeit der Normalverteilung
In diesem Beitrag lernen Sie die SciPy-Normalverteilung kennen.
Auf dieser Seite
Das Objekt scipy.stats.norm aus SciPy modelliert die Normalverteilung (Gauß-Verteilung), sodass Sie Dichten, kumulative Wahrscheinlichkeiten und Perzentile mit wenigen Aufrufen berechnen können, statt die Formeln von Hand durchzuarbeiten. Diese Anleitung zeigt, wie Sie Mittelwert und Standardabweichung der Verteilung festlegen und je nach der zu beantwortenden Frage zwischen norm.pdf(), norm.cdf() und norm.ppf() wählen.
Die Normalverteilung und ihre Parameter verstehen
Eine Normalverteilung ist durch zwei Zahlen vollständig beschrieben: den Mittelwert μ, der die Glockenkurve zentriert, und die Standardabweichung σ, die ihre Breite bestimmt. In SciPy erscheinen sie als die Argumente loc und scale – loc ist der Mittelwert und scale die Standardabweichung, nicht die Varianz. Die Standardnormalverteilung ist der Sonderfall loc=0, scale=1.
Da die Normalverteilung stetig ist, beantworten die folgenden Funktionen unterschiedliche Arten von Fragen. norm.pdf() liefert die Höhe der Dichtekurve an einem Punkt: nützlich, um relative Wahrscheinlichkeiten zu vergleichen, aber es ist eine Dichte, nicht die Wahrscheinlichkeit genau dieses Werts (bei einer stetigen Variablen beträgt die Wahrscheinlichkeit, einen einzelnen exakten Wert zu treffen, 0). Tatsächliche Wahrscheinlichkeiten erstrecken sich über Intervalle, und norm.cdf() liefert Ihnen diese Flächen.
Wahrscheinlichkeitsdichte mit norm.pdf() berechnen
Übergeben Sie einen Wert – oder ein Array von Werten – zusammen mit loc und scale an norm.pdf(), um die Dichte an diesen Stellen zu erhalten:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
from scipy.stats import norm

density_at_mean = norm.pdf(0, loc=0, scale=1)
density_at_1_5 = norm.pdf(1.5, loc=0, scale=1)

print(f"PDF at the mean: {density_at_mean:.4f}")
print(f"PDF at x = 1.5: {density_at_1_5:.4f}")
PDF at the mean: 0.3989
PDF at x = 1.5: 0.1295
Die Dichte erreicht ihr Maximum am Mittelwert und fällt symmetrisch ab, sodass Werte nahe 0 pro Einheit von x deutlich wahrscheinlicher sind als Werte nahe 1.5. Bedenken Sie, dass 0.3989 eine Dichte ist – bei kleinem scale können Dichten sogar über 1 steigen, was für eine Wahrscheinlichkeit unmöglich wäre.
Derselbe Aufruf akzeptiert auch ein ganzes Punktraster – so erhalten Sie die Daten der Kurve. Werten Sie die Dichte an jedem x von -5 bis 5 aus, und Sie können die Paare mit einer Plot-Bibliothek wie Matplotlib darstellen (plt.plot(xs, densities)). Das folgende Skript berechnet das Raster und bestimmt das Maximum der Kurve:
from scipy.stats import norm

xs = [i / 20 for i in range(-100, 101)]
densities = norm.pdf(xs, loc=0, scale=1)
peak_index = int(densities.argmax())

print(f"Computed {len(xs)} density values from {xs[0]:.1f} to {xs[-1]:.1f}")
print(f"Peak density {densities[peak_index]:.4f} at x = {xs[peak_index]:.1f}")
Computed 201 density values from -5.0 to 5.0
Peak density 0.3989 at x = 0.0
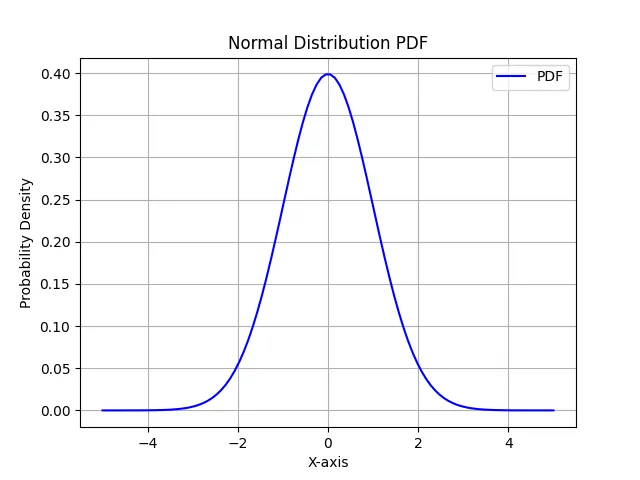
Die Kurve erreicht ihr Maximum beim Mittelwert 0 und wird schmaler oder breiter, je nachdem, ob scale kleiner oder größer wird – das visuelle Kennzeichen der Standardabweichung.
Kumulative Wahrscheinlichkeiten mit norm.cdf() berechnen
Um aus einer Dichte eine tatsächliche Wahrscheinlichkeit zu machen, fragen Sie die Fläche unter der Kurve ab. norm.cdf() liefert die Wahrscheinlichkeit, dass ein aus der Verteilung gezogener Wert kleiner oder gleich einem Schwellenwert ist – die akkumulierte Fläche links von diesem Punkt.
Führen Sie dieses Beispiel aus:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
from scipy.stats import norm

mean = 0
std_dev = 1
value = 1.5
cdf_value = norm.cdf(value, mean, std_dev)

print(f"The CDF at x = {value} is {cdf_value:.4f}")
The CDF at x = 1.5 is 0.9332
Etwa 93.32 % der Ziehungen aus einer Standardnormalverteilung liegen bei oder unter 1.5. Da die CDF die Fläche von ganz links akkumuliert, ist die Wahrscheinlichkeit, innerhalb eines Intervalls zu landen, die Differenz zweier CDF-Werte:
from scipy.stats import norm

p_between = norm.cdf(1, loc=0, scale=1) - norm.cdf(-1, loc=0, scale=1)

print(f"P(-1 < X < 1) = {p_between:.4f}")
P(-1 < X < 1) = 0.6827
Diese 0.6827 ist die bekannte Faustregel, dass etwa 68 % einer Normalverteilung innerhalb einer Standardabweichung um den Mittelwert liegen.
Perzentile und z-Scores mit norm.ppf() bestimmen
norm.ppf() kehrt die CDF um: Übergeben Sie eine Wahrscheinlichkeit als Bruch zwischen 0 und 1, und die Funktion liefert den Grenzwert an diesem Perzentil. Bei der Standardnormalverteilung ist dieser Grenzwert genau der z-Score – die Anzahl der Standardabweichungen oberhalb des Mittelwerts:
Der Code und die angezeigten Bezeichnungen oder Ausgaben in diesem Abschnitt bleiben auf Englisch.
from scipy.stats import norm

percentile = 0.95
z_score = norm.ppf(percentile, loc=0, scale=1)

print(f"The z-score at the 95th percentile is {z_score:.4f}")
The z-score at the 95th percentile is 1.6449
Damit liegen 95 % einer Standardnormalverteilung unterhalb von z = 1.6449. Bei einer Verteilung mit eigenem Mittelwert und eigener Standardabweichung wendet norm.ppf() die Transformation x = loc + z·scale für Sie an und liefert den Grenzwert in den Einheiten der Verteilung:
from scipy.stats import norm

cutoff = norm.ppf(0.90, loc=100, scale=15)

print(f"The 90th percentile is {cutoff:.4f}")
The 90th percentile is 119.2233
Wenn beispielsweise Testergebnisse einer Normalverteilung mit einem Mittelwert von 100 und einer Standardabweichung von 15 folgen, liegen etwa 90 % der Ergebnisse bei oder unter 119.22.
Ergebnisse interpretieren und häufige Fallstricke
scaleist die Standardabweichung, nicht die Varianz. Wer σ² statt σ übergibt, verbreitert die Verteilung unbemerkt und verfälscht jedes Ergebnis.scalemuss außerdem positiv sein; ein Wert von null oder weniger liefertnan-Ergebnisse.- Dichte ist keine Wahrscheinlichkeit.
norm.pdf()kann bei kleinemscaleWerte über 1 liefern und gibt nie die Wahrscheinlichkeit eines exakten Punktes zurück. Verwenden Sienorm.cdf()-Differenzen für Wahrscheinlichkeiten über Intervalle. norm.ppf()erwartet einen Bruch, keinen Prozentwert. Übergeben Sie0.95für das 95. Perzentil, nicht95; Eingaben außerhalb von 0–1 liefern unendliche oder undefinierte Quantile.- Intervallgrenzen spielen keine Rolle. Da die Verteilung stetig ist, ist P(X ≤ t) gleich P(X < t), sodass inklusive und strikte Grenzen dieselbe Intervallwahrscheinlichkeit ergeben.
- Weit entfernte Ränder erfordern die Survival-Funktion. Bei extremen Schwellenwerten verliert
1 - norm.cdf(x)an Gleitkommagenauigkeit;norm.sf(x)berechnet die Wahrscheinlichkeit des rechten Rands direkt und bleibt genau.
Mit diesen Konventionen deckt scipy.stats.norm die alltäglichen Fragen ab – wie wahrscheinlich ein Bereich ist, wo ein Perzentil liegt und wie die Parameter einer Verteilung dieselbe Glockenkurve umformen.