HOWTO · SciPy
SciPy Calcular la probabilidad de distribución normal
Esta publicación le enseñará sobre la distribución normal de SciPy.
En esta página
El objeto scipy.stats.norm de SciPy modela la distribución normal (gaussiana), de modo que puedes calcular densidades, probabilidades acumuladas y percentiles con unas pocas llamadas en lugar de resolver las fórmulas a mano. Esta guía muestra cómo establecer la media y la desviación estándar de la distribución y cómo elegir entre norm.pdf(), norm.cdf() y norm.ppf() según la pregunta que intentes responder.
Comprender la distribución normal y sus parámetros
Una distribución normal queda completamente descrita por dos números: la media μ, que centra la curva de campana, y la desviación estándar σ, que controla su anchura. En SciPy aparecen como los argumentos loc y scale: loc es la media y scale es la desviación estándar, no la varianza. La distribución normal estándar es el caso especial loc=0, scale=1.
Como la distribución normal es continua, las funciones siguientes responden a tipos de preguntas distintos. norm.pdf() devuelve la altura de la curva de densidad en un punto: es útil para comparar la verosimilitud relativa, pero es una densidad, no la probabilidad de ese valor exacto (para una variable continua, la probabilidad de obtener cualquier valor exacto concreto es 0). Las probabilidades reales se definen sobre intervalos, y norm.cdf() es la función que te da esas áreas.
Calcular la densidad de probabilidad con norm.pdf()
Pasa un valor, o una matriz de valores, a norm.pdf() junto con loc y scale para obtener la densidad en esos puntos:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from scipy.stats import norm

density_at_mean = norm.pdf(0, loc=0, scale=1)
density_at_1_5 = norm.pdf(1.5, loc=0, scale=1)

print(f"PDF at the mean: {density_at_mean:.4f}")
print(f"PDF at x = 1.5: {density_at_1_5:.4f}")
PDF at the mean: 0.3989
PDF at x = 1.5: 0.1295
La densidad alcanza su máximo en la media y decrece simétricamente, así que los valores cercanos a 0 son mucho más probables por unidad de x que los cercanos a 1.5. Recuerda que 0.3989 es una densidad: con un scale pequeño, las densidades pueden incluso superar 1, algo imposible para una probabilidad.
La misma llamada acepta una cuadrícula completa de puntos, que es como se obtienen los datos de la curva. Evalúa la densidad en cada x de -5 a 5 y podrás representar los pares con una biblioteca de graficación como Matplotlib (plt.plot(xs, densities)). El siguiente script calcula la cuadrícula y localiza el pico de la curva:
from scipy.stats import norm

xs = [i / 20 for i in range(-100, 101)]
densities = norm.pdf(xs, loc=0, scale=1)
peak_index = int(densities.argmax())

print(f"Computed {len(xs)} density values from {xs[0]:.1f} to {xs[-1]:.1f}")
print(f"Peak density {densities[peak_index]:.4f} at x = {xs[peak_index]:.1f}")
Computed 201 density values from -5.0 to 5.0
Peak density 0.3989 at x = 0.0
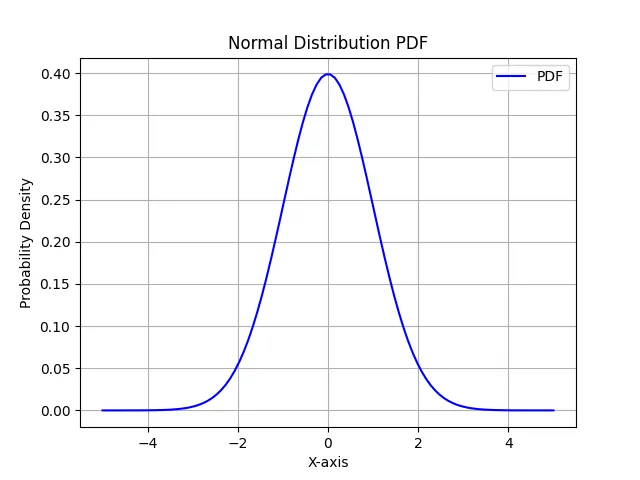
La curva alcanza su máximo en la media 0 y se estrecha o se ensancha a medida que scale disminuye o aumenta, que es la firma visual de la desviación estándar (los rótulos de los ejes de la figura permanecen en inglés).
Calcular probabilidades acumuladas con norm.cdf()
Para convertir la densidad en una probabilidad real, pide el área bajo la curva. norm.cdf() devuelve la probabilidad de que un valor extraído de la distribución sea menor o igual que un umbral: el área acumulada a la izquierda de ese punto.
Ejecuta este ejemplo:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from scipy.stats import norm

mean = 0
std_dev = 1
value = 1.5
cdf_value = norm.cdf(value, mean, std_dev)

print(f"The CDF at x = {value} is {cdf_value:.4f}")
The CDF at x = 1.5 is 0.9332
Aproximadamente el 93.32 % de los valores extraídos de una normal estándar quedan en 1.5 o por debajo. Como la CDF acumula área desde el extremo izquierdo, la probabilidad de caer dentro de un intervalo es la diferencia entre dos valores de la CDF:
from scipy.stats import norm

p_between = norm.cdf(1, loc=0, scale=1) - norm.cdf(-1, loc=0, scale=1)

print(f"P(-1 < X < 1) = {p_between:.4f}")
P(-1 < X < 1) = 0.6827
Ese 0.6827 es la conocida regla práctica de que alrededor del 68 % de una distribución normal se encuentra dentro de una desviación estándar de la media.
Encontrar percentiles y puntuaciones z con norm.ppf()
norm.ppf() invierte la CDF: dale una probabilidad como fracción entre 0 y 1 y devuelve el valor de corte en ese percentil. En la normal estándar, ese corte es exactamente la puntuación z: el número de desviaciones estándar por encima de la media:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from scipy.stats import norm

percentile = 0.95
z_score = norm.ppf(percentile, loc=0, scale=1)

print(f"The z-score at the 95th percentile is {z_score:.4f}")
The z-score at the 95th percentile is 1.6449
Así, el 95 % de una normal estándar queda por debajo de z = 1.6449. Para una distribución con su propia media y desviación estándar, norm.ppf() aplica por ti la transformación x = loc + z·scale y devuelve el corte en las unidades de la distribución:
from scipy.stats import norm

cutoff = norm.ppf(0.90, loc=100, scale=15)

print(f"The 90th percentile is {cutoff:.4f}")
The 90th percentile is 119.2233
Por ejemplo, si las puntuaciones de un examen siguen una distribución normal con media 100 y desviación estándar 15, alrededor del 90 % de las puntuaciones son 119.22 o inferiores.
Interpretar los resultados y errores comunes
scalees la desviación estándar, no la varianza. Pasar σ² en lugar de σ ensancha silenciosamente la distribución y corrompe todos los resultados.scaletambién debe ser positivo; un valor cero o negativo produce resultadosnan.- La densidad no es una probabilidad.
norm.pdf()puede devolver valores superiores a 1 cuandoscalees pequeño, y nunca da la probabilidad de un punto exacto. Usa diferencias denorm.cdf()para probabilidades sobre intervalos. norm.ppf()espera una fracción, no un porcentaje. Pasa0.95para el percentil 95, no95; las entradas fuera de 0–1 devuelven cuantiles infinitos o indefinidos.- Los extremos no importan para los intervalos. Como la distribución es continua, P(X ≤ t) es igual a P(X < t), así que los límites inclusivos o estrictos dan la misma probabilidad de intervalo.
- Las colas lejanas necesitan la función de supervivencia. Para umbrales extremos,
1 - norm.cdf(x)pierde precisión de punto flotante;norm.sf(x)calcula la probabilidad de la cola derecha directamente y se mantiene preciso.
Con estas convenciones claras, scipy.stats.norm cubre las preguntas habituales: qué tan probable es una región, dónde cae un percentil y cómo los parámetros de una distribución remodelan la misma curva de campana.