HOWTO · SciPy
SciPy 정규 분포 확률 계산
이 게시물에서는 SciPy 정규 분포에 대해 설명합니다.
이 페이지의 내용
SciPy의 scipy.stats.norm 객체는 정규(가우스) 분포를 모델링하므로 수식을 직접 풀지 않고도 몇 번의 호출로 밀도, 누적 확률, 백분위수를 계산할 수 있습니다. 이 가이드는 분포의 평균과 표준편차를 설정하는 방법과 답하려는 질문에 따라 norm.pdf(), norm.cdf(), norm.ppf() 중 적절한 함수를 선택하는 방법을 보여줍니다.
정규 분포와 그 매개변수 이해하기
정규 분포는 두 숫자로 완전히 설명됩니다. 종 모양 곡선의 중심을 정하는 평균 μ와 너비를 조절하는 표준편차 σ입니다. SciPy에서는 이 값이 각각 loc와 scale 인수로 나타납니다. loc는 평균이고 scale은 분산이 아니라 표준편차입니다. 표준 정규 분포는 loc=0, scale=1인 특별한 경우입니다.
정규 분포는 연속형이므로 아래 함수들은 서로 다른 종류의 질문에 답합니다. norm.pdf()는 특정 지점에서 밀도 곡선의 높이를 반환합니다. 상대적인 가능도를 비교하는 데 유용하지만, 이는 정확한 값의 확률이 아니라 밀도입니다. 연속 변수에서는 어떤 정확한 값이 나타날 확률이 0입니다. 실제 확률은 구간에 걸쳐 정의되며, 그 넓이를 제공하는 것이 norm.cdf()입니다.
norm.pdf()로 확률 밀도 계산하기
loc와 scale과 함께 값 또는 값의 배열을 norm.pdf()에 전달하면 해당 지점에서의 밀도를 얻을 수 있습니다:
이 섹션의 코드와 표시되는 레이블 또는 출력은 영어로 유지됩니다.
from scipy.stats import norm

density_at_mean = norm.pdf(0, loc=0, scale=1)
density_at_1_5 = norm.pdf(1.5, loc=0, scale=1)

print(f"PDF at the mean: {density_at_mean:.4f}")
print(f"PDF at x = 1.5: {density_at_1_5:.4f}")
PDF at the mean: 0.3989
PDF at x = 1.5: 0.1295
밀도는 평균에서 최대가 되고 대칭적으로 감소하므로, 0 근처의 값은 1.5 근처의 값보다 x 단위당 나타날 가능성이 훨씬 큽니다. 0.3989는 밀도라는 점을 기억하세요. scale이 작으면 밀도는 1보다 커질 수도 있지만, 이는 확률에서는 불가능합니다.
같은 호출로 점들의 전체 그리드를 처리할 수 있으며, 이것이 곡선의 데이터를 얻는 방법입니다. -5부터 5까지 각 x에서 밀도를 계산하면 Matplotlib 같은 플로팅 라이브러리(plt.plot(xs, densities))로 쌍을 차트로 그릴 수 있습니다. 아래 스크립트는 그리드를 계산하고 곡선의 정점을 찾습니다:
from scipy.stats import norm

xs = [i / 20 for i in range(-100, 101)]
densities = norm.pdf(xs, loc=0, scale=1)
peak_index = int(densities.argmax())

print(f"Computed {len(xs)} density values from {xs[0]:.1f} to {xs[-1]:.1f}")
print(f"Peak density {densities[peak_index]:.4f} at x = {xs[peak_index]:.1f}")
Computed 201 density values from -5.0 to 5.0
Peak density 0.3989 at x = 0.0
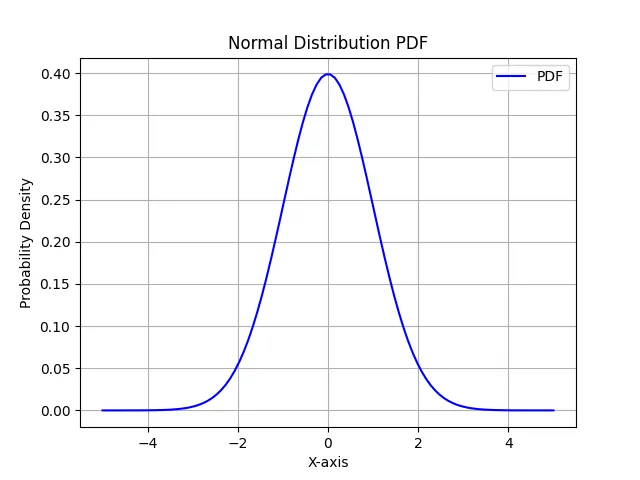
곡선은 평균 0에서 정점을 이루며 scale이 작아지면 좁아지고 커지면 넓어집니다. 이는 표준편차를 시각적으로 보여주는 특징입니다.
norm.cdf()로 누적 확률 계산하기
밀도를 실제 확률로 바꾸려면 곡선 아래의 넓이를 구해야 합니다. norm.cdf()는 분포에서 추출한 값이 임계값보다 작거나 같을 확률, 즉 해당 지점 왼쪽에 누적된 넓이를 반환합니다.
다음 예제를 실행해 보세요:
이 섹션의 코드와 표시되는 레이블 또는 출력은 영어로 유지됩니다.
from scipy.stats import norm

mean = 0
std_dev = 1
value = 1.5
cdf_value = norm.cdf(value, mean, std_dev)

print(f"The CDF at x = {value} is {cdf_value:.4f}")
The CDF at x = 1.5 is 0.9332
표준 정규 분포에서 추출한 값의 약 93.32%는 1.5 이하입니다. CDF는 맨 왼쪽부터 넓이를 누적하므로, 어떤 구간 안에 들어갈 확률은 두 CDF 값의 차이입니다:
from scipy.stats import norm

p_between = norm.cdf(1, loc=0, scale=1) - norm.cdf(-1, loc=0, scale=1)

print(f"P(-1 < X < 1) = {p_between:.4f}")
P(-1 < X < 1) = 0.6827
0.6827은 정규 분포의 약 68%가 평균으로부터 표준편차 1배 이내에 있다는 익숙한 경험 법칙입니다.
norm.ppf()로 백분위수와 z-점수 찾기
norm.ppf()는 CDF를 역변환합니다. 0과 1 사이의 분수로 표현된 확률을 전달하면 해당 백분위수에서의 기준값을 반환합니다. 표준 정규 분포에서 이 기준값은 바로 z-점수, 즉 평균 위로 몇 표준편차만큼 떨어져 있는지를 나타내는 값입니다:
이 섹션의 코드와 표시되는 레이블 또는 출력은 영어로 유지됩니다.
from scipy.stats import norm

percentile = 0.95
z_score = norm.ppf(percentile, loc=0, scale=1)

print(f"The z-score at the 95th percentile is {z_score:.4f}")
The z-score at the 95th percentile is 1.6449
따라서 표준 정규 분포의 95%는 z = 1.6449보다 작습니다. 고유한 평균과 표준편차를 가진 분포에서는 norm.ppf()가 x = loc + z·scale 변환을 대신 적용하여 분포의 단위로 기준값을 반환합니다:
from scipy.stats import norm

cutoff = norm.ppf(0.90, loc=100, scale=15)

print(f"The 90th percentile is {cutoff:.4f}")
The 90th percentile is 119.2233
예를 들어 시험 점수가 평균 100, 표준편차 15인 정규 분포를 따른다면 점수의 약 90%는 119.22 이하입니다.
결과 해석과 흔한 함정
scale은 분산이 아니라 표준편차입니다. σ 대신 σ²를 전달하면 분포가 눈에 띄지 않게 넓어져 모든 결과가 왜곡됩니다.scale은 양수여야 하며 0이나 음수를 전달하면nan결과가 나옵니다.- 밀도는 확률이 아닙니다.
norm.pdf()는scale이 작을 때 1보다 큰 값을 반환할 수 있으며, 정확한 한 지점의 확률은 절대 제공하지 않습니다. 구간에 대한 확률은norm.cdf()값들의 차이를 사용하세요. norm.ppf()는 퍼센트가 아니라 분수를 기대합니다. 95번째 백분위수에는95가 아니라0.95를 전달하세요. 0–1 범위 밖의 입력은 무한대이거나 정의되지 않은 분위수를 반환합니다.- 구간에서는 끝점이 중요하지 않습니다. 분포가 연속형이므로 P(X ≤ t)와 P(X < t)는 같으며, 포함 경계와 열린 경계 모두 같은 구간 확률을 제공합니다.
- 꼬리 끝부분에서는 생존 함수가 필요합니다. 극단적인 임계값에서는
1 - norm.cdf(x)가 부동소수점 정밀도를 잃지만,norm.sf(x)는 오른쪽 꼬리 확률을 직접 계산해 정확성을 유지합니다.
이러한 규칙을 적용하면 scipy.stats.norm로 일상적인 질문, 즉 어떤 구간이 얼마나 가능성이 높은지, 백분위수가 어디에 위치하는지, 한 분포의 매개변수가 같은 종 모양 곡선을 어떻게 바꾸는지를 모두 다룰 수 있습니다.