
HOWTO · Seaborn
Seaborn 箱线图
本教程演示了如何在 python 中使用 seaborn 模块创建箱线图
本页内容
使用 seaborn.boxplot() 汇总数值分布,也可以比较不同类别中的数值。明确映射数据列,让 Seaborn 知道每个变量对应哪个坐标轴。箱线图展示中位数和四分位距(IQR);使用默认须线规则时,须线延伸至距离箱体不超过 1.5 个 IQR 的最远观测值,超出范围的观测值则显示为单独的数据点。
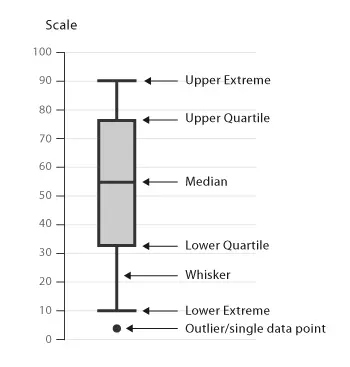
本文的所有示例都使用相同的组成部分:箱体覆盖数据的中间一半,内部的线是中位数,须线按所选规则标记范围,须线之外的点会单独绘制。
为单个分布创建箱线图
将测量值放在 DataFrame 的一列中,并把该列映射到 y。这样可以明确数据的用途,也能为图表提供合适的轴标签。下面的示例使用固定数值,因此每次运行时输入都相同。
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Score")
ax.set_title("Score distribution")
plt.show()
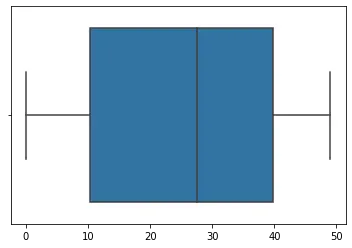
箱体内部的线表示中位数。箱体从第一四分位数延伸到第三四分位数,因此其高度代表中间一半的观测值。箱体越高,数据中间部分的离散程度越大。须线表示所选须线规则下的范围,不一定延伸到最小值和最大值。
比较不同类别的分布
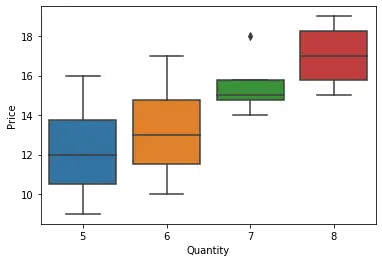
将类别映射到 x,将数值测量映射到 y,即可为每个类别绘制一个箱体。在这个数据集中,每个箱体汇总一个 Quantity 水平对应的 Price。添加 hue="Product" 后,每个类别会按产品分组,从而便于比较同一数量水平下的不同产品。
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
        "Product": ["A", "A", "A", "A", "B", "B", "B", "B"] * 2,
    }
)
ax = sns.boxplot(data=data, x="Quantity", y="Price", hue="Product")
ax.set_title("Price by quantity and product")
plt.show()
当额外分组能回答某个比较问题时,可以使用 hue。如果分组过多,箱体可能会显得拥挤;此时可以简化类别,或改用多个独立图表,让各个分布仍然清晰可读。
使用 Strip Plot 显示单个观测值
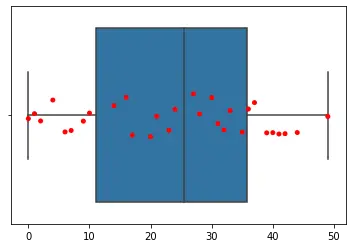
箱线图将数据压缩为汇总统计量。如果读者还需要看到每个观测值,可以叠加 seaborn.stripplot()。两层图形应使用相同的坐标轴和数据映射,并添加少量水平抖动,避免数值相近的点完全重叠。
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Score", color="lightgray")
sns.stripplot(data=data, y="Score", color="darkred", jitter=0.15, ax=ax)
ax.set_title("Scores with individual observations")
plt.show()
箱体仍表示汇总结果,每个标记则对应数据中的一行。对于较大的数据集,数据点可能互相重叠;可以调整标记大小或透明度,让点密集的区域也易于辨认。
自定义箱线图
使用 Matplotlib 的坐标轴范围方法聚焦于相关数值区间,使用 linewidth 调整箱体和须线边框的粗细,并使用 palette 为类别指定颜色。orient 参数控制图表方向;例如,当数据映射兼容时,设置 orient="h" 可请求绘制水平箱线图。坐标轴范围只会改变显示视图,因此应谨慎设置并保持刻度清晰,避免隐藏相关观测值。
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
        "Product": ["A", "A", "A", "A", "B", "B", "B", "B"] * 2,
    }
)
ax = sns.boxplot(
    data=data,
    x="Quantity",
    y="Price",
    hue="Product",
    linewidth=2.5,
    palette="Set2",
)
ax.set_ylim(8, 20)
ax.set_title("Customized price comparison")
plt.show()
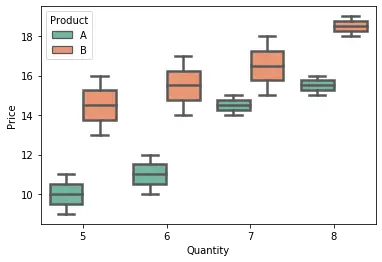
调色板中的颜色对应各个 hue 分组。要绘制水平箱体,请交换类别和测量值的映射,并设置 orient="h";此时应使用 set_xlim() 而非 set_ylim() 设置坐标轴范围。
使用 catplot() 创建箱线图
使用 catplot() 并设置 kind="box",即可使用面向整张图形的接口。它接受相同的显式数据映射;如果需要按另一个变量拆分比较,还可以通过 col 或 row 创建多个面板。对于单张图,seaborn.boxplot() 是面向坐标轴的选项;需要分面时,catplot() 会更方便。
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
    }
)
grid = sns.catplot(data=data, x="Quantity", y="Price", kind="box")
grid.set_axis_labels("Quantity", "Price")
grid.fig.suptitle("Price by quantity")
plt.show()
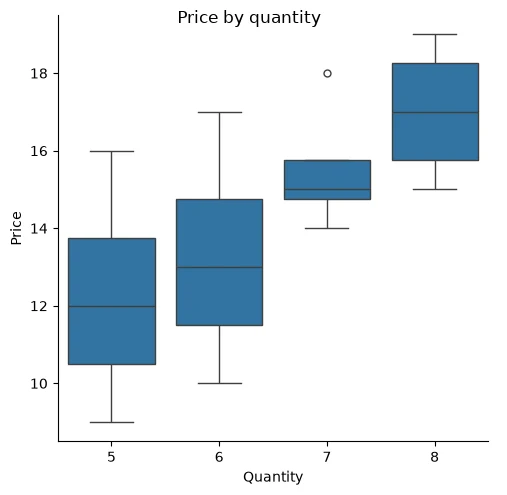
由于 catplot() 构建的是整个图形,它返回的是网格对象而不是单个坐标轴;应像示例中那样在网格上设置标签和标题,而不是调用 ax.set_title()。
处理列缺失错误并设置须线范围
由于每个映射都按名称指定 DataFrame 的列,拼写错误的名称会在绘制任何内容之前失败。以下调用请求了数据中不存在的列 Scroe:
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Scroe")
该调用以以下错误结束:
ValueError: Could not interpret value `Scroe` for `y`. An entry with this name does not appear in `data`.
将名称修正为与列完全一致(此处为 y="Score"),同一调用即可绘制图形。当不确定正确拼写时,打印 data.columns 并从中复制名称;此检查对 x、y 和 hue 同样适用。
须线是读者会遇到的另一个边界。向分数中添加一个远离的值 60:四分位数几乎不变(第一四分位数 15,中位数 18,第三四分位数 21),在默认 whis=1.5 下,上须线停在 24,而 60 被绘制为其外侧的一个孤点。将 whis 作为百分位数对传入,则须线会改为延伸到数据的这些百分位数:
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

scores = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24, 60]})
ax = sns.boxplot(data=scores, y="Score", whis=(0, 100))
plt.show()
使用 whis=(0, 100) 时,须线到达最小值 12 和最大值 60,其外侧不再留有任何点。除非完整范围本身就是要传达的信息,否则应优先使用默认值:拉长的须线会掩盖极端值的异常程度。另请注意,空列不会引发错误——Seaborn 会返回一个空的坐标轴——因此当数据来自流水线时,请在绘图前检查行数。
