HOWTO · Seaborn
BoxPlot Seaborn
Ce tutoriel montre comment créer des boîtes à moustaches à l'aide du module Seaborn en python
Sur cette page
Utilisez seaborn.boxplot() pour résumer une distribution numérique ou comparer des valeurs entre catégories. Indiquez explicitement les colonnes de données afin que Seaborn sache quelle variable placer sur chaque axe. Un diagramme en boîte montre la médiane et l’écart interquartile (IQR) ; avec la règle par défaut pour les moustaches, celles-ci atteignent les observations les plus extrêmes situées à moins de 1,5 IQR de la boîte, tandis que les observations plus éloignées apparaissent sous forme de points individuels.
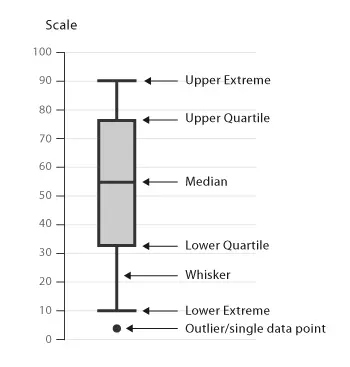
Chaque exemple de cet article utilise les mêmes éléments : la boîte couvre la moitié centrale des données, la ligne à l’intérieur est la médiane, les moustaches marquent l’étendue selon la règle choisie, et tout point au-delà des moustaches est tracé individuellement.
Créer un diagramme en boîte pour une distribution
Placez les mesures dans une colonne d’un DataFrame et associez cette colonne à y. Le rôle des données est ainsi clair et le graphique reçoit un libellé d’axe pertinent. L’exemple ci-dessous utilise des valeurs fixes : les mêmes données sont donc utilisées à chaque exécution.
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Score")
ax.set_title("Score distribution")
plt.show()
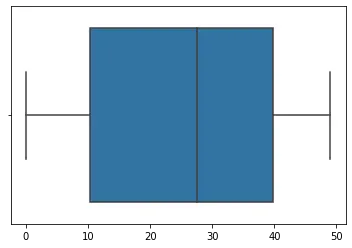
La ligne à l’intérieur de la boîte indique la médiane. La boîte s’étend du premier au troisième quartile ; sa hauteur représente donc la moitié centrale des observations. Une boîte plus haute signale une plus grande dispersion dans cette partie centrale des données. Les moustaches indiquent l’étendue définie par la règle choisie ; elles n’atteignent pas nécessairement les valeurs minimale et maximale.
Comparer des distributions entre catégories
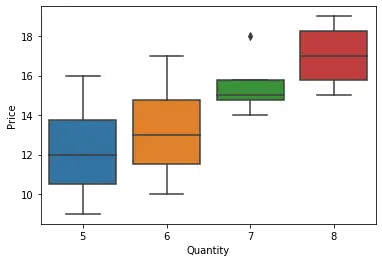
Associez une catégorie à x et la mesure numérique à y pour afficher une boîte distincte pour chaque catégorie. Dans ce jeu de données, chaque boîte résume le prix (Price) pour un niveau de quantité (Quantity). L’ajout de hue="Product" répartit chaque catégorie en groupes de produits, ce qui facilite leur comparaison pour une même quantité.
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
        "Product": ["A", "A", "A", "A", "B", "B", "B", "B"] * 2,
    }
)
ax = sns.boxplot(data=data, x="Quantity", y="Price", hue="Product")
ax.set_title("Price by quantity and product")
plt.show()
Utilisez hue lorsque le regroupement supplémentaire répond à une question de comparaison. Si les groupes sont nombreux, les boîtes risquent d’être serrées ; simplifiez les catégories ou créez des graphiques séparés afin que les distributions restent lisibles.
Afficher les observations individuelles avec un strip plot
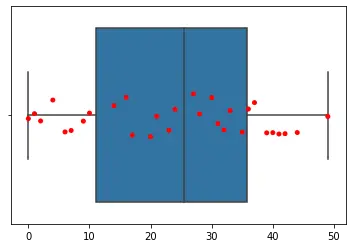
Un diagramme en boîte condense les données sous forme de statistiques récapitulatives. Superposez seaborn.stripplot() si les lecteurs doivent aussi voir chaque observation. Réutilisez le même axe et les mêmes associations de variables pour les deux couches, puis ajoutez une légère dispersion horizontale afin que les points ayant des valeurs proches ne se chevauchent pas complètement.
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Score", color="lightgray")
sns.stripplot(data=data, y="Score", color="darkred", jitter=0.15, ax=ax)
ax.set_title("Scores with individual observations")
plt.show()
La boîte reste le résumé, tandis que chaque marqueur représente une ligne des données. Avec un jeu de données plus volumineux, les points peuvent se chevaucher ; ajustez leur taille ou leur transparence pour que les zones denses restent lisibles.
Personnaliser le diagramme en boîte
Utilisez les méthodes de Matplotlib pour régler les limites des axes et mettre l’accent sur une plage de valeurs pertinente, linewidth pour modifier l’épaisseur des bordures de la boîte et des moustaches, et palette pour attribuer des couleurs aux catégories. Le paramètre orient contrôle l’orientation ; par exemple, orient="h" demande un graphique horizontal lorsque les associations de variables le permettent. Les limites d’axes ne modifient que la vue affichée : choisissez-les avec soin et gardez une échelle claire pour éviter de masquer des observations pertinentes.
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
        "Product": ["A", "A", "A", "A", "B", "B", "B", "B"] * 2,
    }
)
ax = sns.boxplot(
    data=data,
    x="Quantity",
    y="Price",
    hue="Product",
    linewidth=2.5,
    palette="Set2",
)
ax.set_ylim(8, 20)
ax.set_title("Customized price comparison")
plt.show()
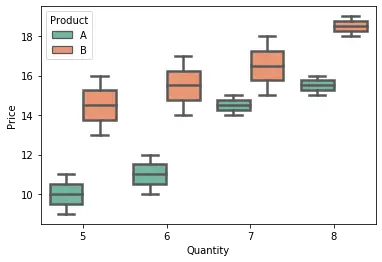
Les couleurs de la palette correspondent aux groupes définis par hue. Pour obtenir des boîtes horizontales, inversez les associations de la catégorie et de la mesure, puis définissez orient="h" ; réglez alors les limites de l’axe avec set_xlim() plutôt qu’avec set_ylim().
Créer un diagramme en boîte avec catplot()
Utilisez catplot() avec kind="box" pour passer par l’interface au niveau de la figure. Cette fonction accepte les mêmes associations explicites de données et peut créer des panneaux distincts avec col ou row lorsqu’une autre variable doit séparer la comparaison. Pour un graphique unique, seaborn.boxplot() est l’option au niveau des axes ; catplot() est pratique lorsque la figure doit être divisée en facettes.
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

data = pd.DataFrame(
    {
        "Quantity": [5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8, 5, 6, 7, 8],
        "Price": [9, 10, 15, 16, 13, 14, 15, 18, 11, 12, 14, 15, 16, 17, 18, 19],
    }
)
grid = sns.catplot(data=data, x="Quantity", y="Price", kind="box")
grid.set_axis_labels("Quantity", "Price")
grid.fig.suptitle("Price by quantity")
plt.show()
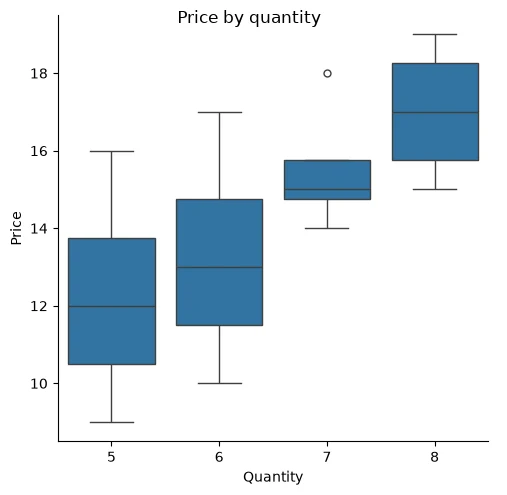
Comme catplot() construit la figure entière, il renvoie un objet grille plutôt qu’un seul axe ; définissez les libellés et les titres sur la grille, comme dans l’exemple, au lieu d’appeler ax.set_title().
Corriger une erreur de colonne manquante et régler l’étendue des moustaches
Comme chaque correspondance nomme une colonne du DataFrame, un nom mal orthographié échoue avant que quoi que ce soit ne soit dessiné. Cet appel demande une colonne Scroe que les données ne contiennent pas :
import pandas as pd
import seaborn as sns

data = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24]})
ax = sns.boxplot(data=data, y="Scroe")
L’appel se termine par cette erreur :
ValueError: Could not interpret value `Scroe` for `y`. An entry with this name does not appear in `data`.
Corrigez le nom pour qu’il corresponde exactement à la colonne — ici, y="Score" — et le même appel dessinera le graphique. Quand l’orthographe correcte n’est pas évidente, affichez data.columns et copiez le nom depuis la liste ; la vérification s’applique de la même façon à x, y et hue.
Les moustaches sont l’autre limite que rencontrent les lecteurs. Ajoutez une valeur éloignée, 60, aux scores : les quartiles bougent à peine (premier quartile 15, médiane 18, troisième quartile 21) et, avec la valeur par défaut whis=1.5, la moustache supérieure s’arrête à 24 tandis que 60 est tracé comme un point isolé au-delà. Passer whis comme une paire de percentiles étire les moustaches jusqu’à ces percentiles des données :
import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

scores = pd.DataFrame({"Score": [12, 14, 15, 16, 18, 19, 21, 24, 60]})
ax = sns.boxplot(data=scores, y="Score", whis=(0, 100))
plt.show()
Avec whis=(0, 100), les moustaches atteignent le minimum 12 et le maximum 60, et aucun point ne reste à l’extérieur. Préférez la valeur par défaut, sauf si l’étendue complète est le message : des moustaches étirées masquent à quel point la valeur extrême est inhabituelle. Notez aussi qu’une colonne vide ne lève pas d’erreur — Seaborn renvoie des axes vides — donc vérifiez le nombre de lignes avant de tracer lorsque les données proviennent d’un pipeline.