HOWTO · R
在 Base R 中执行 K-Means 聚类
本文介绍如何使用 Base R 函数进行 K-means 聚类,并通过肘部图选择候选聚类数;变量超过两个时,还会展示 PCA 散点图。
本页内容
使用 Base R 的 kmeans() 对数值观测值进行分组,查看生成的 cluster 分配和 tot.withinss,并通过肘部图比较候选 K 值。对于两个变量,可用散点图查看输入观测值;对于更多变量,可使用 prcomp() 查看按拟合分配着色的双主成分投影。以下示例使用可重现的合成数据集。
R 中的 K-means 聚类简介
K-means 是一种无监督方法:它根据观测值到聚类中心的距离,将观测值划分为指定数量的组。该方法不使用因变量或目标变量。输入应包含数值测量值;因子即使其各水平以数字表示,仍然是分类变量,因此只有当这些编码代表有意义的定量值时,才应将因子转换为数值。
K-means 会为每个观测值分配一个簇,并且可能对离群值较敏感。当各组较为紧凑且彼此分离时,这种方法最有用;如果各组高度重叠,划分结果可能没有实际意义。在解释结果之前,应先判断这种基于距离的方法是否适合所用变量和分析问题。
R 中的 kmeans() 函数
Base R 提供了 kmeans(x, centers, nstart) 来拟合模型。x 是数值矩阵或数据框,centers 可以是所需的簇数,也可以是初始中心值;当 centers 为簇数时,nstart 控制尝试的随机初始中心组数。
每次初始化都可能得到不同的局部解。当 centers 为数值时,nstart 会让 kmeans() 保留尝试过的拟合中簇内总平方和最低的结果;但这并不保证找到全局最优解。增大该值可以减少结果对单一初始配置的依赖,但会增加计算量。
R 中的 K-means 模型
这个独立示例会创建由两个变量构成的三组观测值,拟合模型,并显示其分配结果和簇内总平方和。簇标签只是任意标识符:这些数字不能证明分组正确,而且不同拟合之间标签顺序也可能改变。示例输出中的可见英文标签会保留原样;这里展示的是观测值的簇分配和簇内总平方和。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(9944)
km_1 <- kmeans(DF, centers = 3, nstart = 20)
km_1$cluster
km_1$tot.withinss
 [1] 1 1 1 1 1 1 1 1 1 1 1 1 1 3 3 3 3 3 3 3 3 3 3 3 2 2 2 2 2 2 2 2 2 2 2 2 2 2
[1] 46.40382
簇的数量(K)
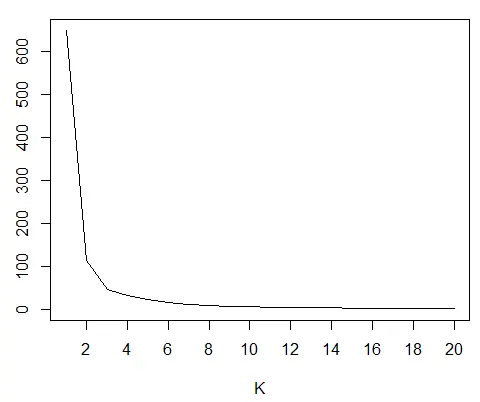
通常无法预先知道应分成多少组。可以分别拟合不同的 K 值,并绘制 tot.withinss,以比较候选值。随着 K 增大,可达到的最小簇内平方和不会增加,因为增加一个簇后仍可保留原有划分。实际使用时,由启发式 kmeans() 拟合得到的分数可能因各次拟合收敛到不同的局部解而波动,即使使用了多次初始化也是如此。因此,应选择合适的权衡,而不是简单地挑选观测到的最小分数。肘部法是一种启发式方法:寻找曲线的转折点,观察此后增加簇数带来的改善是否变小,再考虑该划分对分析是否有用。
下面的独立示例绘制候选值从 1 到 20 时的簇内平方和,与图中的范围一致。曲线形状可以提示值得进一步考察的值,但不能确立真实答案。对于这个构造的数据集,3 是一个值得结合领域背景进行比较的候选值。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(8520)
candidate_k <- 1:20
within_ss <- vapply(candidate_k, function(k) {
  kmeans(DF, centers = k, nstart = 18)$tot.withinss
}, numeric(1))
plot(candidate_k, within_ss, type = "b", xlab = "K", ylab = "Total within-cluster sum of squares")
现有肘部图展示了这种比较。应将曲线转折视为进一步分析的线索,而不是 K = 3 普遍正确或唯一正确的证明。
在 R 中可视化聚类结果
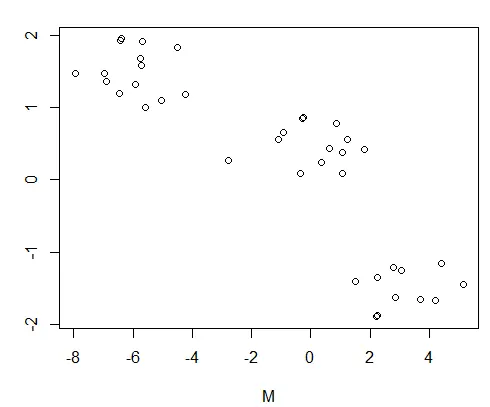
对于两个变量,可以先用散点图查看输入观测值。这个未着色的视图显示了观测值的位置,便于在解释拟合得到的 cluster 分配之前检查数据;它并未展示模型标签。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

plot(DF$M, DF$N, xlab = "M", ylab = "N")
要直接显示拟合分配,可对相同的双变量数据拟合 kmeans(),并将 km_1$cluster 用作每个观测值的 col 值。因此,第 i 行的颜色对应第 i 行的分配;颜色表示模型标签,而不是组的排名。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(9944)
km_1 <- kmeans(DF, centers = 3, nstart = 20)
plot(DF$M, DF$N, col = km_1$cluster, pch = 19,
     xlab = "M", ylab = "N")
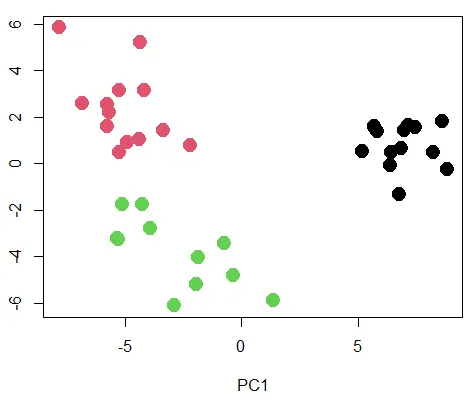
当数据包含两个以上的变量时,prcomp() 可以将数据投影到前两个主成分上,以便进行二维查看。该图压缩了高维数据,因此投影中的距离和分离程度可能无法体现原始空间的所有特征。此示例在拟合并绘制投影之前增加了第三个数值变量;与图中一样,水平轴标记为 PC1,垂直轴则没有标注。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
O1 <- rnorm(13, 10, 2)
O2 <- rnorm(11, 5, 3)
O3 <- rnorm(14, 0, 2)
DF <- rbind(
  data.frame(M = M1, N = N1, O = O1),
  data.frame(M = M2, N = N2, O = O2),
  data.frame(M = M3, N = N3, O = O3)
)

set.seed(9944)
km_2 <- kmeans(DF, centers = 3, nstart = 20)
pca_mod <- prcomp(DF)
plot(pca_mod$x[, 1:2], col = km_2$cluster, pch = 19, cex = 1.5,
     xlab = "PC1", ylab = "")
其他实用注意事项
- 如果需要在相同的 R 环境中重复获得相同的随机初始化结果,请在拟合前使用
set.seed()。 kmeans()要求输入完整的数值数据。如果分析适合删除含缺失值的行,可使用na.omit()删除不完整的观测值;请检查删除后剩余的行数,以及这种删除是否改变了所代表的总体。- 数值尺度较大的变量可能主导欧几里得距离。
scale()会对各列进行中心化和缩放;当变量的单位或取值范围不应赋予不同权重时,这可能会有帮助。缩放是一种建模选择,并非必需;如果原始尺度差异具有实际意义,就应保留原始尺度。 - 如果使用缩放后的数据进行聚类,并希望 PCA 视图反映拟合时使用的距离,请在 PCA 视图中使用相同的转换后数据。
参考资料
《An Introduction to Statistical Learning》介绍了如何使用 R 进行 K-means 聚类。