HOWTO · R
在 Base R 中執行 K-Means 聚類
本文示範如何使用 Base R 函式進行 K-means 分群,並在 Base R 中完成選擇 K 的肘部圖,以及變數超過兩個時使用 PCA 繪製散點圖等步驟。
本頁內容
使用 Base R 的 kmeans() 將數值觀測值分群,檢視產生的 cluster 分配與 tot.withinss,並以肘部圖比較候選 K 值。只有兩個變數時,可用散點圖檢視輸入觀測值;變數較多時,則可使用 prcomp() 查看依擬合分配著色的雙成分投影。以下範例使用可重現的合成資料集。
R 中的 K-Means 分群
K-means 是一種非監督式方法:它依據觀測值與群集中心之間的距離,將觀測值分成指定數量的群組。此方法不使用因變數或目標變數。輸入資料應包含數值測量值;因子即使以數字表示各層級,仍是類別資料,因此只有在這些代碼代表有意義的定量值時,才應將因子轉換為數值。
K-means 會將每筆觀測值指派到某個群集,也可能受到離群值影響。當群組大致緊密且彼此分離時,這種方法最有用;若群組高度重疊,分群結果可能沒有實質意義。在解讀結果之前,請先考量這種以距離為基礎的方法是否適合你的變數與分析問題。
R 中的 kmeans() 函式
Base R 提供 kmeans(x, centers, nstart) 來擬合模型。x 是數值矩陣或資料框;centers 可以是要求的群集數,也可以是初始中心值;當 centers 是數字時,nstart 控制要嘗試多少組隨機初始中心。
每次初始化都可能得到不同的局部解。當 centers 是數字時,nstart 會讓 kmeans() 保留在已嘗試的擬合結果中,群內平方和總和最低的那一個;但這不保證找到全域最佳解。提高此值可以降低結果對單一初始設定的依賴,但會增加計算成本。
R 中的 K-Means 模型
這個獨立範例會建立由兩個變數構成的三群觀測值、擬合模型,並顯示模型的分配結果與群內平方和總和。群集標籤只是任意的識別值:數字本身不能證明分群正確,而且不同次擬合的標籤順序可能改變。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(9944)
km_1 <- kmeans(DF, centers = 3, nstart = 20)
km_1$cluster
km_1$tot.withinss
 [1] 1 1 1 1 1 1 1 1 1 1 1 1 1 3 3 3 3 3 3 3 3 3 3 3 2 2 2 2 2 2 2 2 2 2 2 2 2 2
[1] 46.40382
群集數量(K)
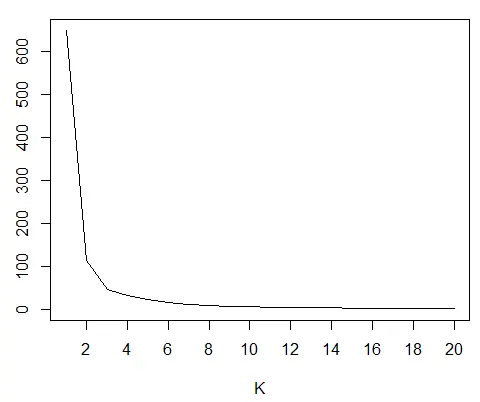
群組數量通常無法事先得知。可分別擬合不同模型,並繪製 tot.withinss,比較候選的 K 值。隨著 K 增加,可達到的最低群內平方和不會上升,因為增加群集可以保留先前的分區方式。實務上,不同的啟發式 kmeans() 擬合即使使用多個起始點,也可能因收斂到不同局部解而使分數波動;因此,應選擇實用的折衷方案,而不是單純挑選觀察到的最低分數。肘部法是一種啟發式方法:找出增加群集後改善幅度開始變小的轉折點,再考量該分區對分析是否有用。
以下獨立範例繪製候選值從 1 到 20 的群內平方和,與圖中的範圍一致。曲線形狀可提示值得進一步檢視的值,但無法確立真實分群數。對於這組建構的資料,3 是值得結合領域背景進一步比較的候選值。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(8520)
candidate_k <- 1:20
within_ss <- vapply(candidate_k, function(k) {
  kmeans(DF, centers = k, nstart = 18)$tot.withinss
}, numeric(1))
plot(candidate_k, within_ss, type = "b", xlab = "K", ylab = "Total within-cluster sum of squares")
現有的肘部圖呈現了這項比較。請將轉折點視為進一步分析的提示,而非 K = 3 在所有情況下或唯一正確的證明。
在 R 中視覺化群集
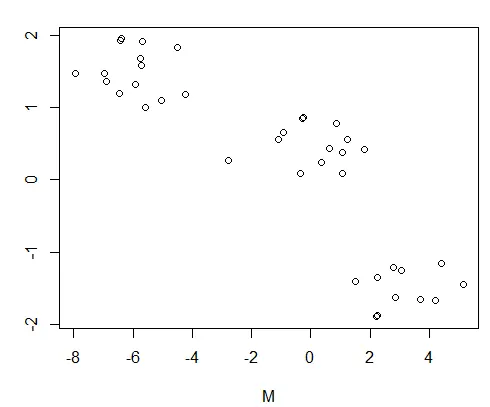
只有兩個變數時,可先用散點圖檢視輸入觀測值。這張未著色的圖顯示觀測值的位置,方便在解讀擬合的 cluster 分配之前先查看資料;它不會呈現模型標籤。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

plot(DF$M, DF$N, xlab = "M", ylab = "N")
若要直接呈現擬合後的分配,請對相同的雙變數資料擬合 kmeans(),並將 km_1$cluster 作為每筆觀測值的 col 值。因此,第 i 列的顏色對應該列的分配;顏色代表模型標籤,不代表群組排名。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
DF <- rbind(
  data.frame(M = M1, N = N1),
  data.frame(M = M2, N = N2),
  data.frame(M = M3, N = N3)
)

set.seed(9944)
km_1 <- kmeans(DF, centers = 3, nstart = 20)
plot(DF$M, DF$N, col = km_1$cluster, pch = 19,
     xlab = "M", ylab = "N")
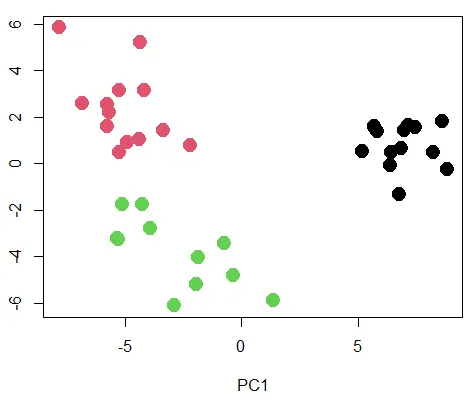
當資料包含兩個以上的變數時,prcomp() 可將資料投影到前兩個主成分,以供二維檢視。這張圖將高維資料壓縮呈現,因此投影中的距離與分離程度可能無法反映原始空間的所有特性。此範例會在擬合並繪製投影前加入第三個數值變數;如圖所示,水平軸標記為 PC1,垂直軸則不加標籤。
set.seed(4987)
M1 <- rnorm(13)
set.seed(9874)
M2 <- rnorm(11) + 3
set.seed(8749)
N1 <- runif(13)
set.seed(7498)
N2 <- runif(11) - 2
set.seed(6237)
M3 <- rnorm(14) - 6
set.seed(2376)
N3 <- runif(14) + 1
O1 <- rnorm(13, 10, 2)
O2 <- rnorm(11, 5, 3)
O3 <- rnorm(14, 0, 2)
DF <- rbind(
  data.frame(M = M1, N = N1, O = O1),
  data.frame(M = M2, N = N2, O = O2),
  data.frame(M = M3, N = N3, O = O3)
)

set.seed(9944)
km_2 <- kmeans(DF, centers = 3, nstart = 20)
pca_mod <- prcomp(DF)
plot(pca_mod$x[, 1:2], col = km_2$cluster, pch = 19, cex = 1.5,
     xlab = "PC1", ylab = "")
其他實務考量
- 若需要在相同的 R 環境中重複得到一致的隨機初始化結果,請在擬合前使用
set.seed()。 kmeans()需要完整的數值輸入。如果依分析需求可以刪除含缺失值的列,na.omit()可移除不完整的觀測值;請檢查剩餘列數,以及省略資料是否改變了所代表的母體。- 數值尺度較大的變數可能主導歐幾里得距離。當變數的單位或範圍不應具有不同權重時,
scale()可將各欄置中並縮放,或許有所幫助。縮放是建模選擇,不是必要步驟;若原始尺度的差異具有意義,就應保留原尺度。 - 若以縮放後的資料進行分群,而希望 PCA 圖反映擬合時使用的距離,請在 PCA 檢視中使用相同的轉換後資料。
參考資料
《An Introduction to Statistical Learning》一書介紹了如何使用 R 進行 K-means 分群。