
HOWTO · Python
Python 中的二项分布
本教程讨论 Python 中的二项分布。
本页内容
二项分布用于描述:在固定次数的独立试验中,每次试验只有两种结果,且成功概率相同,此时成功次数的分布。在 Python 中,NumPy 可生成成功次数的样本,SciPy 可计算精确概率和累积概率。本指南说明模型适用的条件、相关函数的用法,以及如何解读概率质量图。主要函数是 numpy.random.binomial、scipy.stats.binom.pmf 和 scipy.stats.binom.cdf。
什么是二项分布?
设 n 为试验次数,p 为每次试验成功的概率,k 为成功次数。随机变量 X 统计成功次数,因此它可能取从 0 到 n 的所有整数。恰好成功 k 次的概率为
[ P(X = k) = \binom{n}{k} p^k (1-p)^{n-k} ]
例如,公平硬币抛掷十次时,n = 10、p = 0.5;这个模型可以计算恰好出现四次正面的概率。这里的“成功”只是指所要统计的结果,例如出现正面、商品有缺陷或客户完成转化。该模型描述各次试验中的成功总数,不描述成功出现的先后顺序。
使用 NumPy 生成随机结果
当你需要模拟计数(例如重复进行一组实验)时,可以使用 NumPy。参数 n 表示每次实验的试验次数,p 表示每次试验成功的概率,size 表示要生成多少个实验结果。在相同的 NumPy 环境中,设置随机种子可以复现样本;若不设置种子,之后运行可能会得到不同的计数。
运行以下示例:
本节中的代码以及显示的标签或输出仍为英文。
import numpy as np

rng = np.random.default_rng(7)
counts = rng.binomial(n=10, p=0.5, size=8)
print(counts)
counts 中的每个值表示十次试验中的成功总数。这些抽样值适用于模拟和探索,但它们不是精确概率;如果要计算指定事件发生的概率,请使用 SciPy 的分布函数。
使用 SciPy 计算精确概率
概率质量函数给出恰好成功 k 次的概率。按 k、n、p 的顺序,将这些参数传给 scipy.stats.binom.pmf。对于十次公平的硬币抛掷,令 k = 4,即可计算恰好出现四次正面的概率,结果约为 0.205(约 20.5%)。
本节中的代码以及显示的标签或输出仍为英文。
from scipy.stats import binom

n = 10
p = 0.5
k = 4
probability = binom.pmf(k, n, p)
print(f"P(X = {k}) = {probability:.6f}")
PMF 用于计算某个确切计数的概率。若要询问某个范围或阈值的概率,请改用累积分布函数。
使用 SciPy 计算累积概率
累积分布函数会将成功次数从零到指定计数的概率相加。因此,scipy.stats.binom.cdf(k, n, p) 表示 P(X <= k),其中包含计数 k。例如,它可以计算十次公平硬币抛掷中,正面至多出现四次的概率。
本节中的代码以及显示的标签或输出仍为英文。
from scipy.stats import binom

n = 10
p = 0.5
k = 4
probability_at_most_k = binom.cdf(k, n, p)
print(f"P(X <= {k}) = {probability_at_most_k:.6f}")
若要计算“多于 k 次”的概率,可用 1 减去包含边界的 CDF:1 - binom.cdf(k, n, p)。这样可以避免误把“至多”与“少于”当成同一事件;由于计数是整数,两者的边界不同。
可视化二项分布
概率质量函数图以可能的成功次数为横轴,以对应概率为纵轴。因此,柱形表示每种计数对应的概率,而不是观测样本的直方图。下方图表使用同一个 n = 10、p = 0.5 示例,并为每种可能的计数都标出了刻度。
本节中的代码以及显示的标签或输出仍为英文。
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import binom

n = 10
p = 0.5
successes = np.arange(n + 1)
probabilities = binom.pmf(successes, n, p)

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.bar(successes, probabilities, color="#9fc5df", edgecolor="#315a73")
ax.set_title("Binomial probability mass (n=10, p=0.5)")
ax.set_xlabel("Number of successes")
ax.set_ylabel("Probability")
ax.set_xticks(successes)
ax.set_ylim(bottom=0)
fig.tight_layout()
plt.show()
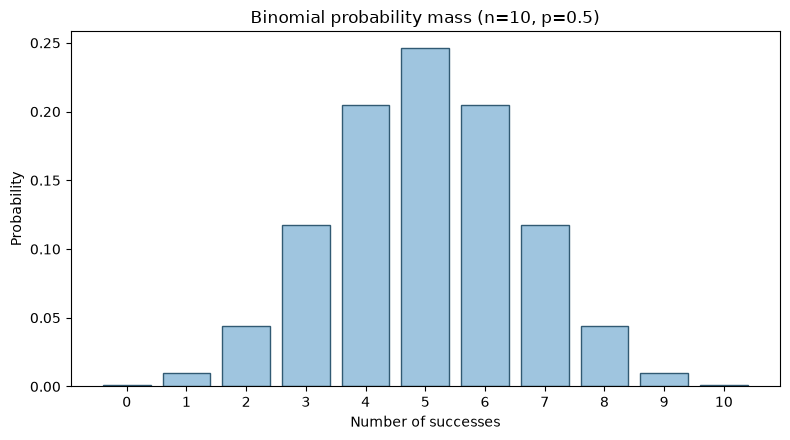
柱形表示每种可能计数对应的概率,由 SciPy 的 PMF 计算。图表标题和坐标轴标签保留英文。
检查二项分布的适用条件
应用该模型前,请检查产生数据的过程是否符合以下条件:
- **试验次数固定:**统计结果之前,实验的
n已确定。 - **每次试验有两种结果:**针对当前问题,每次试验都能归类为成功或失败。
- **试验相互独立:**一次试验的结果不会改变其他试验的结果概率。从小总体中不放回抽样可能不满足这一条件。
- **成功概率恒定:**每次试验使用相同的
p。如果成功概率在不同试验间变化,单一二项模型可能无法正确描述计数。
如果这些条件都符合,NumPy 抽样和 SciPy 概率计算就能回答有关同一计数模型的不同问题。如果试验次数或成功概率会变化,请先重新考虑模型是否适用,再解读其概率。
