HOWTO · Python
Distribución Binomial en Python
Este tutorial trata sobre la distribución binomial en Python.
En esta página
Una distribución binomial modela el número de éxitos en una cantidad fija de ensayos independientes, cuando cada ensayo tiene dos resultados posibles y la misma probabilidad de éxito. En Python, NumPy puede generar recuentos de muestras y SciPy calcular probabilidades exactas y acumuladas. Esta guía explica cuándo se aplica el modelo, cómo usar esas funciones y cómo interpretar una gráfica de masa de probabilidad. Las funciones principales son numpy.random.binomial, scipy.stats.binom.pmf y scipy.stats.binom.cdf.
¿Qué es una distribución binomial?
Sea n el número de ensayos, p la probabilidad de éxito en cada ensayo y k el número de éxitos. La variable aleatoria X cuenta los éxitos, por lo que sus valores posibles son los números enteros de 0 a n. La probabilidad de obtener exactamente k éxitos es
[ P(X = k) = \binom{n}{k} p^k (1-p)^{n-k} ]
Por ejemplo, diez lanzamientos de una moneda equilibrada tienen n = 10 y p = 0.5; el modelo permite calcular la probabilidad de obtener exactamente cuatro caras. Un «éxito» es simplemente el resultado que se cuenta, como una cara, un artículo defectuoso o la conversión de un cliente. El modelo describe el recuento de éxitos en los ensayos, no el orden en que ocurren.
Generar resultados aleatorios con NumPy
Usa NumPy cuando necesites recuentos simulados, por ejemplo, para un conjunto de experimentos repetidos. El argumento n indica el número de ensayos de cada experimento; p, la probabilidad de éxito en cada ensayo; y size, la cantidad de resultados de experimentos que se generarán. Una semilla permite reproducir una muestra en el mismo entorno de NumPy; si no se establece, otra ejecución puede producir recuentos distintos.
Ejecuta este ejemplo:
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
import numpy as np

rng = np.random.default_rng(7)
counts = rng.binomial(n=10, p=0.5, size=8)
print(counts)
Cada valor de counts es el número total de éxitos en diez ensayos. Estos valores de muestra sirven para simulaciones y exploraciones, pero no son probabilidades exactas; usa las funciones de distribución de SciPy cuando necesites calcular la probabilidad de un suceso concreto.
Calcular probabilidades exactas con SciPy
La función de masa de probabilidad indica la probabilidad de obtener exactamente k éxitos. Pasa k, n y p, en ese orden, a scipy.stats.binom.pmf. Para diez lanzamientos de una moneda equilibrada, al pedir k = 4 se obtiene la probabilidad de sacar exactamente cuatro caras: aproximadamente 0.205 (alrededor del 20.5 %).
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from scipy.stats import binom

n = 10
p = 0.5
k = 4
probability = binom.pmf(k, n, p)
print(f"P(X = {k}) = {probability:.6f}")
La PMF calcula la probabilidad de un único recuento exacto. Para consultar un intervalo o un umbral, usa en su lugar la función de distribución acumulada.
Calcular probabilidades acumuladas con SciPy
La función de distribución acumulada suma las probabilidades desde cero éxitos hasta el recuento solicitado, inclusive. Por tanto, scipy.stats.binom.cdf(k, n, p) representa P(X <= k): incluye el recuento k. Por ejemplo, permite calcular la probabilidad de obtener como máximo cuatro caras en diez lanzamientos de una moneda equilibrada.
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
from scipy.stats import binom

n = 10
p = 0.5
k = 4
probability_at_most_k = binom.cdf(k, n, p)
print(f"P(X <= {k}) = {probability_at_most_k:.6f}")
Para una consulta sobre «más de k», resta la CDF inclusiva de uno: 1 - binom.cdf(k, n, p). Así evitas confundir «como máximo» con «menos de»: como los recuentos son enteros, los límites de esos sucesos son distintos.
Visualizar la distribución binomial
Una gráfica de la función de masa de probabilidad sitúa cada recuento posible de éxitos en el eje horizontal y su probabilidad en el eje vertical. Por tanto, las barras muestran la probabilidad asignada a cada recuento; no son un histograma de muestras observadas. La gráfica siguiente usa el mismo ejemplo con n = 10 y p = 0.5, e incluye una marca para cada recuento posible.
El código y las etiquetas o salidas visibles de esta sección se mantienen en inglés.
import matplotlib.pyplot as plt
import numpy as np
from scipy.stats import binom

n = 10
p = 0.5
successes = np.arange(n + 1)
probabilities = binom.pmf(successes, n, p)

fig, ax = plt.subplots(figsize=(8, 4.5))
ax.bar(successes, probabilities, color="#9fc5df", edgecolor="#315a73")
ax.set_title("Binomial probability mass (n=10, p=0.5)")
ax.set_xlabel("Number of successes")
ax.set_ylabel("Probability")
ax.set_xticks(successes)
ax.set_ylim(bottom=0)
fig.tight_layout()
plt.show()
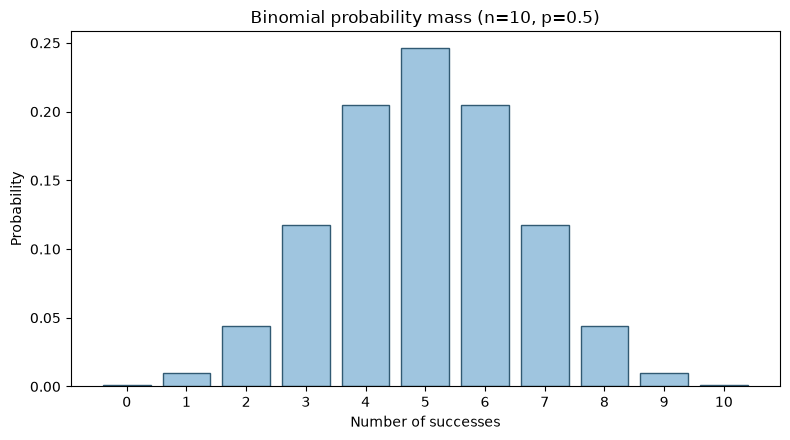
Las barras muestran la probabilidad de cada recuento posible, calculada con la PMF de SciPy.
Comprobar los supuestos de la distribución binomial
Antes de aplicar el modelo, comprueba el proceso que generó los datos:
- Número fijo de ensayos: se conoce
nantes de contar los resultados. - Dos resultados por ensayo: cada ensayo puede clasificarse como éxito o fracaso para la pregunta planteada.
- Ensayos independientes: un resultado no cambia las probabilidades de resultado de los demás. El muestreo sin reemplazo de una población pequeña puede incumplir esta condición.
- Probabilidad de éxito constante: todos los ensayos usan el mismo
p. Si la probabilidad cambia entre ensayos, un único modelo binomial quizá no describa correctamente el recuento.
Cuando se cumplen estas condiciones, el muestreo de NumPy y los cálculos de probabilidad de SciPy responden a preguntas relacionadas sobre el mismo modelo de recuento. Si varía el número de ensayos o la probabilidad de éxito, reconsidera el modelo antes de interpretar sus probabilidades.