
HOWTO · R
R에서 Levene 검정 수행 방법
car 패키지를 사용해 R에서 Levene 검정을 수행합니다. 그룹화된 데이터를 준비하고, 등분산을 검정하고, p값을 해석하고, 상자 그림을 만듭니다.
이 페이지의 내용
R에서 Levene 검정을 수행하려면 car 패키지의 leveneTest() 함수를 숫자형 반응 변수와 그룹화 요인과 함께 사용합니다. 식 value ~ group은 group의 범주 간에 value의 변동성을 비교합니다.
Levene 검정 이해하기
귀무 가설은 모든 그룹의 분산이 같다는 것이고, 대립 가설은 적어도 하나가 다르다는 것입니다. 관측값은 독립적이어야 합니다.
기본적으로 leveneTest()는 그룹 중앙값으로부터의 절대 편차를 사용하며, 이를 흔히 Brown–Forsythe 변형이라고 합니다. 원래의 평균 중심 검정에는 center = mean을 사용합니다.
car 패키지 설치 및 불러오기
car는 R 환경마다 한 번씩 install.packages("car")로 설치합니다. 이를 위해서는 저장소 접근 권한이 필요하며, 의존 패키지가 함께 설치될 수 있습니다. 각 세션에서는 library(car)로 불러옵니다.
car::leveneTest()를 사용하면 패키지를 연결하지 않고도 함수에 접근할 수 있지만, 설치는 여전히 필요합니다. R에서 ‘car’라는 패키지가 없다고 보고하면, 스크립트를 실행하는 R 환경에 설치하거나 아래의 base R 계산을 사용합니다. 아래의 두 base R 예시는 모두 실행되었습니다. 패키지 설치와 별도로 제시된 car::leveneTest() 예시는 검증되지 않은 상태로 남아 있으며, 렌더링된 PDF는 시각적으로 검토되지 않았습니다.
그룹화된 데이터 준비하기
관측값마다 한 행을 사용하고, 숫자형 측정값과 범주형 그룹 레이블을 준비합니다. 예시에서는 그룹마다 30개의 측정값을 생성하는데, 평균은 모두 5이지만 표준 편차는 1, 1.5, 2입니다. set.seed(123)은 시뮬레이션을 재현 가능하게 만들고, factor()는 그룹화 열을 명시적으로 준비합니다.
자신의 데이터에서는 분석 전에 누락된 측정값과 레이블을 확인합니다. 제외한 뒤에도 데이터가 있는 그룹을 최소 두 개 유지하고, 그룹 내 변동을 추정할 수 있을 만큼 충분한 관측값을 확보합니다.
R에서 Levene 검정 실행하기
중앙값 중심 검정은 base R로도 계산할 수 있습니다. 각 그룹의 중앙값으로부터의 절대 편차를 계산한 뒤, 그 편차에 일원 분산 분석을 적합합니다. 이 자체 완결형 예시는 추가 패키지가 필요 없습니다. 여기서는 콘솔 출력이 캡처되지 않은, 실행되지 않은 예시로 제시합니다. 실행하면 ANOVA 표가 출력됩니다.
set.seed(123)
group1 <- rnorm(30, mean = 5, sd = 1)
group2 <- rnorm(30, mean = 5, sd = 1.5)
group3 <- rnorm(30, mean = 5, sd = 2)
data <- data.frame(
  value = c(group1, group2, group3),
  group = factor(rep(c("Group 1", "Group 2", "Group 3"), each = 30))
)
data$deviation <- abs(data$value - ave(data$value, data$group, FUN = median))
levene_result <- anova(lm(deviation ~ group, data = data))
print(levene_result)
결과 표에서 F value, group과 Residuals의 자유도, 그리고 Pr(>F)를 읽습니다. p값을 미리 정한 유의 수준과 비교합니다. 자세한 내용은 다음 섹션에서 설명합니다.
ave()는 각 관측값에 해당 그룹의 중앙값을 할당합니다. 식 deviation ~ group은 그룹 간 평균 절대 편차를 비교하고, data = data는 열이 있는 위치를 지정합니다. car가 설치된 경우 동등한 호출은 car::leveneTest(value ~ group, data = data, center = median)이며, 이 패키지 의존 호출은 실행되지 않은 예시입니다.
결과 해석하기
표의 F value인 3.2694는 평균 절대 편차의 그룹 간 차이를 그룹 내 변동과 비교한 값입니다. Df 아래의 group 행과 Residuals 행은 분자와 분모의 자유도를 나타내며, 세 그룹과 90개의 관측값에서는 2와 87입니다. group 행의 Pr(>F)가 p값으로, 0.04275입니다.
유의 수준(예: 0.05)은 미리 정합니다. 미리 정한 유의 수준 0.05에서 이 예시의 p값 0.04275는 그룹 분산이 같다는 가설에 반대되는 증거를 제공하므로, 귀무 가설을 기각합니다. 그렇지 않은 경우, 선택한 수준 이상인 p값은 귀무 가설을 기각하지 않는다는 뜻이며, 이는 특히 표본이 작을 때 동등함을 증명하지는 않습니다. 이 검정은 어떤 그룹이 다른지를 식별하지도 않고, ANOVA의 모든 가정을 확립하지도 않습니다.
등분산이 의심스러울 때 이후의 그룹 평균 비교에서는, 연구 설계 및 다른 가정들과 함께 Welch의 ANOVA를 고려합니다.
그룹 분포 시각화하기
이 독립 실행형 예시는 데이터를 다시 만들고 상자 그림을 임시 PDF에 씁니다. R 세션에서 plot_path가 가리키는 파일을 여세요.
set.seed(123)
data <- data.frame(
  value = c(
    rnorm(30, mean = 5, sd = 1),
    rnorm(30, mean = 5, sd = 1.5),
    rnorm(30, mean = 5, sd = 2)
  ),
  group = factor(rep(c("Group 1", "Group 2", "Group 3"), each = 30))
)
plot_path <- tempfile(fileext = ".pdf")
pdf(plot_path)
boxplot(value ~ group, data = data,
        xlab = "Group", ylab = "Value", main = "Group distributions")
invisible(dev.off())
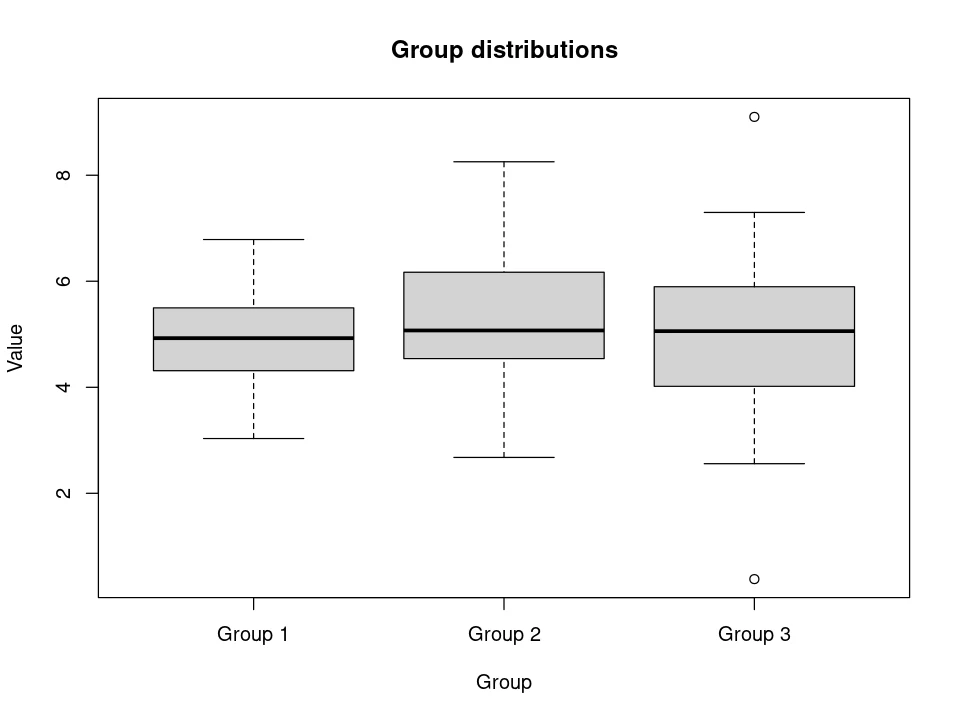
상자의 높이, 수염, 이상점을 비교하여 퍼짐의 차이를 확인합니다. 이 그림은 검정을 보완할 뿐, 검정을 대체하지 않으며 분산을 직접 보여 주지도 않습니다.
