TUTORIAL · Algorithm
カウントソート
このチュートリアルでは、カウントソートアルゴリズムを紹介します。
このページの内容
カウントソートは、各整数の出現回数を数え、その頻度を使って値をソート順に配置します。値同士の比較を避けられますが、実行時間とメモリ使用量は値の範囲幅に左右されます。そのため、範囲が十分に小さい場合に適しており、値がまばらに分布する広い範囲では実用的でないことがあります。また、基数ソートのサブルーチンとしても使われます。基本となる計算量は O(n + k) です。ここで n は値の個数、k は範囲幅を表します。
カウントソートの仕組み
入力に n 個の整数があるとします。最小値 min と最大値 max を求め、k = max - min + 1 個のカウンターを確保します。min をオフセットとして使うと、負の値も0以上のカウンターインデックスで表せます。
入力範囲の最小値から最大値までについて、各値 x をカウントインデックス x - min に対応付けます。
入力値 x ごとに count[x - min] を増やします。これが頻度です。カウンターインデックス i は値 min + i に対応します。各カウンターにひとつ前のカウンターの値を加えると、頻度を累積位置に変換できます。この処理の後、各カウンターは対応する値以下の入力値の個数を示します。つまり、その値が最後に現れる位置を1から数えた位置です。
キーを持つレコードを安定して並べるには、入力を右から左へ走査します。各レコードを count[key - min] - 1 に配置してから、そのカウンターを減らします。逆順に処理することで、同じキーを持つレコードの元の順序が保たれます。
キーでレコードを並べるときは、配置時に入力を右から左へ走査します。こうすると、同じキーを持つレコードの元の順序が保たれます。
入力が空ならカウンターは不要です。最小値や最大値を探す前に、空の結果を返します。基本的な整数用の実装では値をそのまま保持しますが、レコードを並べる場合は、配置時にレコード全体を出力配列へ格納する必要があります。
例:カウントソートで値を並べ替える
入力を (6, 3, 2, 7, 4, 5, 4, 2) とします。最小値は 2、最大値は 7、範囲幅は k = 7 - 2 + 1 = 6 です。カウンターインデックス 0 から 5 は、それぞれ値 2 から 7 に対応します。
| 値 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|
| 頻度 | 2 | 1 | 2 | 1 | 1 | 1 |
| 累積位置 | 2 | 3 | 5 | 6 | 7 | 8 |
たとえば、count[4 - 2] は 2 なので、値 4 は2回現れます。累積後の 4 のカウンターは 5 です。最後の 4 は、0から数える出力インデックス 4 に入ります。その位置を減らすと、もう一つの 4 のために直前の枠が確保されます。残りの値も同様に配置すると、(2, 2, 3, 4, 4, 5, 6, 7) になります。
次の図では、異なるレコードラベルを使って、オフセット、頻度、累積位置、逆順の配置がどのようにつながるかを示します。例には負のキーが含まれ、同じキーを持つレコードの入力順が保たれることも分かります。
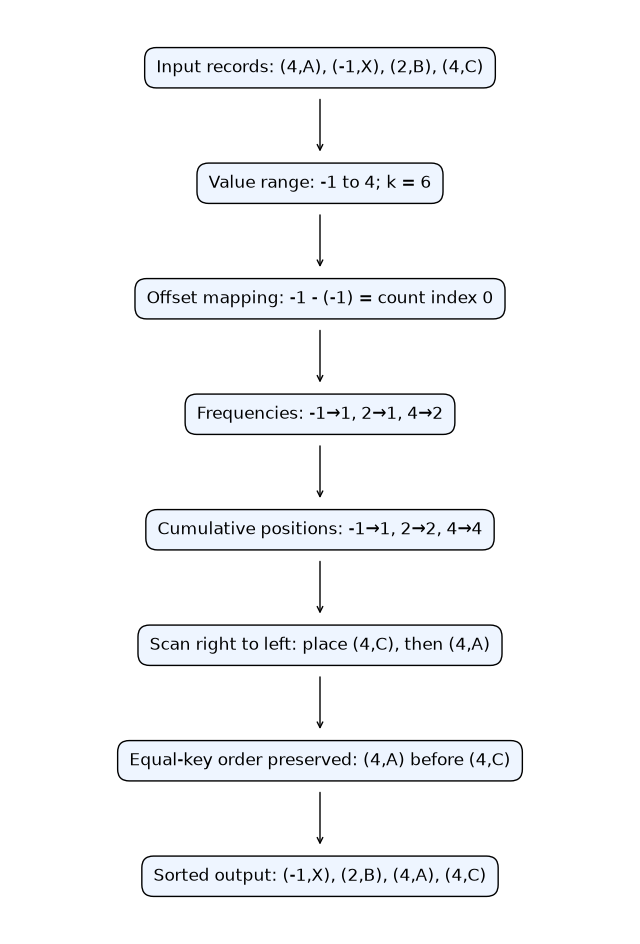
図:範囲 -1 から 4 は6個のカウントインデックスに対応します。頻度を累積位置に変換し、右から順に配置することで、出力でも (4,A) が (4,C) より前に保たれます。
C++でカウントソートを実装する
この完全な C++ の例は新しいベクターを返し、オフセットインデックスによって符号付き整数に対応します。また、範囲を調べる前に、要素のないベクターを処理します。可変長配列ではなく、標準コンテナーを使います。
次の例を実行してください。コードと出力のフェンス内はバイト単位で変更できないため、表示されるラベルは英語のままです。
#include <algorithm>
#include <cstddef>
#include <iostream>
#include <vector>

std::vector<int> countingSort(const std::vector<int>& values) {
    if (values.size() == 0) {
        return {};
    }

    const auto bounds = std::minmax_element(values.begin(), values.end());
    const long long minValue = *bounds.first;
    const long long maxValue = *bounds.second;
    const std::size_t range = static_cast<std::size_t>(maxValue - minValue + 1);
    std::vector<std::size_t> count(range, 0);

    for (int value : values) {
        const std::size_t index = static_cast<std::size_t>(value - minValue);
        ++count[index];
    }

    for (std::size_t i = 1; i < count.size(); ++i) {
        count[i] += count[i - 1];
    }

    std::vector<int> output(values.size());
    for (std::size_t i = values.size(); i-- > 0;) {
        const int value = values[i];
        const std::size_t index = static_cast<std::size_t>(value - minValue);
        output[--count[index]] = value;
    }
    return output;
}

int main() {
    const std::vector<int> input{6, 3, 2, 7, 4, 5, 4, 2};
    const std::vector<int> sorted = countingSort(input);

    std::cout << "Input: ";
    for (int value : input) {
        std::cout << value << ' ';
    }
    std::cout << "\nSorted: ";
    for (int value : sorted) {
        std::cout << value << ' ';
    }
    std::cout << '\n';
}
このサンプルをコンパイルして実行すると、入力値とソート後の値が表示されます。実装が並べ替えるのは整数です。レコードを安定して並べるには、キーだけでなくレコード全体を、同じ計算位置にある output に格納します。
計算量とカウントソートを使う場面
値の範囲を調べる処理、値を数える処理、位置を累積する処理、値を配置する処理は、それぞれ対象となる入力または範囲に対して線形時間で行えます。全体の実行時間は O(n + k) です。カウンターと出力ベクターに必要な補助領域も O(n + k) です。ここで k = max - min + 1 なので、コストは値の個数だけでなく、最小値と最大値の差にも左右されます。
値が整数で、k 個のカウンターと n 個の出力要素を確保できる程度に範囲が小さい場合は、カウントソートを使えます。たとえば、狭い固定範囲から得られた大量の点数を並べる場合に適しています。一方、少数の入力が非常に広い範囲に散らばっていると、ほとんどの値が現れなくても、メモリと初期化時間を使いすぎることがあります。その場合は比較ソートや基数ソートのほうが適する可能性があります。カウンターベクターが利用可能なメモリに収まるよう、確保する前に範囲幅を見積もってください。