
HOWTO · Pandas
パンダの家系図の紹介
このチュートリアルでは、Python で Pandas モジュールを使用して家系図のグラフ描画を作成することにつながるツリー データ構造について説明します。
このページの内容
このチュートリアルでは、ツリーのデータ構造とそのタイプを紹介し、Python でのファミリー ツリー (階層ツリー/一般ツリーとも呼ばれます) の実装について詳しく説明します。
ツリーデータ構造とその重要性
コンピューター サイエンスでは、ツリーは、根、枝、葉を持つ現実世界のツリーに着想を得ています。 唯一の違いは、ツリーのデータ構造が逆さまに視覚化され、root がツリーの最上部にあることです。 以下に視覚的な表現を示しましょう。
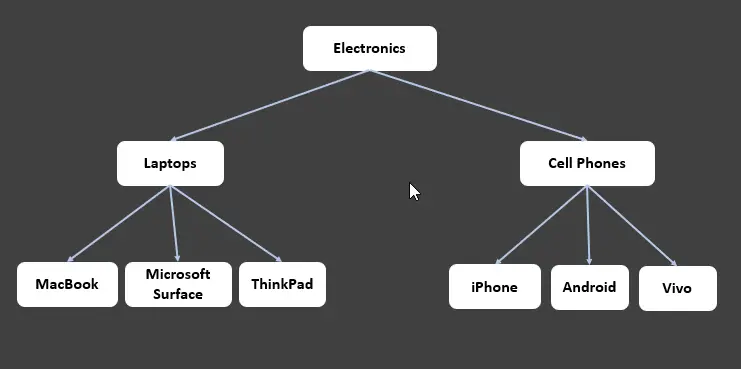
上記のツリーでは、すべてのエンティティがノードとして知られています。 Electronics ノードは root ノードです。 2つの子ノード Laptops と Cell Phones があり、各子ノードはリーフ ノード (子を持たないノード) の親です。
各矢印は、2つのノードを接続するエッジです。 これは次のように視覚化できます。
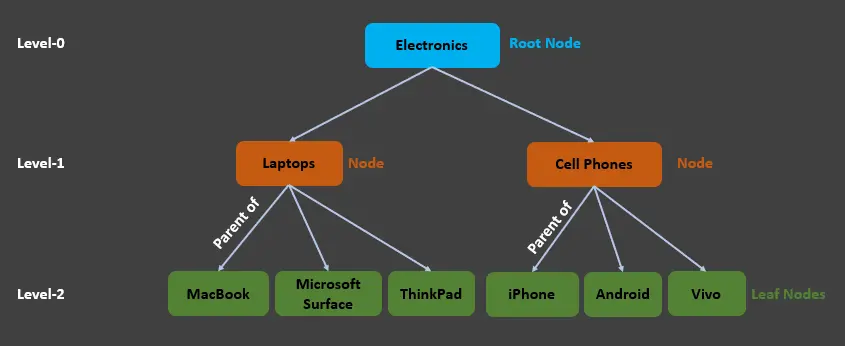
Level-0 には root ノード (Electronics) があり、Level-1 には Laptops と Cell Phones の 2つのノードがあることがわかります。
LaptopsはElectronicsの子ノードであり、リーフ ノード (MacBook、Microsoft Surface、ThinkPad) の親です。Cell PhonesはElectronicsの子ノードであり、リーフ ノード (iPhone、Android、Vivo) の親です。
エレクトロニクスと携帯電話は、iPhoneの祖先とも言えます。 同様に、Cell Phones と iPhone は Electronics ノードの子孫です。 同じケースがラップトップにも当てはまります。
これは、親子階層のため、階層データ構造とも呼ばれます。 ファイルシステムなど、問題の単純化、高速化、検索とソートが必要な場合に広く使用されます。
非線形データ構造を表現する必要がある場合はツリーを使用します。 ツリー データ構造を使用するには、各ツリーには特定の ルート ノードがあり、各子ノードには親があり、親は多くの子を持つことができるというプロパティを満たす必要があります。
このプロパティは、ツリー データ構造ごとに満たす必要がありますが、ツリー データ構造ごとに異なる追加プロパティがあります。
ツリー データ構造のタイプには、一般ツリー、バイナリ ツリー、バイナリ サーチ ツリー (BST)、Adelson-Velshi and Landis (AVL) ツリー、Red-Black ツリー、および ここ で見つけることができる N-ary ツリーが含まれます。 チュートリアルでは、一般ツリーのみに焦点を当てています。
パンダの家系図
先祖に関する情報を保存したテーブルを以下に示します。 子供に制約があってはなりません。 各ノードは無限の数の子ノードを持つことができます。
そのため、一般ツリーを使用して家系図を実装しています。
一般的なツリーでは、ツリーの階層に制限はなく、すべてのノードは無制限の数の子ノードを持つことができます。 一般的なツリーは、他のすべてのツリー データ構造のスーパーセットであることに注意してください。
祖先の情報テーブル:
id |
gender |
first_name |
last_name |
dob |
dod |
fid |
mid |
birth_place |
job |
|---|---|---|---|---|---|---|---|---|---|
AnAn |
M | アントニオ | アンドリーニ | 1901年 | コルレオーネ | ||||
SiAn |
ふ | シニョーラ | アンドリーニ | 1901年 | コルレオーネ | 専業主婦 | |||
PaAn87 |
M | パオロ | アンドリーニ | 1887年 | 1901年 | AnAn |
SiAn |
||
ViCo92 |
M | ヴィート | コルレオーネ | 1892年 | 1954年 | AnAn |
SiAn |
コルレオーネ | ゴッドファーザー |
CaCo97 |
ふ | カーメラ | コルレオーネ | 1897年 | 1959年 | ||||
ToHa10 |
M | トム | ハーゲン | 1910年 | 1970年 | ViCo92 |
CaCo97 |
ニューヨーク | コンシリエーレ |
SaCo16 |
M | サンティーノ | コルレオーネ | 1916年 | 1948年 | ViCo92 |
CaCo97 |
ニューヨーク | やくざ |
SaCo17 |
ふ | サンドラ | コロンボ | 1917年 | メッシーナ | ||||
FrCo19 |
M | フレデリコ | コルレオーネ | 1919年 | 1959年 | ViCo92 |
CaCo97 |
ニューヨーク | カジノマネージャー |
MiCo20 |
M | マイケル | コルレオーネ | 1920年 | 1997年 | ViCo92 |
CaCo97 |
ニューヨーク | ゴッドファーザー |
ThHa20 |
ふ | あります | ハーゲン | 1920年 | ニュージャージー | アートエキスパート | |||
LuMa23 |
ふ | ルーシー | マンチーニ | 1923年 | ホテル従業員 | ||||
KaAd24 |
ふ | ケイ | アダムス | 1934年 | |||||
FrCo37 |
ふ | フランセッサ | コルレオーネ | 1937年 | SaCo16 |
SaCo17 |
|||
KaCo37 |
ふ | キャスリン | コルレオーネ | 1937年 | SaCo16 |
SaCo17 |
|||
FrCo40 |
ふ | フランク | コルレオーネ | 1940年 | SaCo16 |
SaCo17 |
|||
SaCo45 |
M | サンティーノJr. | コルレオーネ | 1945年 | SaCo16 |
SaCo17 |
|||
FrHa |
M | フランク | ハーゲン | 1940年 | ToHa10 |
Th20 |
|||
AnHa42 |
M | アンドリュー | ハーゲン | 1942年 | ToHa10 |
Th20 |
祭司 | ||
ViMa |
M | ヴィンセント | マンチーニ | 1948年 | SaCo16 |
LuMa23 |
ニューヨーク | ゴッドファーザー | |
GiHa58 |
ふ | ジャンナ | ハーゲン | 1948年 | ToHa10 |
Th20 |
|||
AnCo51 |
M | アンソニー | コルレオーネ | 1951年 | MiCo20 |
KaAd24 |
ニューヨーク | 歌手 | |
MaCo53 |
ふ | メアリー | コルレオーネ | 1953年 | 1979年 | MiCo20 |
KaAd24 |
ニューヨーク | 学生 |
ChHa54 |
ふ | クリスティーナ | ハーゲン | 1954年 | ToHa10 |
Th20 |
|||
CoCo27 |
ふ | コンスタンシア | コルレオーネ | 1927年 | ViCo92 |
CaCo97 |
ニューヨーク | レンティエ | |
CaRi20 |
M | カルロ | リッツィ | 1920年 | 1955年 | ネバダ | ブックメーカー | ||
ViRi49 |
M | ビクター | リッツィ | 1949年 | CaRi20 |
CoCo27 |
ニューヨーク | ||
MiRi |
M | マイケル | リッツィ | 1955年 | CaRi20 |
CoCo27 |
個人間の関係は直接非巡回グラフ(DAG)として見ることができますが、以下の手順に従って、この表を家系図として表すためにグラフ描画を使用します。
{{ % step %}}
-
必要なライブラリをインポートしてデータを読み取る
import pandas as pd import numpy as np from graphviz import Digraph.csvファイルからデータを読み取るためにpandasライブラリをインポートし、データを操作するためにデータ フレームを使用します。 次に、numpyとgraphvizをインポートして、それぞれ配列を操作し、直接非巡回グラフ (DAG) を生成します。 -
データの読み取り
rawdf = pd.read_csv("./data.csv", keep_default_na=False)read_csv()メソッドはdata.csvファイルを読み取るために使用され、keep_default_na=FalseはNaNの代わりに空白のセルを保持するために使用されます。 -
テーブルをエッジ リストに変換する
次に、次のコードを実行して、開始頂点が
idであり、終了頂点がParentIDであるエッジ リストにテーブルを変換する必要があります。2つのデータ フレームを作成します。
element1 = rawdf[["id", "mid"]]
element2 = rawdf[["id", "fid"]]

print(
    "'element1' head data:\n",
    element1.head(),
    "\n\n",
    "'element2' head data: \n",
    element2.head(),
)
出力:
'element1' head data:
	  id   mid
0    AnAn
1    SiAn
2 PaAn87 SiAn
3 ViCo92 SiAn
4 CaCo97

'element2' head data:
	  id   fid
0    AnAn
1    SiAn
2 PaAn87 AnAn
3 ViCo92 AnAn
4 CaCo97
ここでは、2つの新しいデータフレーム、
element1とelement2を作成します。element1データフレームには2つの列、idとmidがあり、element2データフレームにはidとfidが列として含まれています。列名の名前を変更します。
element1.columns = ["Child", "ParentID"]
element2.columns = element1.columns

print(
    "'element1' data:\n",
    element1.head(),
    "\n\n",
    "'element2' data: \n",
    element2.head(),
)
出力:
'element1' data:
   Child ParentID
0    AnAn
1    SiAn
2 PaAn87     SiAn
3 ViCo92     SiAn
4 CaCo97

'element2' data:
   Child ParentID
0    AnAn
1    SiAn
2 PaAn87     AnAn
3 ViCo92     AnAn
4 CaCo97
上記のコード スニペットは、上記の出力に示すように、
element1およびelement2データ フレームの列名をChildおよびParentIDに変更します。データ フレームを連結し、空白セルを
NaNに置き換えます。element = pd.concat([element1, element2]) element.replace("", np.nan, regex=True, inplace=True) print(element.head())出力:
Child ParentID 0 AnAn NaN 1 SiAn NaN 2 PaAn87 SiAn 3 ViCo92 SiAn 4 CaCo97 NaNconcat()メソッドはelement1とelement2データ フレームを連結してelementと呼ばれる新しいデータ フレームを作成するために使用され、replace()メソッドは空白セルをNaNに置き換えます。ParentIDの各空白を特定の文字列に置き換えます。t = pd.DataFrame({"tmp": ["no_entry" + str(i) for i in range(element.shape[0])]}) element["ParentID"].fillna(t["tmp"], inplace=True)データ フレームの結合:
df = element.merge(rawdf, left_index=True, right_index=True, how="left") print(df.head())出力:
Child ParentID id gender first_name last_name dob dod fid \ 0 AnAn no_entry0 AnAn M Antonio Andolini 1901 0 AnAn no_entry0 AnAn M Antonio Andolini 1901 1 SiAn no_entry1 SiAn F Signora Andolini 1901 1 SiAn no_entry1 SiAn F Signora Andolini 1901 2 PaAn87 SiAn PaAn87 M Paolo Andolini 1887 1901 AnAn mid birth_place job 0 Corleone 0 Corleone 1 Corleone housewife 1 Corleone housewife 2 SiAnここでは、
merge()を使用して、指定されたメソッドを使用して 2つのデータ フレームのデータを更新し、それらをマージします。 特定のパラメーターを使用して、どのデータ値を置き換え、どのデータ値を保持するかを制御します。そのために、以下で簡単に説明する次のパラメータを使用しています。
rawdf- マージに必要なデータ フレーム。left_index- その値に基づいて、左データ フレームのインデックスを結合キーとして使用するかどうかを決定できます。
Trueに設定されている場合は、それを使用できます。 そうでなければ、そうではありません。 デフォルトでは、その値はFalseです。right_index-left_indexに似ていますが、ここでは、右のデータ フレームのインデックスを結合キーとして使用できるかどうかを決定する必要があります。
Trueに設定されている場合は、それを使用できます。 そうでなければ、そうではありません。 デフォルトでは、その値もFalseです。how-left、outer、right、cross、またはinnerをマージする方法を示します。 デフォルトでは、その値はinnerです。
フルネームを持つ
name列を作成します。df["name"] = df[df.columns[4:6]].apply( lambda x: " ".join(x.dropna().astype(str)), axis=1 ) print(df.head())出力:
Child ParentID id gender first_name last_name dob dod fid \ 0 AnAn no_entry0 AnAn M Antonio Andolini 1901 0 AnAn no_entry0 AnAn M Antonio Andolini 1901 1 SiAn no_entry1 SiAn F Signora Andolini 1901 1 SiAn no_entry1 SiAn F Signora Andolini 1901 2 PaAn87 SiAn PaAn87 M Paolo Andolini 1887 1901 AnAn mid birth_place job name 0 Corleone Antonio Andolini 0 Corleone Antonio Andolini 1 Corleone housewife Signora Andolini 1 Corleone housewife Signora Andolini 2 SiAn Paolo Andoliniここでは、
lambda式を使用して各行を反復し、first_nameとlast_nameを結合します。 次に、上記の出力に見られるように、この完全な名前をnameという新しい列に配置します。いくつかの列を削除し、
dfデータ フレームの列の順序を変更します。df = df.drop(["Child", "fid", "mid", "first_name", "last_name"], axis=1) df = df[["id", "name", "gender", "dob", "dod", "birth_place", "job", "ParentID"]] print(df.head())出力:
id name gender dob dod birth_place job ParentID 0 AnAn Antonio Andolini M 1901 Corleone no_entry0 0 AnAn Antonio Andolini M 1901 Corleone no_entry0 1 SiAn Signora Andolini F 1901 Corleone housewife no_entry1 1 SiAn Signora Andolini F 1901 Corleone housewife no_entry1 2 PaAn87 Paolo Andolini M 1887 1901 SiAn最初に、
Child、fid、mid、first_name、およびlast_name列をdfデータ フレームから削除し、結果のデータ フレームでわかるように、列の順序を変更します。 -
直接非巡回グラフ (DAG) を生成する
DAG を生成するには、システムに
graphvizが必要です。f = Digraph( "neato", format="pdf", encoding="utf8", filename="data", node_attr={"color": "lightblue2", "style": "filled"}, ) f.attr("node", shape="box") for index, record in df.iterrows(): f.edge(str(record["ParentID"]), str(record["id"]), label="") f.view()このコード スニペットは、
graphvizのDigraph()クラスを使用します。このクラスは、いくつかの属性を取り、DOT 言語で有向グラフの記述を作成します。この参照を.attr( でチェーンされたf変数に保存します。 )メソッドを使用してノードの形状を指定します。最後に、
dfデータ フレームを反復処理してエッジを作成し、f.view()を使用してグラフを表示します。出力:
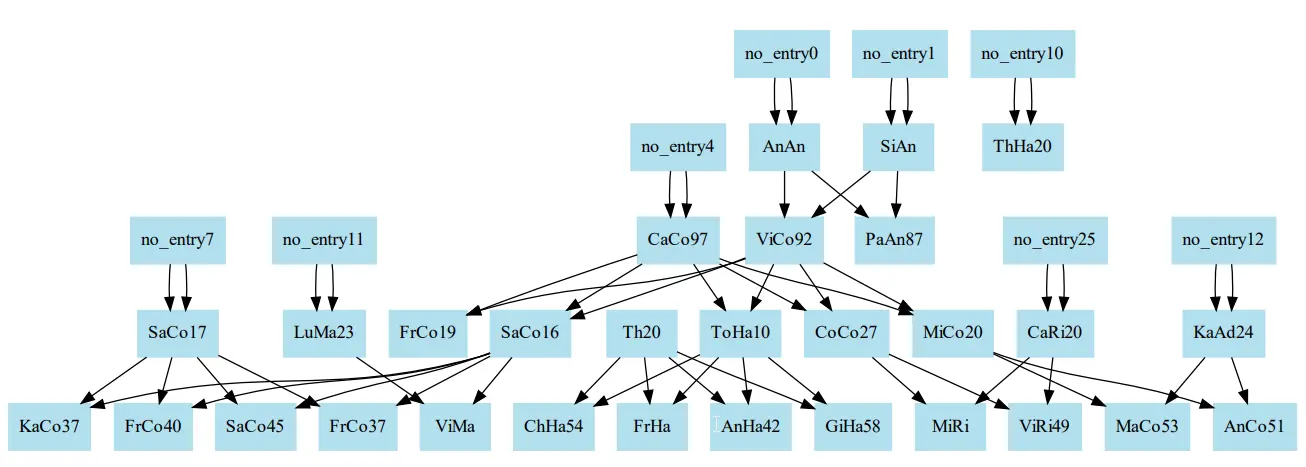
グラフに次のものを入れたいとします。
- 女性用の色と男性用の別の色。
2.名前をIDに置き換える - 家系図の矢のような矢
- 各ボックス (ノード) に詳細を追加するには、たとえば
job、dob、dodなど。
これを行うには、次のコードを実行します。
f = Digraph( "neato", format="jpg", encoding="utf8", filename="detailed_data", node_attr={"style": "filled"}, graph_attr={"concentrate": "true", "splines": "ortho"}, ) f.attr("node", shape="box") for index, row in df.iterrows(): f.node( row["id"], label=row["name"] + "\n" + row["job"] + "\n" + str(row["dob"]) + "\n" + row["birth_place"] + "\n" + str(row["dod"]), _attributes={ "color": "lightpink" if row["gender"] == "F" else "lightblue" if row["gender"] == "M" else "lightgray" }, ) for index, row in df.iterrows(): f.edge(str(row["ParentID"]), str(row["id"]), label="") f.view()出力:
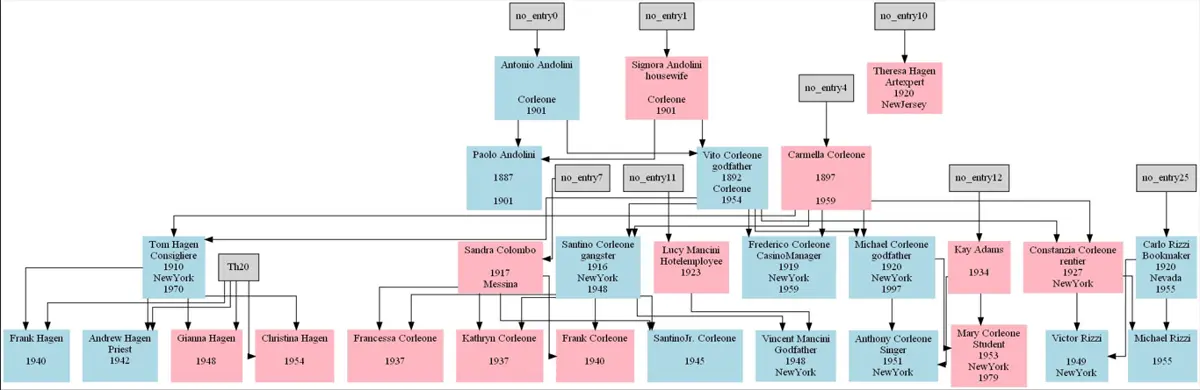
graph_attr={"concentrate": "true", "splines": "ortho"})を使用して、正確な開始ノードと終了ノード、および正方形のエッジでエッジをグループ化します。label=は、グラフ ノードのname、job、dob、birth_place、およびdodを表示するために使用されます。_attributes={'color':'lightpink' if row['S']=='F' else 'lightblue' if row['S']=='M' else 'lightgray'}を定義するために使用されますgenderプロパティに応じた各ノードの色。 以下の完全なソースコードを見つけることができます。 - 女性用の色と男性用の別の色。
{{ % /step %}}
完全なソース コード:
import pandas as pd
import numpy as np
from graphviz import Digraph
rawdf = pd.read_csv("./data.csv", keep_default_na=False)
element1 = rawdf[["id", "mid"]]
element2 = rawdf[["id", "fid"]]
element1.columns = ["Child", "ParentID"]
element2.columns = element1.columns
element = pd.concat([element1, element2])
element.replace("", np.nan, regex=True, inplace=True)
t = pd.DataFrame({"tmp": ["no_entry" + str(i) for i in range(element.shape[0])]})
element["ParentID"].fillna(t["tmp"], inplace=True)
df = element.merge(rawdf, left_index=True, right_index=True, how="left")
df["name"] = df[df.columns[4:6]].apply(
lambda x: " ".join(x.dropna().astype(str)), axis=1
)
df = df.drop(["Child", "fid", "mid", "first_name", "last_name"], axis=1)
df = df[["id", "name", "gender", "dob", "dod", "birth_place", "job", "ParentID"]]
f = Digraph(
    "neato",
    format="pdf",
    encoding="utf8",
    filename="data",
    node_attr={"color": "lightblue2", "style": "filled"},
)
f.attr("node", shape="box")
for index, record in df.iterrows():
    f.edge(str(record["ParentID"]), str(record["id"]), label="")
f.view()
f = Digraph(
    "neato",
    format="jpg",
    encoding="utf8",
    filename="detailed_data",
    node_attr={"style": "filled"},
    graph_attr={"concentrate": "true", "splines": "ortho"},
)
f.attr("node", shape="box")

for index, row in df.iterrows():
    f.node(
        row["id"],
        label=row["name"]
        + "\n"
        + row["job"]
        + "\n"
        + str(row["dob"])
        + "\n"
        + row["birth_place"]
        + "\n"
        + str(row["dod"]),
        _attributes={
            "color": "lightpink"
            if row["gender"] == "F"
            else "lightblue"
            if row["gender"] == "M"
            else "lightgray"
        },
    )

for index, row in df.iterrows():
    f.edge(str(row["ParentID"]), str(row["id"]), label="")
f.view()
