API · SciPy
SciPy stats.skew Funktion
In diesem Tutorial wird erklärt, was die Funktion stats.skew mit Hilfe des Scipy-Moduls in Python ist
Auf dieser Seite
Schiefe in der Statistik wird als Maß für die Symmetrie der Verteilung einiger Daten definiert. Der Punkt, der sich an der Spitze der gesamten Verteilung befindet, wird als Modus bezeichnet. Die Schiefe wird durch die folgende Formel berechnet.
Skewness = 3(Mean - Median) / Standard Deviation
Bedingungen der Schiefe:
- Bei
skewness = 0sind die Daten normalverteilt. - Wenn
skewness > 0, dann werden die Daten auf der linken Seite der Verteilung stärker gewichtet. - Wenn
skewness < 0, dann werden die Daten auf der rechten Seite der Verteilung stärker gewichtet.
Die scipy.stats.skew-Funktion
Die Funktion scipy.stats.skew der Bibliothek SciPy wird verwendet, um den Wert der Schiefe von gegebenen Daten zu bestimmen. Diese Funktion ist definiert als scipy.stats.skew(a, axis, bias, nan_policy).
Nachfolgend sind die Parameter der Funktion scipy.stats.skew aufgeführt.
a (ndarray) |
Es definiert das Eingabearray, dh die Eingabedaten. |
axis (int) |
Sie definiert die Achse, entlang der die Funktion den Wert Schiefe berechnet. Der Standardwert ist 0, d.h. die Funktion rechnet über das ganze Array. |
bais (bool) |
Wenn der Wert dieses Parameters auf False gesetzt ist, werden alle Berechnungen um die statistische Verzerrung korrigiert. |
nan_policy |
Es entscheidet, wie mit NaN-Werten in den Eingabedaten umgegangen wird. Im Parameter gibt es drei Entscheidungsparameter, propagate, raise, omit. propagate gibt einfach den NaN-Wert zurück, raise gibt einen Fehler zurück und omit ignoriert einfach die NaN-Werte und die Funktion fährt mit der Berechnung fort. Diese Entscheidungsparameter werden in einfachen Anführungszeichen ' ' definiert. Außerdem ist die Voreinstellung auf propagate gesetzt. |
Alle Parameter außer dem Parameter a (ndarray) sind optional. Das bedeutet, dass sie nicht jedes Mal neu definiert werden müssen, wenn die Funktion scipy.stats.skew verwendet wird.
Schiefe berechnen mit numpy.linspace()
Die Funktion linespace() der Bibliothek NumPy hilft beim Erstellen zufälliger Zahlenfolgen mit gleichen Abständen.
from scipy.stats import skew
import numpy as np
import pylab as p

x = np.linspace(-10, 10, 1000)
y = 1 / (np.sqrt(4 * np.pi)) * np.exp(-0.2 * (x) ** 2)

p.plot(x, y, ".")
p.show()

print("Skewness for the input data : ", skew(y))
Ausgabe:
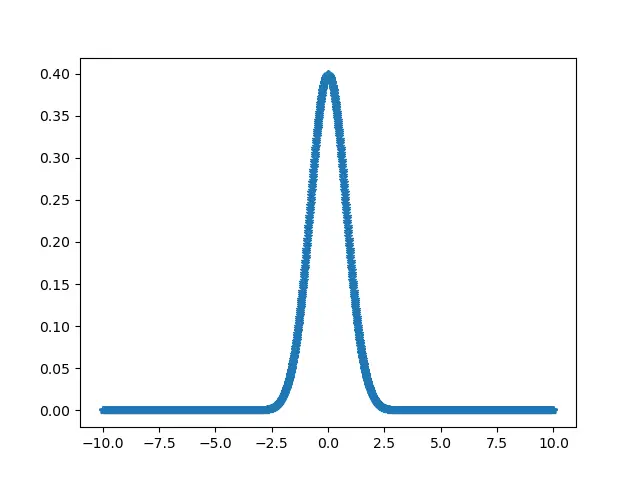
Skewness for the input data : 1.458658437437705
Berechnung der Schiefe mit Zufallsdaten
Bei dieser Methode wird die Funktion np.random.normal der Bibliothek NumPy verwendet. Diese Funktion hilft beim Erstellen eines Arrays mit einer bestimmten Form und Größe, das aus zufälligen Werten besteht, die tatsächlich Teil der Gaußschen Verteilung sind.
from scipy.stats import skew
import numpy as np

s = np.random.normal(0, 5, 10000)

print("S : ", s)

print("Skewness for input data : ", skew(s))
S :  [ 2.52232305  5.66398738  2.72036031 ...  0.53774684 -0.31164153
  1.99714612]
Skewness for input data :  0.0027004583356120505