
HOWTO · Python
在 Python 中解析 HTML 資料
本文解釋了在 Python 中解析 HTML 資料的不同方法。我們將研究有助於我們解析 HTML 格式資料的不同 Python 函式或模組。
本頁內容
通過網路瀏覽器的出現,網路上的資料被廣泛地吸收和用於各種目的。但是,這種 HTML 資料很難以原始方式以程式設計方式注入。
我們需要一些媒介來解析 HTML 指令碼,以便以程式設計方式使用。本文將提供我們可以通過 Python 方法/庫快速解析 HTML 資料的各種方法。
在 Python 中使用 BeautifulSoup 模組解析 HTML 資料
Python 提供了 BeautifulSoup 模組來解析和提取 HTML 和 XML 檔案中的基本資料。
這可以幫助每個程式設計師在檔案結構中導航以從 HTML 或標記結構中以可讀格式解析和獲取資料,從而為每個程式設計師節省時間。
BeautifulSoup 模組接受 HTML 資料/檔案或網頁 URL 作為輸入,並使用模組中可用的自定義函式返回請求的資料。
讓我們通過下面的例子來看看 BeautifulSoup 提供的一些功能。我們將解析下面的 HTML 檔案 (example.html) 以提取一些資料。
<html>
<head>
    <title>Heading 1111</title>
</head>

<body>
    <p class="title"><b>Body</b></p>
    <p class="Information">Introduction
        <a href="http://demo.com" id="sync01">Amazing info!!</a>
    <p> Stay tuned!!</p>
</body>
</html>
要使用 BeautifulSoup 模組中可用的功能,我們需要使用以下命令安裝它。
pip install beautifulsoup4
完成後,我們將 HTML 檔案 (example.html) 傳遞給模組,如下所示。
from bs4 import BeautifulSoup

with open("example.html") as obj:
    data = BeautifulSoup(obj, "html.parser")
BeautifulSoup() 函式通過 HTML.parser 導航器建立一個指向 HTML 檔案的物件/指標。我們現在可以使用指標 data(如上面的程式碼所示)來遍歷網站或 HTML 檔案。
讓我們通過下圖瞭解 HTML 標籤元件分解。
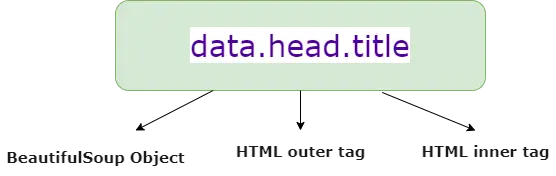
我們使用 object.html_outer_tag.html_inner_tag 從整個指令碼或網頁中提取特定 HTML 標記內的資料。使用 BeautifulSoup 模組,我們甚至可以針對單獨的 HTML 標籤獲取資料,例如標題、div、p 等。
讓我們嘗試以完整的程式碼格式針對不同的 HTML 標籤提取資料。
from bs4 import BeautifulSoup

with open("example.html") as obj:
    data = BeautifulSoup(obj, "html.parser")
    print(data.head.title)
    print(data.body.a.text)
我們嘗試使用上面的程式碼提取包裹在 <head> 周圍的 <title> 標籤內的資料作為外部標籤。因此,我們將 BeautifulSoup 物件指向該標籤。
我們還可以通過將 BeautifulSoup 物件指向其文字部分來提取與 <a> 標記關聯的文字。
輸出:
Heading 1111
Amazing info!!
讓我們參考下面的例子來理解通過 BeautifulSoup 物件解析 <div> 等 HTML 標籤。
參考下面的 HTML 程式碼。
<html>
<head>Heading 0000</head>
<body>
    <div>Data</div>
</body>
</html>
如果我們希望顯示或提取標籤 <div> 的資訊,我們需要制定程式碼以幫助 BeautifulSoup 物件指向該特定標籤以進行資料解析。
from bs4 import BeautifulSoup

with open("example.html") as obj:
    data = BeautifulSoup(obj, "html.parser")
    print(data.body.div)
輸出:
<div>Data</div>
因此,我們可以直接使用該模組抓取網頁。它通過 web/HTML/XML 頁面與資料互動,並根據標籤獲取必要的定製資料。
在 Python 中使用 PyQuery 模組解析 HTML 資料
Python PyQuery 模組是一個 jQuery 庫,它使我們能夠針對 XML 或 HTML 文件觸發 jQuery 函式,從而輕鬆地解析 XML 或 HTML 指令碼以提取有意義的資料。
要使用 PyQuery,我們需要使用以下命令安裝它。
pip install pyquery
pyquery 模組為我們提供了一個 PyQuery 函式,它使我們能夠設定指向 HTML 程式碼的指標以進行資料提取。它接受 HTML 片段/檔案作為輸入並將指標物件返回到該檔案。
該物件還可用於指向要解析其內容/文字的確切 HTML 標記。參考下面的 HTML 片段(demo.html)。
<html>
<head>Heading 0000</head>
<body>
    <div>Data</div>
</body>
</html>
然後我們從 pyquery 模組中匯入 PyQuery 函式。使用 PyQuery 函式,我們將物件指向可讀格式的 demo.html 檔案。
然後,object('html_tag').text() 使我們能夠提取與任何 HTML 標籤關聯的文字。
from pyquery import PyQuery

data_html = open("demo.html", "r").read()
obj = PyQuery(data_html)
print(obj("head").text())
print(obj("div").text())
obj('head') 函式指向 HTML 指令碼的 <head> 標籤,text() 函式使我們能夠檢索繫結到該標籤的資料。
同樣,使用 obj('div').text(),我們提取繫結到 <div> 標籤的文字資料。
輸出:
Heading 0000
Data
在 Python 中使用 lxml 庫解析 HTML 資料
Python 為我們提供了一個 lxml.html 模組來有效地解析和處理 HTML 資料。BeautifulSoup 模組也執行 HTML 解析,但在抓取網頁時處理複雜的 HTML 指令碼時效率較低。
使用 lxml.html 模組,我們可以解析 HTML 資料並使用 parse() 函式針對特定的 HTML 標籤提取資料值。此函式接受 Web URL 或 HTML 檔案作為輸入,並將指向 HTML 指令碼根元素的指標與 getroot() 函式相關聯。
然後我們可以使用與 cssselect(html_tag) 函式相同的指標來顯示由傳遞的 HTML 標記繫結的內容。我們將通過 lxml.html 模組解析下面的 HTML 指令碼。
<html>
<head>Heading 0000</head>
<body>
    <a>Information 00</a>
    <div>Data</div>
    <a>Information 01</a>
</body>
</html>
讓我們看一下下面的 Python 程式碼片段。
from lxml.html import parse

info = parse("example.html").getroot()
for x in info.cssselect("div"):
    print(x.text_content())
for x in info.cssselect("a"):
    print(x.text_content())
在這裡,我們通過 parse() 函式將物件 info 與 HTML 指令碼 (example.html) 關聯起來。此外,我們使用 cssselect() 函式來顯示與 HTML 指令碼的 <div> 和 <a> 標籤繫結的內容。
它顯示了由 <a> 和 div 標籤包圍的所有資料。
輸出:
Data
Information 00
Information 01
在 Python 中使用 justext 庫解析 HTML 資料
Python justext 模組讓我們從 HTML 指令碼中提取更簡化的文字形式。它可以幫助我們從 HTML 指令碼、頁首、頁尾、導航連結等中消除不必要的內容。
使用 justext 模組,我們可以輕鬆提取適合生成語言資料來源的成熟文字/句子。justext() 函式接受 Web URL 作為輸入,以 HTML 指令碼的內容為目標,並從中提取英文語句/段落/文字。
參考下面的例子。
我們使用 requests.get() 函式對傳遞給它的 Web URL 進行 GET 呼叫。一旦我們將指標指向網頁,我們就使用 justext() 函式來解析 HTML 資料。
justext() 函式接受網頁指標變數作為引數,並將其與 content 函式一起存放以獲取網頁內容。
此外,它使用 get_stoplist() 函式來查詢特定語言的句子以進行解析(英語,在下面的示例中)。
import requests
import justext

link = requests.get("http://www.google.com")
data = justext.justext(link.content, justext.get_stoplist("English"))
for x in data:
    print(x.text)
輸出:
Search Images Maps Play YouTube News Gmail Drive More `
Web History | Settings | Sign in
Advanced search
Google offered in: हिन्दीবাংলাతెలుగుमराठीதமிழ்ગુજરાતીಕನ್ನಡമലയാളംਪੰਜਾਬੀ
Advertising Programs Business Solutions About Google Google.co.in
© 2022 - Privacy - Terms
在 Python 中使用 EHP 模組解析 HTML 資料
在探索了用於解析 HTML 資料的不同 Python 模組之後,諸如 BeautifulSoup 和 PyQuery 之類的奇特模組無法有效地處理龐大或複雜的 HTML 指令碼。要處理損壞或複雜的 HTML 指令碼,我們可以使用 Python EHP 模組。
這個模組的學習曲線非常簡單,很容易適應。EHP 模組為我們提供了 Html() 函式,它生成一個指標物件並接受 HTML 指令碼作為輸入。
為此,我們使用 feed() 函式將 HTML 資料提供給 Html() 函式以進行識別和處理。最後,find() 方法使我們能夠解析和提取與作為引數傳遞給它的特定標籤相關的資料。
看看下面的例子。
from ehp import *

script = """<html>
<head>Heading</head>
<body>
    <div>
        Hello!!!!
    </div>
</body>
</html>
"""

obj = Html()
x = obj.feed(script)
for i in x.find("div"):
    print(i.text())
在這裡,我們在 script 變數中有 HTML 指令碼。我們通過物件解析在內部使用 feed() 函式將 HTML 指令碼提供給 Html() 方法。
然後,我們嘗試解析 HTML 資料並使用 find() 方法針對 <div> 標記獲取資料。
輸出:
Hello!!!!
まとめ
本教程討論了使用各種 Python 內建模組/庫解析 HTML 資料的不同方法。我們還看到了實際示例的實際實現,以瞭解 Python 中 HTML 資料解析的過程。