
HOWTO · Pandas
Pandas에서 함수 벡터화
이 튜토리얼은 pandas에서 함수를 벡터화하는 방법을 보여줍니다.
이 페이지의 내용
벡터화는 함수를 보다 효율적으로 평가하는 형식으로 변환하는 방법입니다. 데이터를 배열로 변환하여 Python에서 데이터 처리 속도를 높입니다. 루프를 사용하지 않고 Python 코드의 속도를 높입니다.
Pandas 라이브러리는 Python에서 데이터 분석 및 조작을 위한 인기 있는 도구입니다. 코드 성능을 향상시키기 위해 Pandas의 벡터화를 일반적으로 수치 계산에 사용합니다.
Pandas 데이터 프레임은 데이터 프레임 위에 구축된 데이터 구조로, R 데이터 프레임과 Python 사전의 기능을 모두 제공합니다. Python 사전과 비슷하지만 Excel 테이블 및 행과 열이 있는 데이터베이스와 같은 모든 데이터 분석 및 조작 기능이 있습니다.
Pandas에서 함수 벡터화
데이터 프레임을 가져오기 위해 Python 라이브러리 pandas를 설치해 보겠습니다.
PS C:\> pip install pandas
데이터 프레임에서 벡터화를 수행하기 위해 Python 라이브러리 pandas를 사용하여 이를 가져옵니다. 아래 코드를 실행하여 데이터 프레임을 가져오고 연결을 통해 크게 만들어 봅시다.
예제 코드(demo.py에 저장됨):
import pandas as pd

small_df = pd.read_csv("Salaries.csv")
df = pd.concat([small_df] * 100, ignore_index=True)
이제 아래 코드를 실행하여 데이터 분석을 위한 데이터 프레임의 총 행 수를 계산합니다.
예제 코드(demo.py에 저장됨):
print(f"No of rows: {len(df)}")
OUTPUT(콘솔에 인쇄됨):
No of rows: 14865400
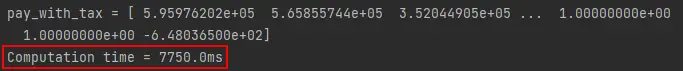
아래 코드를 실행하여 벡터화 없이 데이터 프레임에 수행된 작업의 소비 시간을 살펴보겠습니다.
예제 코드(demo.py에 저장됨):
import time
import numpy

start_time = time.process_time()
pay_with_tax = np.zeros(len(df))
for idx, pay in enumerate(df.TotalPay.values):
    pay_with_tax[idx] = pay * 1.05 + 1
end_time = time.process_time()

print("Without using Vectorization")
print(f"pay_with_tax = {pay_with_tax}")
print(f"Computation time = {(1000*(end_time - start_time ))}ms")
함수 np.zeros()는 크기를 len(df)로 사용하고 지정된 크기의 0 배열을 생성합니다. for 루프는 데이터의 pay_with_tax 배열과 TotalPay 열 모두를 반복합니다. 지불로 프레임.
각 pay에 대한 세금을 계산하고 pay_with_tax에 저장합니다.
OUTPUT(콘솔에 인쇄됨):
벡터화는 SIMD(Single Instruction Multiple Data) 접근 방식을 사용하여 작업에 유연성을 추가합니다. Pandas에서 배치 API는 루프를 사용하지 않고 작업 속도를 높입니다.
salary_with_tax를 계산할 때 소요되는 시간을 계산하기 위해 벡터화를 사용하는 아래 코드를 실행해 봅시다.
예제 코드(demo.py에 저장됨):
start_time = time.process_time()
pay_with_tax = df.TotalPay.values * 1.05 + 1
end_time = time.process_time()

print("Using Vectorization")
print(f"pay_with_tax = {pay_with_tax}")
print(f"Computation time = {(1000*(end_time - start_time ))}ms")
OUTPUT(콘솔에 인쇄됨):

또한 위의 코드에 약간의 변경을 추가하여 mean, sqrt 등과 같은 numpy 라이브러리의 통계 연산을 적용할 수도 있습니다.
예제 코드(demo.py에 저장됨):
import numpy as np

# non vectorized
for idx, pay in enumerate(df.TotalPay.values):
    pay_with_tax[idx] = np.mean(pay)

# vectorized
pay_with_tax = df["TotalPay"].apply(np.mean)
벡터화가 있든 없든 시간 소비의 차이를 볼 수 있습니다. 산업은 수백만에서 수조 개의 빅 데이터 행을 처리합니다.
벡터화되지 않은 접근 방식으로 이 데이터를 계산하는 데는 시간이 많이 걸립니다. 따라서 Pandas 데이터 프레임의 유연한 벡터화 특성은 빠른 데이터 분석 및 조작에 도움이 됩니다.