HOWTO · C++
C++에서 가장 긴 공통 하위 문자열 찾기
이 기사에서는 C++에서 동적 프로그래밍을 사용하여 가장 긴 공통 하위 문자열 문제와 그 솔루션을 설명합니다.
이 기사에서는 C++에서 동적 프로그래밍을 사용하여 가장 긴 공통 하위 문자열 문제와 그 솔루션에 대해 설명합니다.
가장 긴 공통 하위 문자열
LCS(Longest Common Substring)는 컴퓨터 과학에서 잘 알려진 문제입니다. 둘 이상의 문자열에서 최대 길이 부분 문자열은 가장 긴 공통 부분 문자열입니다.
예를 들어 다음 세 문자열을 고려하십시오.
XYXYZYXYZXXYZYX
이 세 문자열의 가장 긴 공통 하위 문자열은 XYZ입니다. X, XY, Y, YX, YZ 및 Z와 같은 다른 일반적인 하위 문자열이 이 세 문자열에 존재합니다. 그러나 가장 긴 공통 하위 문자열은 XYZ뿐입니다.
그림 1은 위의 세 문자열 중 가장 긴 공통 하위 문자열을 보여줍니다.
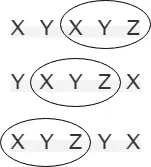
가장 긴 공통 하위 문자열의 문제 공식화
최대 길이를 갖는 S1과 S2에서 정확한 하위 문자열을 찾기 위해 각각 길이가 m과 n인 두 문자열 S1과 S2를 고려하십시오.
이 문제에 대한 두 가지 솔루션을 제시합니다.
- 간단한 솔루션
- 동적 프로그래밍 솔루션
간단한 솔루션
다음은 간단한 솔루션을 사용하여 두 문자열에서 가장 긴 공통 하위 문자열을 찾는 단계입니다.
-
첫 번째 문자열
S1의 모든 하위 문자열을 찾습니다. -
S1의 모든 하위 문자열에 대해S2의 하위 문자열인지 여부를 확인합니다. -
최대 길이 하위 문자열은
S2하위 문자열과 일치합니다. -
문자열
S1의 길이가m이므로 $\mathcal{O}(m^2)$ 하위 문자열이 있습니다. -
문자열
S2의 길이는n이며 문자열이 하위 문자열인지 여부를 확인하려면 $\mathcal{O}(n)$가 필요합니다. -
이 솔루션을 수행하는 데 필요한 총 시간 복잡도는 $\mathcal{O}(nm^2)$입니다.
이 솔루션은 가장 긴 공통 하위 문자열을 찾을 수 있습니다. 그러나 시간이 걸리므로 더 짧은 시간에 동일한 목표를 달성하기 위한 동적 프로그래밍 솔루션을 살펴보겠습니다.
동적 프로그래밍을 통해 가장 긴 공통 하위 문자열 찾기
DP(동적 프로그래밍)를 사용하여 두 문자열에서 가장 긴 공통 하위 문자열(LCS)을 찾을 수 있습니다. 다음은 동적 프로그래밍 방식을 사용하여 가장 긴 공통 하위 문자열을 찾기 위한 의사 코드입니다.
function Longest_Common_Substring(S1[1..m], S2[1..n])
    DP_Matrix = array(1..m, 1..n)
    len = 0
    result_substring = {}
    for i = 1..m
        for j = 1..n
            if S1[i] == S2[j]
                if i = 1 or j = 1
                    DP_Matrix[i, j] = 1
                else
                    DP_Matrix[i, j] = DP_Matrix[i − 1, j − 1] + 1
                if DP_Matrix[i, j] > len
                    len = DP_Matrix[i, j]
                    result_substring = {S1[i − len + 1..i]}
                else if DP_Matrix[i, j] == len
                    result_substring = result_substring ∪ {S1[i − len + 1..i]}
            else
                DP_Matrix[i, j] = 0
    return result_substring
위의 솔루션은 가장 긴 공통 하위 문자열을 계산하기 위해 2차(즉, $\mathcal{O}(mn)$) 시간 복잡도를 사용합니다. 이 솔루션은 최적이며 항상 가장 긴 하위 일치를 보장합니다.
참고: 의사 코드의 배열은 인덱스 1부터 시작합니다. 또한 이 알고리즘은 비어 있지 않은 문자열에서만 제대로 작동합니다.
DP_Matrix는 종료 위치 S1[i]가 있는 접두사 S1[1..i]및S2[1..j]의 하위 문자열 길이를 저장하기 위해 동적 프로그래밍 테이블로 사용되는 2D 배열 또는 행렬입니다. ] 및 S2[j].
변수 len은 지금까지 발견된 현재 가장 큰 result_substring 길이를 저장하는 데 사용됩니다. 하위 문자열은 len 길이의 문자열을 저장하는 데 사용됩니다.
DP_matrix의 첫 번째 행과 열에 있는 모든 셀은 1로 초기화됩니다. 나머지 셀을 계산하는 데 목적 함수가 사용됩니다.
이 공식의 목적 함수는 다음과 같이 나타낼 수 있습니다.
- 주어진 셀
DP_Matrix[i,j]에 대해 주어진 문자열 시퀀스의 해당 문자(즉,S1[i]및S2[j]의 문자)가 일치하는 경우1을 추가합니다.셀DP_Matrix[i-1,j-1]의 값으로.DP_Matrix[i,j]셀의 업데이트된 값이 하위 문자열의 이전 길이보다 크면 이 새 값으로len을 업데이트합니다.- 동시에 이 새로운 최대 문자열을 보조 문자열 홀더(예:
result_substring)에 저장합니다.
- 해당 문자가 일치하지 않는 경우(즉, 불일치 사례) 셀
DP_Matrix[i, j]를 0 값으로 설정하여 여기에서 새 하위 문자열만 시작할 수 있음을 나타냅니다.
모든 M*N 반복(즉, for 루프의 끝) 후에 result_substring은 최적으로 가장 큰 공통 하위 문자열을 갖게 됩니다.
C++에서 가장 긴 공통 하위 문자열 동적 프로그래밍 솔루션
다음 코드는 C++에서 동적 프로그래밍을 사용하여 문자열에서 가장 긴 공통 하위 문자열을 찾는 데 사용됩니다.
#include <iostream>
#include <string>
using namespace std;

string Longest_Common_Substring(string Str1, string Str2) {
  string result_substring = "";
  int m = Str1.length();
  int n = Str2.length();
  int DP_Matrix[m + 1][n + 1];
  int len = 0;
  int end = 0;

  for (int i = 0; i <= m; i++) {
    for (int j = 0; j <= n; j++) {
      if (Str1[i] == Str2[j]) {
        if ((i == 0) || (j == 0))
          DP_Matrix[i][j] = 1;
        else
          DP_Matrix[i][j] = 1 + DP_Matrix[i - 1][j - 1];

        if (DP_Matrix[i][j] > len) {
          len = DP_Matrix[i][j];
          int start = i - DP_Matrix[i][j] + 1;
          if (end == start) {
            result_substring.push_back(Str1[i]);
          } else {
            end = start;
            result_substring.clear();
            result_substring.append(Str1.substr(end, (i + 1) - end));
          }
        }
      } else {
        DP_Matrix[i][j] = 0;
      }
    }
  }
  return result_substring;
}

int main() {
  string String1, String2;
  cout << "Enter the first string: ";
  cin >> String1;
  cout << "Enter the second string: ";
  cin >> String2;
  string substring = Longest_Common_Substring(String1, String2);
  cout << "LCS of " << String1 << " and " << String2 << " is " << substring
       << " of Length " << substring.length() << endl;
  return 0;
}
위의 코드에는 Longest_Common_Substring 함수가 포함되어 있습니다. 이 함수는 두 개의 문자열(즉, String1 및 String2)을 매개변수로 받아들이고 최적의 가장 큰 공통 하위 문자열을 반환합니다. Longest_Common_Substring 기능은 동적 프로그래밍 테이블 방법을 사용하여 이 LCS를 찾습니다.
위의 코드에서 DP_Matrix는 문자열 하위 쌍 S1[1..i] 및 S2[1..j]에 대한 현재 최상의 하위 문자열 길이를 저장하는 2D 정수 배열입니다. 의사 코드 설명에서 설명한 result_substring은 찾은 가장 긴 하위 문자열을 저장하는 데 사용됩니다.
다른 문자열 쌍에 대한 위 코드의 출력을 살펴보겠습니다.
출력 1:
Enter the first string: ATGCACATA
Enter the second string: GCAATGCACT
LCS of ATGCACATA and GCAATGCACT is ATGCAC of Length 6
출력 2:
Enter the first string: ABCDDFA
Enter the second string: DCDDACDDF
LCS of ABCDDFA and DCDDACDDF is CDDF of Length 4
이론적 또는 수학적 증명 외에도 위의 출력은 논의된 동적 프로그래밍 솔루션이 최적임을 시사합니다.