
HOWTO · Linux
Lire les drapeaux du processeur à partir de Cpuinfo
Cet article décrit les drapeaux dans cpuinfo sous Linux.
Sur cette page
Linux expose des informations sur le processeur dans /proc/cpuinfo. Vous pouvez les afficher, repérer les indicateurs CPU signalés et vous appuyer sur quelques exemples pour comprendre ce que le système rapporte. Les champs et les noms d’indicateurs exacts dépendent du processeur, de l’architecture, du noyau et de l’exécution éventuelle de Linux dans une machine virtuelle.
Lire /proc/cpuinfo
Exécutez cet exemple :
Le code et les libellés ou sorties affichés dans cette section restent en anglais.
cat /proc/cpuinfo
Cette commande affiche le fichier sous forme de texte sélectionnable dans un terminal. L’exécution fournie a réussi sur un autre système ; le résultat varie d’un système à l’autre. L’image du terminal montre la sortie d’un autre système équipé d’un AMD Ryzen, et non celle de l’exécution fournie.
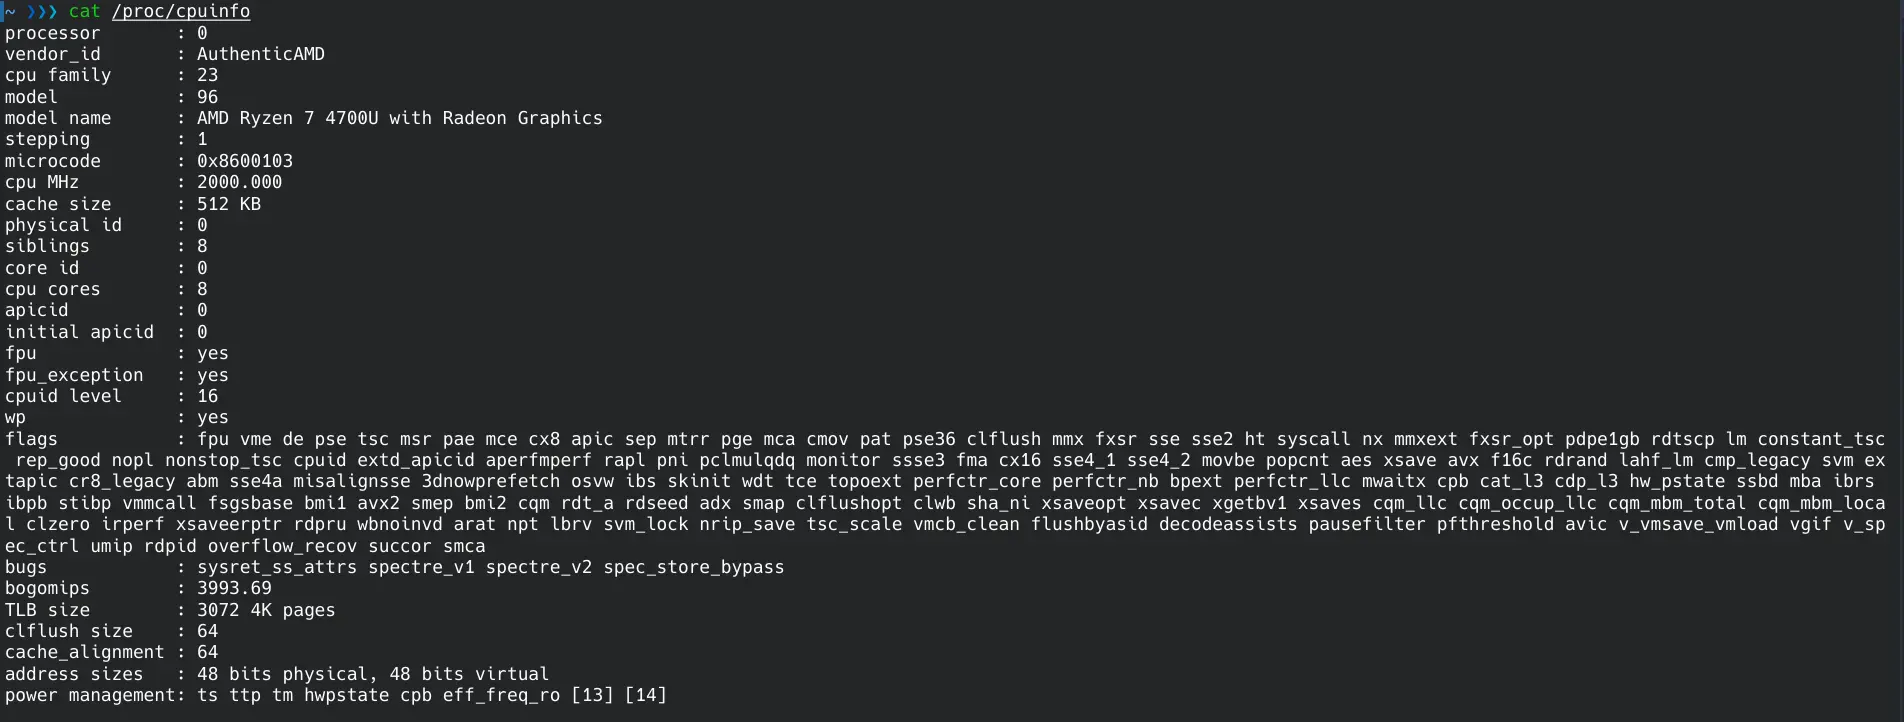
Repérer les champs de la sortie
Le fichier contient généralement un bloc de champs pour chaque processeur logique. processor désigne une entrée de processeur logique ; ce n’est pas le nombre de cœurs physiques. vendor_id et model name indiquent la famille et le modèle de processeur rapportés, tandis que cpu MHz est une fréquence signalée qui peut varier selon la gestion de l’alimentation. Des champs comme cache size, address sizes et cpu cores peuvent être présents, mais leur disponibilité et leur interprétation varient selon l’architecture et le noyau. Ne supposez pas que chaque ligne a la même signification sur toutes les machines.
Sur un système multicœur, la répétition de ces blocs est normale. Examinez les valeurs de processor pour voir les entrées logiques exposées par Linux, et considérez cpu cores comme une valeur rapportée par ce système. À eux seuls, ces champs ne décrivent pas de manière fiable le nombre de sockets ni toute la topologie physique.
Trouver et interpréter les indicateurs CPU
Dans une sortie x86, cherchez le champ flags ; sur certaines autres architectures, une liste similaire porte le nom Features. Pour trouver une liste représentative, vous pouvez rechercher dans le fichier avec grep -m1 -E '^(flags|Features)[[:space:]]*:' /proc/cpuinfo. Les noms qui suivent les deux-points sont des identifiants séparés par des espaces, et non des descriptions. Leur orthographe fait partie de l’interface du processeur et du noyau : conservez donc à l’identique des noms comme sse4_2, avx et lm lorsque vous consultez de la documentation ou comparez des systèmes.
Par exemple, lm désigne la prise en charge du mode long sur x86, et sse4_2 ainsi que avx désignent des extensions du jeu d’instructions. Un indicateur est un nom concis de capacité, pas une mesure de performance. Utilisez la liste exacte de la machine qui vous intéresse : un autre processeur, une machine virtuelle ou une autre architecture peut en afficher une différente. Les définitions des fonctionnalités CPU x86 du noyau Linux pour la version 4.1.3 peuvent aider à interpréter les noms dans cette version, mais elles ne constituent pas un catalogue exhaustif actuel.
Comprendre les limites de la sortie des indicateurs CPU
/proc/cpuinfo décrit les informations que Linux expose pour le système en cours d’exécution. Une machine virtuelle peut afficher un sous-ensemble filtré des capacités de l’hôte, et les noyaux peuvent exposer des noms propres à une architecture ou différer dans les champs qu’ils fournissent. La présence d’une fonctionnalité du jeu d’instructions ne prouve pas non plus qu’un programme donné l’utilise : le logiciel peut nécessiter la prise en charge du système d’exploitation, des options de compilation adaptées ou une détection des fonctionnalités à l’exécution.
Considérez les indicateurs comme des éléments attestant des capacités signalées, puis vérifiez le processeur, le noyau, la configuration de virtualisation et les exigences de l’application avant de vous fier à une fonctionnalité. À eux seuls, ils ne permettent pas de savoir à quelle vitesse une charge de travail s’exécutera, si le logiciel a choisi un chemin de code optimisé, ni si chaque processeur logique dispose du même ensemble de fonctionnalités utilisables.
