HOWTO · Pandas
Girar un DataFrame en Pandas
El método pivot() puede reorganizar un DataFrame dado utilizando los valores de índice y columna especificados. Esta función no permite la agregación de datos; varios valores forman un índice múltiple en las columnas. Podemos usar la columna para crear el índice para un nuevo marco.
En esta página
Este breve artículo discutirá cómo pivotar un DataFrame en Pandas.
Use la función pivot() para girar un marco de datos en Pandas
Un DataFrame dado se puede remodelar usando el método pivot() usando valores de índice y columna especificados. La función pivot() no admite la agregación de datos; varios valores producen un índice múltiple en las columnas.
Columna usada para crear el índice para un nuevo marco. La función pivote genera una nueva tabla derivada de una determinada; si es Ninguno, utiliza el índice existente.
Los tres argumentos que acepta el pivote son índice, columnas y valores. Se debe especificar un nombre de columna de la tabla original como valor para cada parámetro.
La función pivot() generará una nueva tabla con valores únicos para los parámetros especificados como sus índices de fila y columna. Los valores de celda de la nueva tabla provienen de la columna proporcionada como parámetro de valores.
Código de ejemplo:
from collections import OrderedDict
from pandas import DataFrame
import pandas as pd
import numpy as np

table = OrderedDict(
    (
        ("ID", ["ID1", "ID2", "ID3", "ID4"]),
        ("Std", ["Harry", "Ron", "Daniel", "Kelvin"]),
        ("Subject", ["Maths", "English", "Maths", "English"]),
        ("Marks", ["70", "50", "70", "50"]),
    )
)
d = DataFrame(table)
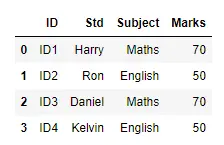
display(d)
Producción:
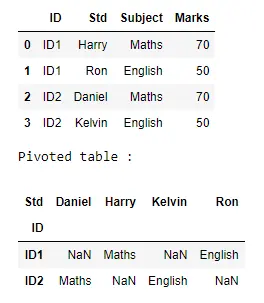
El siguiente ejemplo muestra el valor del sujeto para cada fila en la tabla original movida a la nueva tabla, donde su fila y columna corresponden a la ID y Std de su fila original. Los valores NaN se colocan en las celdas de la nueva tabla que no coinciden con ninguna entrada de la existente.
Código de ejemplo:
from collections import OrderedDict
from pandas import DataFrame
import pandas as pd
import numpy as np

table = OrderedDict(
    (
        ("ID", ["ID1", "ID1", "ID2", "ID2"]),
        ("Std", ["Harry", "Ron", "Daniel", "Kelvin"]),
        ("Subject", ["Maths", "English", "Maths", "English"]),
        ("Marks", ["70", "50", "70", "50"]),
    )
)
d = DataFrame(table)
display(d)
print("Pivoted table : ")
p = d.pivot(index="ID", columns="Std", values="Subject")
display(p)
Producción: