HOWTO · Python
Python Two-Sample T-Test
이 기사에서는 two-sample t-test가 무엇이며 Python을 사용하여 수행하는 방법에 대해 설명합니다. 주로 SciPy, Pingouin 및 Statsmodels를 사용하는 세 가지 방법에 대해 논의합니다. 각 방법의 개념을 이해하기 위해 시나리오를 예로 들었습니다.
이 페이지의 내용
전 세계 대부분의 프로그래머는 프로그래밍에 Python 언어를 사용합니다. Python은 인터프리터 및 고급 프로그래밍 언어로 널리 사용됩니다.
대부분의 프로그래머가 객체 지향 프로그래밍에서 Python을 사용하기 때문에 사람들은 웹 개발, 데이터 시각화, 인공 지능 및 기계 학습과 같은 분야, 백엔드 개발 및 스크립팅 언어로 Python을 사용합니다.
Python이 제공하는 기능 중 하나는 2-샘플 t-테스트를 수행할 수 있다는 것입니다. 이 글을 통해 two-sample t-test가 무엇인지, Python을 사용하여 어떻게 수행하는지에 대해 논의할 것입니다.
Python의 2-샘플 T-테스트
Two sample t-test는 두 데이터 그룹의 알려지지 않은 두 모집단 평균이 같은지 여부를 결정하기 위해 수행할 수 있는 테스트 유형입니다. 독립 표본 t 검정이라고도 합니다.
다른 데이터 그룹의 한 그룹에 대한 베어링이 없어야 합니다.
2-표본 t-검정을 수행하기 전에 데이터 그룹에 대한 세 가지 가정을 고려해야 합니다.
- 테스트에 사용하는 두 데이터 그룹은 독립적입니다.
- 동질성 가정: 여기서는 두 데이터 그룹의 분산이 같다고 가정합니다.
- 마지막 가정은 데이터 그룹의 데이터 분포가 다른지 여부입니다.
이러한 가정을 통해 2-표본 t-검정을 수행할 수 있습니다.
2-표본 t-검정 결과를 분석할 때 두 가지 가설을 세울 수 있습니다.
H0-dataGroup1 모집단 평균 = dataGroup2 모집단 평균. 귀무 가설이라고도 합니다.HA-dataGroup1 모집단 평균 != dataGroup2 모집단 평균.
이 테스트를 수행하는 세 가지 주요 방법이 있습니다.
scipy사용핑구인사용statsmodels사용
SciPy 라이브러리 사용
Scientific Python 라이브러리라고도 하는 SciPy는 과학 및 수학 문제를 해결하는 오픈 소스 Python 라이브러리입니다. SciPy 라이브러리에서 데이터를 조작하고 시각화하기 위해 여러 고급 Python 명령을 사용할 수 있습니다.
여러 하위 패키지가 SciPy 라이브러리 아래에 있습니다. 그들 중 일부는 다음과 같습니다.
scipy.stats- 통계 및 난수에 사용할 수 있습니다.scipy.io- 파일 입출력에 사용할 수 있습니다.scipy.linalg- 선형 대수 연산에 사용할 수 있습니다.scipy.signal- 신호 처리에 사용할 수 있습니다.
두 샘플 t-테스트를 수행하기 위해 이 SciPy 라이브러리를 사용할 수 있습니다.
2-표본 t-검정의 구문은 다음과 같습니다.
ttest_ind(dataGroup1, dataGroup2, equal_var=True / False)
여기서 ttest_ind는 테스트를 수행하는 scipy.stats 하위 패키지에서 제공하는 기능입니다. 그 안에는 우리가 생성하는 데이터 그룹인 dataGroup1 및 dataGroup2가 있습니다.
equal_var가 true이면 동일한 모집단 분산을 고려하여 두 표본 t-검정을 수행합니다. “거짓"이면 모집단 분산이 같지 않다는 Welch의 t-검정이 수행됩니다.
기본적으로 equal_var는 true입니다.
데이터 그룹 분산의 동일성 확인
테스트를 수행하기 전에 데이터 그룹의 분산이 동일한지 확인해야 합니다. 큰 데이터 그룹과 작은 데이터 그룹의 비율이 4:1 미만이면 두 데이터 그룹의 분산이 동일하다고 말할 수 있습니다.
이를 확인하기 위해 아래 구문을 사용할 수 있습니다.
np.var(dataGroup1), np.var(dataGroup2)
예제를 사용하여 t-테스트를 수행해 봅시다.
각 그룹에 특정 과목에 대한 10명의 학생 점수가 포함된 두 개의 샘플 데이터 그룹이 있다고 가정합니다. 우리는 두 그룹의 학생들이 과목에 대해 동일한 평균 점수를 가지고 있음을 명확히 할 필요가 있습니다.
첫 번째 단계로 pip 명령을 사용하여 SciPy 및 NumPy 라이브러리를 설치해야 합니다.
$ pip install scipy
$ pip install numpy
그런 다음 scipy.stats 하위 라이브러리와 NumPy를 환경으로 가져와야 합니다. 위에서 언급했듯이 scipy.stats는 테스트를 수행하는 데 도움이 되며 NumPy는 데이터 그룹을 만드는 데 도움이 됩니다.
다음과 같이 두 모듈을 가져올 수 있습니다.
import scipy.stats as stats
import numpy as np
그런 다음 다음과 같이 일부 데이터로 두 그룹을 만들 수 있습니다.
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])
첫째, 다음과 같이 데이터 그룹의 분산이 같은지 확인할 수 있습니다.
print(np.var(dataGroup1), np.var(dataGroup2))
코드를 실행하면 아래 이미지와 같은 출력이 표시됩니다.

보시다시피 비율은 10.809/8.49이며 4:1 미만입니다. 따라서 데이터 그룹의 분산이 같다고 말할 수 있습니다.
이제 테스트를 수행해 보겠습니다.
print(stats.ttest_ind(dataGroup1, dataGroup2, equal_var=True))
출력:

여기에서 얻은 p 값은 0.2889이며 알파 값인 0.05보다 큽니다. 따라서 우리는 두 그룹의 학생들의 평균 점수가 다르지 않다고 말할 수 있으며, 이것이 귀무 가설입니다(앞에서 언급한 두 가지 가설에 따름).
전체 코드:
# Importing the libraries
import scipy.stats as stats
import numpy as np

# Defining the data groups
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])

# Check the equality of the variances of the data groups
print(np.var(dataGroup1), np.var(dataGroup2))

# Executing the test
print(stats.ttest_ind(dataGroup1, dataGroup2, equal_var=True))
pingouin 라이브러리 사용
두 샘플 t-테스트를 수행할 수 있는 또 다른 방법은 pingouin 패키지를 사용하는 것입니다. 통계 기능이 있는 NumPy 및 pandas 기반의 오픈 소스 패키지입니다.
pingouin을 사용하려면 pip 명령을 사용하여 설치해야 합니다.
$ pip install pingouin
그런 다음 아래 구문을 사용하여 t-테스트를 수행할 수 있습니다.
ttest(dataGroup1, dataGroup2, correction=True / False)
여기서 ttest 기능은 pingouin 패키지에서 제공합니다. dataGroup1 및 dataGroup2는 테스트할 그룹입니다.
correction이 true인 경우 동질성 가정을 고려하여 테스트가 수행됩니다. 그것이 거짓이면 앞서와 같이 동질성 가정을 고려하지 않고 Welch의 t-검정을 수행합니다.
이전 예제를 사용하여 t-테스트를 수행해 보겠습니다. 먼저 NumPy 및 pingouin 패키지를 가져올 수 있습니다.
import pingouin as pg
import numpy as np
그런 다음 데이터 그룹을 정의합니다.
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])
이제 테스트를 할 수 있습니다.
print(pg.ttest(dataGroup1, dataGroup2, correction=True))
출력:
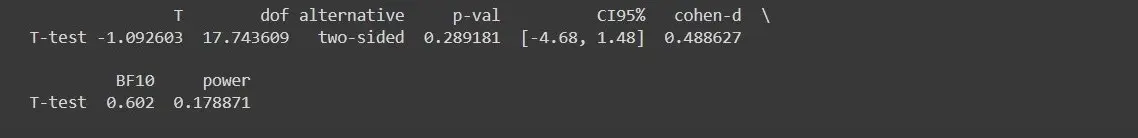
보시다시피 0.2891을 p-값으로 갖게 되며 0.05인 알파 값보다 큽니다. 두 그룹의 평균 점수가 통계적으로 차이가 없다고 판단합니다.
전체 코드:
# Importing the libraries
import pingouin as pg
import numpy as np

# Defining the data groups
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])

# Executing the test
print(pg.ttest(dataGroup1, dataGroup2, correction=True))
statsmodels 모듈 사용
Statsmodels는 SciPy, NumPy 및 Matplotlib를 기반으로 구축된 Python 모듈입니다. 사용자에게 통계 테스트 및 추정을 수행할 수 있는 기능과 클래스를 제공합니다.
statsmodels 모듈을 사용하여 두 샘플 t-테스트를 수행할 수도 있습니다. 이를 사용하려면 pip 명령을 사용하여 모듈을 설치해야 합니다.
$ pip install statsmodels
아래 구문을 사용하여 t-테스트를 수행할 수 있습니다.
ttest_ind(dataGroup1, dataGroup2)
ttest_ind는 테스트를 수행하는 데 사용하는 기능이고 dataGroup1과 dataGroup2는 테스트에 사용하는 그룹입니다.
이전 예제를 사용하여 테스트를 해보자.
먼저 statsmodels에서 ttest_ind 기능을 가져와야 합니다. 그런 다음 numpy 라이브러리를 가져올 수 있습니다.
from statsmodels.stats.weightstats import ttest_ind
import numpy as np
이제 앞에서 했던 것처럼 데이터 그룹을 정의할 수 있습니다.
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])
그런 다음 아래 테스트를 수행할 수 있습니다.
print(ttest_ind(dataGroup1, dataGroup2))
출력:

보시다시피 p-값으로 0.2889를 수신했으며 이는 알파 값보다 큽니다. 따라서 우리는 학생 그룹의 평균 점수가 다른 그룹과 통계적으로 다르지 않다고 말할 수 있습니다.
전체 코드:
# Importing libraries
from statsmodels.stats.weightstats import ttest_ind
import numpy as np

# Definig the data groups
dataGroup1 = np.array([17, 16, 14, 19, 20, 21, 15, 13, 14, 12])
dataGroup2 = np.array([19, 19, 14, 17, 22, 24, 16, 18, 15, 13])

# Executing the test
print(ttest_ind(dataGroup1, dataGroup2))
결론
이 글을 통해 Two-Sample t-Test가 무엇인지, Python에서 어떻게 하는지 알아보았습니다. 배운 것처럼 테스트를 수행하는 세 가지 주요 방법은 SciPy, pingouin 및 statsmodels를 사용하는 것입니다.
이 세 가지 방법은 테스트를 수행하기 위해 서로 다른 라이브러리와 기능이 필요합니다.
우리는 개념을 이해하기 위해 예를 들어 모든 방법에 적용했습니다. 그런 다음 가설과 가정을 사용하여 결과를 분석했습니다.